

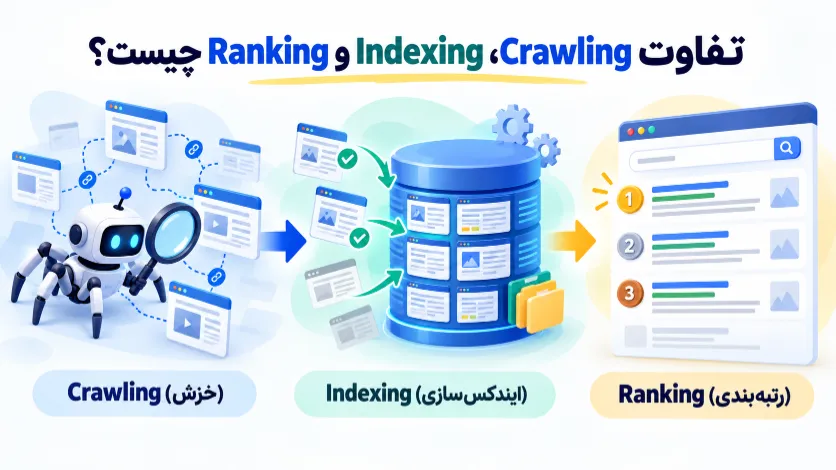
وقتی یک صفحه از سایت در گوگل دیده نمی شود، خیلی ها سریع نتیجه می گیرند که «صفحه رتبه نگرفته». اما همیشه مشکل Ranking نیست. ممکن است گوگل هنوز صفحه را Crawl نکرده باشد، ممکن است صفحه Crawl شده باشد اما وارد Index نشده باشد، یا ممکن است صفحه کاملاً Index شده باشد ولی برای عبارت موردنظر شما جایگاه مناسبی نداشته باشد.
تفاوت همین سه وضعیت، پایه بسیاری از عیب یابی های سئو است. اگر ندانیم مشکل در Crawling، Indexing یا Ranking اتفاق افتاده، ممکن است روی بخش اشتباهی وقت بگذاریم؛ مثلاً برای صفحه ای که اصلاً Index نشده بک لینک بسازیم، یا برای صفحه ای که از قبل Index شده مرتب Request Indexing بزنیم.
به زبان ساده، Crawling یا خزش مرحله ای است که Googlebot صفحه را پیدا و دریافت می کند. Indexing یا نمایه سازی مرحله ای است که گوگل محتوای صفحه را پردازش می کند و درباره نگهداری آن در Index تصمیم می گیرد. Ranking یا رتبه بندی هم زمانی مطرح می شود که کاربر چیزی را جستجو می کند و گوگل باید از میان صفحات موجود، نتایج مناسب تر را انتخاب و مرتب کند.
خود گوگل هم در مستندات رسمی اش نحوه کار Search را به سه مرحله اصلی Crawling، Indexing و Serving Search Results تقسیم می کند و صراحتاً می گوید همه صفحات الزاماً از تمام این مراحل عبور نمی کنند.
Crawling، Indexing و Ranking در یک نگاه
قبل از اینکه هرکدام را جداگانه بررسی کنیم، این جدول تفاوت اصلی آن ها را خلاصه می کند:
| مرحله | سؤال اصلی | چه اتفاقی می افتد؟ |
|---|---|---|
| Crawling | آیا Googlebot توانسته صفحه را پیدا و دریافت کند؟ | محتوای صفحه برای بررسی در اختیار گوگل قرار می گیرد |
| Indexing | آیا گوگل صفحه را پردازش و در Index نگهداری کرده؟ | صفحه امکان حضور عادی در Search را پیدا می کند |
| Ranking | صفحه برای یک Query چقدر مناسب است؟ | جایگاه صفحه نسبت به نتایج دیگر مشخص می شود |
این سه مرحله به هم وابسته اند، اما یکی نیستند. مهم ترین نکته ای که باید از همین ابتدا به خاطر بسپارید این است:
Crawl شدن به معنی Index شدن نیست و Index شدن هم به معنی رتبه خوب نیست.
قبل از Crawling، گوگل باید URL را پیدا کند
حتی قبل از خزش، یک مرحله مهم وجود دارد: Google باید از وجود URL باخبر شود. این مرحله معمولاً URL Discovery نامیده می شود.
گوگل فهرست مرکزی ای از تمام صفحات وب ندارد. بنابراین دائماً URLهای جدید و تغییرکرده را از مسیرهای مختلف پیدا می کند. ممکن است یک URL از طریق لینک داخلی، لینک خارجی، Sitemap یا صفحه ای که قبلاً شناخته شده کشف شود. گوگل در مستندات خود توضیح می دهد که بخشی از URLها از طریق لینک موجود در صفحات شناخته شده و بخشی دیگر از طریق Sitemap پیدا می شوند.
فرض کنید در وبتیک مقاله جدیدی منتشر می کنیم:
/تفاوت-خزش-ایندکس-رتبه-بندی/
اگر این URL در هیچ صفحه ای لینک نشده باشد و در Sitemap هم وجود نداشته باشد، ممکن است کشف آن برای Google سخت تر شود. صفحه از دید کاربر وجود دارد، ولی موتور جستجو هنوز باید راهی برای رسیدن به آن پیدا کند.
اینجا اهمیت Internal Linking مشخص می شود. لینک داخلی فقط برای انتقال اعتبار نیست؛ به Googlebot هم مسیر می دهد.
مثلاً این ساختار منطقی است:
سئو چیست ← موتور جستجو چیست ← Crawling ← Indexing ← Ranking
هم کاربر می تواند موضوع را مرحله به مرحله دنبال کند، هم رابطه صفحات برای موتور جستجو روشن تر می شود.
Crawling چیست؟
بعد از اینکه Google از وجود URL مطلع شد، ممکن است Googlebot به آن مراجعه کند و محتوای صفحه را دریافت کند. این فرایند Crawling یا خزش نام دارد.
وقتی Googlebot یک URL را Crawl می کند، مشابه یک مرورگر به Server درخواست می فرستد و پاسخ دریافت می کند. اگر صفحه سالم باشد، ممکن است پاسخ HTTP چیزی مثل 200 OK باشد و محتوای HTML در اختیار Google قرار بگیرد.
گوگل در مستندات خود توضیح می دهد که در مرحله Crawling، متن، تصاویر و ویدئوهای صفحات را از طریق Crawlerها دریافت می کند. همچنین هنگام Crawl می تواند صفحه را Render کند و JavaScript آن را اجرا کند تا محتوایی را که وابسته به JavaScript است ببیند.
اما Crawl شدن به معنی تأیید کیفیت صفحه نیست. Googlebot ممکن است یک صفحه بسیار خوب را Crawl کند و در همان سایت یک URL کم ارزش یا Duplicate را هم بررسی کند. وظیفه این مرحله بیشتر پیدا کردن و دریافت محتواست، نه تصمیم نهایی درباره رتبه.
یک مثال ساده از Crawling
فرض کنید مقاله ای درباره «Canonical چیست» منتشر کرده اید و از مقاله «Indexing چیست» به آن لینک داده اید.
Googlebot هنگام Crawl مقاله Indexing لینک جدید را می بیند. URL را کشف می کند و در یکی از Crawlهای بعدی به آن مراجعه می کند. اگر دسترسی محدود نشده باشد و Server درست پاسخ دهد، محتوای صفحه دریافت می شود.
تا اینجا فقط می توانیم بگوییم:
Google صفحه را دیده است.
هنوز نمی توانیم بگوییم که صفحه Index شده یا برای Keyword موردنظر رتبه می گیرد.
چه چیزهایی می توانند مانع Crawling شوند؟
اگر Googlebot نتواند صفحه را به درستی دریافت کند، مشکل قبل از Indexing اتفاق افتاده است. در این حالت مواردی مثل خطاهای Server، مشکلات شبکه، محدودیت های robots.txt یا ساختار ضعیف سایت می توانند مطرح باشند. خود گوگل هم Server errors، مشکلات Network و قوانین robots.txt را از جمله دلایل رایج مشکل در Crawling معرفی می کند.
مثلاً تصور کنید یک مسیر مهم در فایل robots.txt بسته شده باشد:
User-agent: Googlebot
Disallow: /blog/
اگر مقالات سایت داخل /blog/ باشند، عملاً Googlebot اجازه خزش آن مسیر را ندارد.
در چنین شرایطی تغییر Title یا اضافه کردن Keyword مسئله اصلی را حل نمی کند. مشکل از دسترسی خزنده است.
Indexing چیست؟
بعد از Crawl شدن، گوگل تلاش می کند بفهمد صفحه درباره چیست. این مرحله Indexing نام دارد.
در Indexing فقط URL ذخیره نمی شود. Google متن، عنوان، تصاویر، ویدئوها و بخش های مختلف صفحه را تحلیل می کند و تلاش می کند موضوع و محتوای اصلی را تشخیص دهد. گوگل در مستندات رسمی خود توضیح می دهد که در این مرحله، عناصر مهمی مثل <title>، Alt تصاویر و محتوای صفحه بررسی می شوند.
در همین مرحله موضوع Duplicate و Canonical هم اهمیت پیدا می کند. اگر چند URL محتوای بسیار شبیه داشته باشند، Google می تواند آن ها را در یک Cluster قرار دهد و یک URL را به عنوان Canonical انتخاب کند.
پس Indexing فقط «ذخیره کردن صفحه» نیست؛ مرحله ای است که Google درباره هویت صفحه، موضوع آن و نسخه اصلی آن تصمیم می گیرد.
چرا Crawl شدن تضمین نمی کند صفحه Index شود؟
یکی از مهم ترین تفاوت های Crawling و Indexing همین است.
گوگل صراحتاً می گوید Indexing تضمین شده نیست و همه صفحاتی که پردازش می شوند الزاماً وارد Index نمی شوند.
این موضوع در سایت های بزرگ کاملاً قابل مشاهده است.
فرض کنید یک فروشگاه اینترنتی برای هر محصول ده ها URL تولید می کند:
?color=red
?color=blue
?sort=price
?utm_source=instagram
اگر این URLها تقریباً همان محتوای اصلی را نشان دهند، منطقی نیست همه آن ها به عنوان صفحات مستقل در Search نگهداری شوند.
یا ممکن است سایتی صدها صفحه بسیار مشابه با هدف گرفتن Keywordهای نزدیک تولید کند. Google می تواند بعضی از آن ها را Crawl کند اما ارزش مستقلی برای Index کردن همه آن ها نبیند.
Crawled – currently not indexed یعنی چه؟
یکی از رایج ترین وضعیت هایی که در Search Console دیده می شود:
Crawled – currently not indexed
یعنی Googlebot صفحه را Crawl کرده، اما Google فعلاً آن را وارد Index نکرده است.
این Status یک نکته مهم را به ما می گوید: صفحه قابل Crawl بوده و Google توانسته آن را دریافت کند. بنابراین مشکل اصلی دیگر «دسترسی Googlebot» نیست و باید یک مرحله جلوتر را بررسی کنیم.
ممکن است صفحه محتوای مشابه صفحات دیگر داشته باشد، Canonical به URL دیگری اشاره کند، محتوای مستقلی ارائه ندهد یا Google فعلاً ارزش کافی برای نگهداری آن در Index تشخیص نداده باشد.
در چنین شرایطی، اولین واکنش نباید این باشد که چند بار Request Indexing بزنیم. بهتر است خود صفحه را بررسی کنیم و ببینیم واقعاً چه ارزش مستقلی دارد.
Discovered – currently not indexed چه تفاوتی دارد؟
این وضعیت با مورد قبلی فرق می کند.
Discovered – currently not indexed یعنی Google URL را می شناسد اما هنوز آن را Crawl نکرده است.
در اینجا باید بیشتر به مسائلی مثل Internal Linking، کیفیت ساختار سایت، Sitemap، Crawl Demand و Server توجه کنیم.
فرق این دو Status در عیب یابی بسیار مهم است:
در حالت Discovered، Google هنوز صفحه را نخوانده است.
در حالت Crawled، Google صفحه را دیده اما Index نکرده است.
اگر این دو را یکی ببینیم، احتمالاً روی راه حل اشتباه تمرکز می کنیم.
Canonical چه نقشی در Indexing دارد؟
فرض کنید دو URL زیر وجود دارند:
example.com/product/
و:
example.com/product/?utm_source=instagram
محتوای هر دو عملاً یکسان است.
Google نیازی ندارد هر دو را به عنوان دو صفحه مستقل در Index نگه دارد. بنابراین ممکن است یکی را به عنوان Canonical انتخاب کند و URL دیگر را نسخه جایگزین در نظر بگیرد.
در چنین شرایطی اگر URL دوم در Search نمایش داده نشود، مشکل لزوماً Ranking نیست. ممکن است اصلاً Google URL دیگری را نسخه اصلی در نظر گرفته باشد.
این مثال اهمیت بررسی Google-selected Canonical در Search Console را نشان می دهد.
Ranking چیست؟
وقتی صفحه وارد Index شد، تازه نوبت Ranking یا رتبه بندی می رسد.
در این مرحله Google باید برای یک Query مشخص از میان صفحات موجود در Index، نتایجی را پیدا کند که مرتبط تر و مفیدتر باشند و بعد آن ها را مرتب کند.
گوگل توضیح می دهد که هنگام جستجوی کاربر، سیستم ها Index را برای پیدا کردن صفحات مناسب بررسی می کنند و عوامل زیادی می توانند روی مرتبط بودن نتیجه اثر بگذارند؛ از جمله زبان، موقعیت کاربر و Device.
بنابراین Ranking یک امتیاز ثابت برای هر URL نیست.
چرا یک صفحه می تواند برای چند Query رتبه های متفاوت داشته باشد؟
فرض کنید مقاله ای با عنوان «بهترین لپ تاپ برای برنامه نویسی» دارید.
همین URL ممکن است برای: «بهترین لپ تاپ برنامه نویسی» رتبه 4 داشته باشد.
برای «لپ تاپ مناسب پایتون» رتبه 8 بگیرد.
و برای «خرید لپ تاپ برنامه نویسی» اصلاً در صفحه اول نباشد.
چرا؟ چون Queryها یکسان نیستند و Search Intent یا نیت جستجو متفاوتی دارند.
در Query سوم ممکن است کاربر بیشتر دنبال صفحه فروشگاهی باشد تا مقاله آموزشی. بنابراین حتی اگر مقاله شما از نظر کیفیت عالی باشد، فرمت صفحه ممکن است با Intent اصلی Search هماهنگ نباشد.
به همین دلیل گفتن «این صفحه رتبه 5 دارد» بدون اشاره به Query چندان دقیق نیست.
Search Intent چرا در Ranking مهم است؟
فرض کنید کاربر جستجو می کند «بهترین گوشی سامسونگ» شما دو صفحه دارید.
صفحه اول یک Category Page است که محصولات، قیمت و دکمه خرید نشان می دهد.
صفحه دوم یک مقاله مقایسه ای است که مدل ها را از نظر دوربین، باتری، قیمت و کاربرد بررسی می کند.
اگر نتایج فعلی SERP عمدتاً مقاله های مقایسه ای باشند، احتمالاً Google این Query را بیشتر Informational یا Commercial Investigation تشخیص داده است.
در چنین شرایطی، اگر شما Category Page را برای همین Keyword هدف گرفته باشید، ممکن است مشکل اصلی نه Speed باشد، نه Backlink و نه تعداد کلمات؛ بلکه نوع صفحه با Intent درست هماهنگ نشده است.
این یکی از مهم ترین تفاوت های Ranking با Indexing است. صفحه ممکن است کاملاً Index شده باشد، اما Candidate خوبی برای Query موردنظر نباشد.
آیا Ranking فرمول مشخصی دارد؟
خیر، این برداشت قدیمی که مثلاً تعداد مشخصی Backlink، درصد خاصی Keyword Density و مقاله ای با تعداد کلمه مشخص شما را به رتبه یک می رساند، تصویر دقیقی از Ranking نیست.
گوگل در راهنمای Ranking Systems خود از سیستم ها و سیگنال های متعدد صحبت می کند و هیچ فرمول ساده و عمومی برای رتبه گرفتن ارائه نمی دهد.
حتی اهمیت بعضی سیگنال ها بسته به Query تغییر می کند.
برای مثال در جستجوی «قیمت دلار امروز» تازگی اطلاعات اهمیت زیادی دارد.
اما برای «فرمول مساحت دایره» Freshness اهمیت مشابهی ندارد.
در جستجوی «رستوران نزدیک من» Location بسیار مهم تر می شود.
پس Ranking را باید وابسته به Query ببینیم، نه یک امتیاز کلی برای سایت.
«برای آشنایی دقیق تر با این موضوع، مستندات گوگل درباره سیستم های Ranking توضیح می دهد که نتایج با استفاده از مجموعه ای از سیستم ها و سیگنال ها مرتب می شوند، نه یک فاکتور منفرد.»
یک مثال کامل از Crawl تا Rank
فرض کنید مقاله ای منتشر می کنیم با عنوان «راهنمای خرید لپ تاپ برای برنامه نویسی مقاله از صفحه دسته بندی و دو مقاله مرتبط Internal Link می گیرد.
در مرحله اول Googlebot یکی از این لینک ها را می بیند و URL جدید را کشف می کند. بعد صفحه را Crawl می کند و محتوای آن را دریافت می کند.
در مرحله بعد Google محتوای صفحه را تحلیل می کند، سئو Title و هدینگ ها را بررسی می کند، Canonical را می سنجد و اگر صفحه مناسب باشد آن را وارد Index می کند.
حالا کاربر جستجو می کند «بهترین لپ تاپ برای برنامه نویسی» Google از میان صفحات مرتبط در Index، نتایج را مرتب می کند و مقاله ما ممکن است Position 8 بگیرد.
کاربر دیگری جستجو می کند «لپ تاپ مناسب برنامه نویسی پایتون» همان صفحه ممکن است Position 3 باشد.
برای «خرید لپ تاپ برنامه نویسی» ممکن است Category Pageهای فروشگاهی بالاتر باشند.
این یک مثال کامل از تفاوت سه مرحله است:
صفحه یک بار Crawl شده، یک بار Index شده، اما Ranking آن برای هر Query می تواند متفاوت باشد.
چرا تشخیص مرحله مشکل مهم تر از خود مشکل است؟
فرض کنید سه صفحه داریم.
صفحه اول Crawl نشده است.
صفحه دوم Crawl شده اما Index نشده است.
صفحه سوم Index شده ولی Position 40 دارد.
اگر برای هر سه صفحه یک نسخه یکسان بپیچیم، مثلاً «محتوا را طولانی تر کن و بک لینک بگیر»، احتمالاً روی دو مورد از سه صفحه داریم وقت تلف می کنیم.
برای صفحه اول شاید مشکل در Discovery یا Crawlability باشد.
برای صفحه دوم باید Indexing، Canonical، Duplicate Content و کیفیت صفحه را بررسی کنیم.
برای صفحه سوم تازه باید وارد Ranking شویم و چیزهایی مثل Intent، رقابت، کیفیت، Authority و Link Profile را تحلیل کنیم.
SEO حرفه ای دقیقاً از همین جا شروع می شود: قبل از بهینه سازی، Diagnosis درست انجام دهیم.
یک مثال واقعی از اشتباه در تشخیص
فرض کنید صفحه خدمات سئو ساخته اید و بعد از چند هفته هیچ Impression ندارد.
اولین حدس ممکن است این باشد:
«احتمالاً Authority سایت پایین است.»
اما URL را در Search Console بررسی می کنید و می بینید:
Excluded by noindex tag
در این حالت اصلاً مشکل Ranking ندارید. صفحه وارد Index نشده چون خودتان noindex گذاشته اید.
اگر سه ماه برای همان لینک Backlink بسازید، مسئله اصلی سر جای خودش باقی می ماند.
مثال برعکس؛ وقتی صفحه Index شده ولی Ranking ضعیف است
فرض کنید URL زیر را دارید:
/خدمات-سئو/
در URL Inspection می بینید:
URL is on Google
Performance Report هم نشان می دهد صفحه Impression دارد، اما برای «خدمات سئو» Average Position حدود 42 است.
در این وضعیت Request Indexing کمکی به شما نمی کند، چون صفحه از قبل Index شده است.
باید بررسی کنید چرا برای این Query رقابتی، نتایج دیگر از دید Google مناسب تر هستند.
آیا Intent صفحه درست است؟
آیا رقبا Service Pageهای کامل تری دارند؟
آیا صفحه شما Trust کافی ایجاد می کند؟
نمونه کار دارید؟
روش همکاری را توضیح داده اید؟
Content فقط تبلیغاتی است یا واقعاً به سؤال های کاربر جواب می دهد؟
آیا Internal Linking کافی دارد؟
اینجا مسئله Ranking است، نه Indexing.
Sitemap بیشتر مربوط به کدام مرحله است؟
XML Sitemap بیشتر به Discovery و Crawling کمک می کند.
وجود URL در Sitemap به Google کمک می کند صفحه را پیدا کند، اما تضمین نمی کند آن را Index کند یا به آن رتبه بدهد.
یعنی این جمله اشتباه است:
«URL در Sitemap است، پس باید در گوگل باشد.»
Sitemap فقط یکی از ابزارهای معرفی URL به موتور جستجوست.
robots.txt روی کدام مرحله اثر می گذارد؟
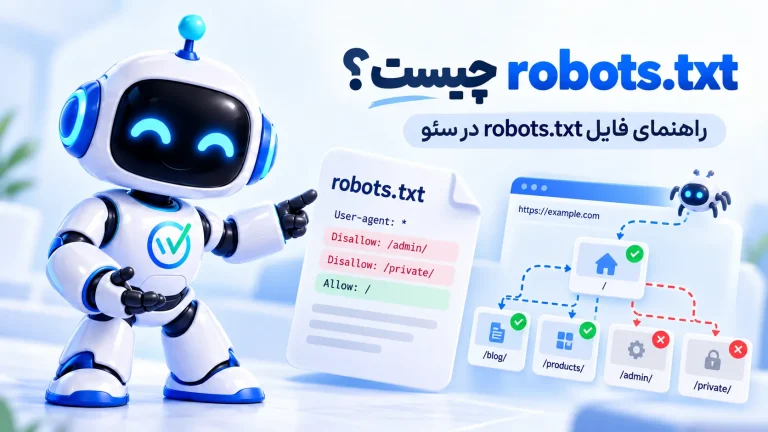
robots.txt عمدتاً روی Crawling اثر دارد.
با این فایل می توانید مسیرهایی را از دسترسی Crawlerها خارج کنید. اما robots.txt را نباید با noindex یکی بدانید.
به صورت ساده:
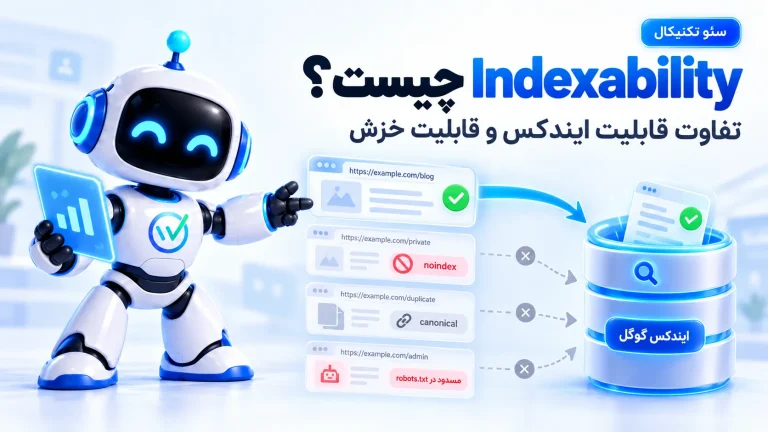
robots.txt بیشتر درباره این است که Googlebot صفحه را Crawl کند یا نه.
noindex درباره این است که صفحه در Index نگهداری شود یا نه.
این دو مفهوم از نظر فنی متفاوت اند و اشتباه گرفتن آن ها می تواند باعث مشکل جدی در Technical SEO شود.
Internal Linking فقط برای Ranking نیست
یکی از سوءبرداشت های رایج این است که لینک داخلی را فقط به عنوان ابزار «انتقال قدرت» ببینیم.
در حالی که Internal Linking در چند مرحله نقش دارد.
اول اینکه به Google کمک می کند URLهای جدید را پیدا کند.
دوم اینکه Context صفحه را روشن می کند.
سوم اینکه ساختار Topic را برای کاربر و موتور جستجو قابل فهم تر می کند.
و در نهایت می تواند روی اهمیت نسبی صفحات در ساختار سایت هم اثر بگذارد.
مثلاً اگر مقاله «Ranking چیست» از صفحه مادر «موتور جستجو چیست و چگونه کار میکند؟» لینک بگیرد، این لینک هم مسیر Crawl ایجاد می کند و هم رابطه موضوعی بین دو صفحه را روشن می کند.
کیفیت محتوا بیشتر به Indexing مربوط است یا Ranking؟
پاسخ کوتاه این است: هر دو.
Google در مستندات رسمی خود کیفیت پایین محتوا را یکی از دلایلی می داند که می تواند روی Indexing اثر بگذارد.
از طرف دیگر سیستم های Ranking هم برای پیدا کردن محتوای مفید و مرتبط طراحی شده اند.
اما کیفیت را نباید با «طول متن» اشتباه بگیریم.
فرض کنید مقاله A چهار هزار کلمه است، اما بخش بزرگی از آن پر از تعریف های تکراری و توضیحات عمومی است.
مقاله B دو هزار کلمه است، ولی مثال واقعی دارد، مشکل را دقیق توضیح می دهد، استثناها را بررسی می کند و به سؤال های اصلی کاربر پاسخ می دهد.
مقاله A طولانی تر است؛ اما الزاماً عمیق تر نیست.
Helpful Content چه ارتباطی با Ranking دارد؟
Helpful Content یک مرحله جداگانه بین Indexing و Ranking نیست.
بهتر است آن را بخشی از نگاه Google به کیفیت محتوا بدانیم.
Google در راهنمای رسمی خود می گوید سیستم های Ranking برای اولویت دادن به محتوای مفید، قابل اعتماد و ساخته شده برای مردم طراحی شده اند، نه محتوایی که هدف اصلی آن دست کاری Search Ranking باشد.
در همین راهنما مفهوم People-first Content مطرح می شود؛ یعنی محتوایی که اول برای مخاطب واقعی ایجاد شده باشد.
فرض کنید مقاله ای درباره Crawled – currently not indexed نوشته ایم. اگر فقط چند تعریف عمومی از سایت های دیگر جمع کنیم و همان ها را بازنویسی کنیم، ارزش خاصی ایجاد نکرده ایم.
اما اگر مقاله توضیح دهد چطور در Search Console وضعیت را تشخیص دهیم، تفاوت آن با Discovered را روشن کند، Canonical را بررسی کند، Example واقعی داشته باشد و بگوید چه مواقعی Request Indexing بی فایده است، برای کاربر ارزش بیشتری ایجاد می کند.
همین تفاوت، Helpful Content را از محتوای صرفاً Keyword-oriented جدا می کند.
E-E-A-T کجای این فرایند قرار می گیرد؟
E-E-A-T هم یک مرحله جدا نیست.
Experience، Expertise، Authoritativeness و Trustworthiness چارچوبی هستند که کمک می کنند کیفیت و اعتماد محتوا را بهتر بفهمیم. Google هم تأکید دارد که E-E-A-T یک Ranking Factor منفرد نیست.
مثلاً دو مقاله درباره Indexing را مقایسه کنید.
مقاله اول فقط می گوید:
«اگر صفحه Index نشد، محتوای باکیفیت بنویسید.»
مقاله دوم Screenshot واقعی Search Console دارد، توضیح می دهد Canonical اشتباه چه اثری داشته، چطور Internal Linking اصلاح شده و بعد از تغییرات چه اتفاقی افتاده است.
مقاله دوم Experience واقعی بیشتری نشان می دهد.
این نوع مثال ها و شواهد در یک سایت تخصصی می توانند ارزش زیادی ایجاد کنند.
Page Experience بیشتر به کدام مرحله مربوط است؟
Page Experience بیشتر در بحث Ranking مطرح می شود، هرچند بعضی مشکلات فنی شدید می توانند روی Crawl و Index هم اثر بگذارند.
Google توصیه می کند Page Experience را به یک Metric منفرد تقلیل ندهیم و به تجربه کلی صفحه نگاه کنیم. مواردی مثل Core Web Vitals، نمایش مناسب در موبایل، امنیت، تبلیغات مزاحم و Interstitialهای آزاردهنده می توانند بخشی از این تجربه باشند.
یعنی اگر PageSpeed شما 100 باشد، به این معنی نیست که صفحه حتماً باید رتبه بالایی داشته باشد.
اگر Content با Intent هماهنگ نباشد، سرعت عالی مشکل اصلی را حل نمی کند.
Search Console چطور کمک می کند بفهمیم مشکل کجاست؟
Search Console یکی از بهترین ابزارها برای جدا کردن این سه مسئله از یکدیگر است.
در URL Inspection می توانید ببینید صفحه Crawl شده یا نه، وضعیت Index چیست و Google چه Canonicalی انتخاب کرده است.
در Page Indexing Report می توانید وضعیت های مختلف Indexing را بررسی کنید.
و در Performance Report می توانید Query، Impression، Click، CTR و Average Position را ببینید.
یک صفحه ممکن است در URL Inspection کاملاً Index شده باشد، اما در Performance Report فقط برای چند Query کم اهمیت Impression بگیرد. این یعنی مشکل دیگر Indexing نیست؛ باید Ranking را بررسی کنید.
یک روش عملی برای عیب یابی
وقتی یک صفحه در Search عملکرد خوبی ندارد، بهتر است از ابتدا جلو بروید.
اول مطمئن شوید Google URL را می شناسد.
بعد بررسی کنید صفحه Crawl شده یا نه.
اگر Crawl شده، ببینید Index شده یا نه.
اگر Index شده، تازه وارد تحلیل Ranking شوید.
این ترتیب بسیار مهم است، چون هر مرحله سؤال متفاوتی دارد.
در Crawling می پرسیم:
آیا Googlebot به صفحه دسترسی دارد؟
در Indexing می پرسیم:
آیا Google صفحه را به عنوان یک URL مناسب برای Index پذیرفته؟
در Ranking می پرسیم:
چرا برای این Query، صفحات دیگر بالاتر از ما هستند؟
همین سه سؤال می توانند مسیر عیب یابی را کاملاً تغییر دهند.
آیا مسیر Crawl ← Index ← Rank همیشه خطی است؟
برای آموزش، این مدل ساده مفید است:
Discovery → Crawl → Index → Rank
اما در دنیای واقعی همه چیز کاملاً خطی نیست.
Googlebot می تواند یک صفحه را بارها Crawl کند. محتوای Index شده ممکن است تغییر کند. Canonical ممکن است عوض شود. Ranking هم دائماً جابه جا می شود.
مثلاً صفحه ای امروز Index می شود، هفته بعد فقط برای چند Long-tail Keyword Impression می گیرد و چند ماه بعد با تقویت محتوا و لینک داخلی برای Queryهای رقابتی تر هم دیده می شود.
پس بهتر است این فرایند را یک Cycle پویا ببینیم، نه یک مسیر یک باره.
Crawl شدن چه چیزی را ثابت نمی کند؟
Crawl شدن فقط نشان می دهد Googlebot توانسته صفحه را دریافت کند.
نشان نمی دهد صفحه باکیفیت است.
نشان نمی دهد Index می شود.
و قطعاً نشان نمی دهد رتبه خوبی خواهد گرفت.
Index شدن چه چیزی را ثابت نمی کند؟
Index شدن فقط نشان می دهد Google اطلاعات صفحه را در Index نگهداری کرده است.
نشان نمی دهد صفحه برای Keyword اصلی شما رتبه دارد.
حتی ممکن است صفحه برای Queryهایی Rank شود که اصلاً هدف اصلی شما نبوده اند.
Ranking خوب هم دائمی نیست
حتی اگر امروز رتبه 3 دارید، تضمینی نیست که همیشه همان جا بمانید.
رقبا محتوا را بهتر می کنند، SERP تغییر می کند، Search Intent می تواند تغییر کند و Google هم سیستم های Ranking خود را به روزرسانی می کند.
بنابراین SEO با «رتبه گرفتن» تمام نمی شود.
یک تشبیه ساده برای به خاطر سپردن تفاوت سه مرحله
فرض کنید Google یک کتابخانه بزرگ است.
در Crawling، کتابدار کتاب را پیدا می کند و می بیند چه چیزی داخل آن است.
در Indexing، اطلاعات کتاب ثبت می شود؛ موضوع، نویسنده و دسته بندی مشخص می شوند.
در Ranking، کاربر سؤال می پرسد:
«بهترین کتاب برای یادگیری سئو چیست؟»
حالا کتابدار باید از میان کتاب هایی که از قبل ثبت شده اند، مناسب ترین ها را انتخاب و مرتب کند.
این تشبیه تمام پیچیدگی Search را نشان نمی دهد، اما تفاوت سه مرحله را به خوبی روشن می کند.
جمع بندی
Crawling، Indexing و Ranking سه مرحله متفاوت در نحوه کار موتور جستجو هستند و شناخت تفاوت آن ها برای عیب یابی سئو ضروری است.
Crawling یعنی Googlebot صفحه را پیدا و دریافت کند.
Indexing یعنی Google محتوای صفحه را پردازش کند و درباره نگهداری آن در Index تصمیم بگیرد.
Ranking یعنی برای یک Query مشخص، از میان صفحات Index شده نتایج مناسب تر انتخاب و مرتب شوند.
اگر بخواهیم کل مقاله را در سه جمله خلاصه کنیم:
Crawl شدن تضمین نمی کند صفحه Index شود.
Index شدن تضمین نمی کند صفحه رتبه خوبی بگیرد.
Ranking هم یک عدد ثابت برای URL نیست و به Query بستگی دارد.
پس هر وقت صفحه ای در Google عملکرد مطلوبی ندارد، قبل از تغییر محتوا، ساخت بک لینک یا دست کاری عناصر صفحه، اول مشخص کنید مشکل در کدام مرحله اتفاق افتاده است. همین تشخیص ساده، جلوی بخش بزرگی از آزمون وخطای بی هدف در SEO را می گیرد.

اولین دیدگاه را بنویسید