

وقتی عبارتی را در گوگل جستجو می کنیم، معمولاً در چند لحظه با صفحه ای از نتایج روبه رو می شویم. این فرایند آن قدر سریع اتفاق می افتد که ممکن است تصور کنیم گوگل همان لحظه کل اینترنت را می گردد و بهترین پاسخ را پیدا می کند.
اما موتورهای جستجو معمولاً این طور کار نمی کنند.
موتور جستجو سیستمی است که صفحات و اطلاعات موجود در وب را پیدا، پردازش و سازمان دهی می کند و هنگام جستجوی کاربر، نتایجی را که مرتبط تر و مفیدتر تشخیص می دهد نمایش می دهد.
Google Search یکی از شناخته شده ترین نمونه هاست. گوگل برای پاسخ به یک جستجو، ابتدا باید از وجود صفحات وب مطلع شده باشد، بتواند آن ها را بررسی کند، اطلاعاتشان را در سیستم خود نگهداری کند و سپس هنگام جستجوی کاربر تصمیم بگیرد چه نتایجی را با چه ترتیبی نمایش دهد.
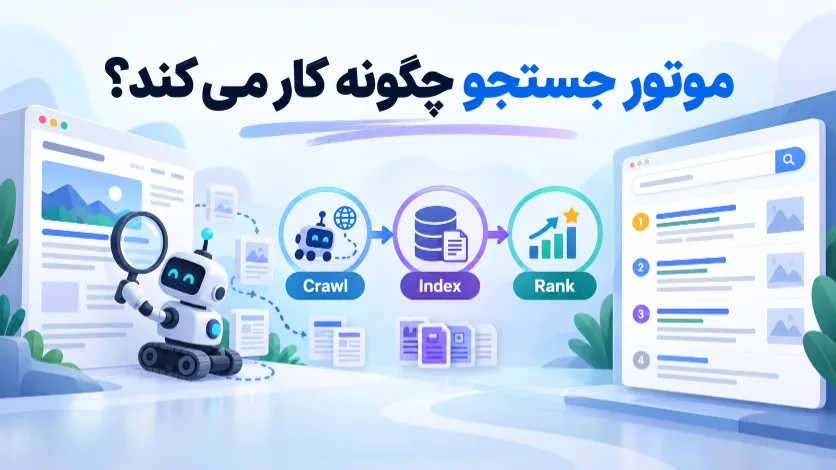
به زبان ساده، برای فهمیدن اینکه موتور جستجو چگونه کار می کند باید با سه مفهوم اصلی آشنا شویم:
- Crawling یا خزش
- Indexing یا ایندکس
- Ranking یا رتبه بندی
البته پشت هرکدام از این مراحل سیستم های بسیار پیچیده ای قرار دارند، اما اگر منطق همین سه مرحله را درست بفهمید، بخش بزرگی از مفاهیم پایه سئو برایتان روشن می شود.
موتور جستجو چیست؟
موتور جستجو یا Search Engine نرم افزار یا سیستمی است که به کاربران کمک می کند اطلاعات موردنیازشان را از میان حجم بزرگی از اطلاعات پیدا کنند.
وقتی کاربر عبارتی مانند: «بهترین روش افزایش سرعت وردپرس» را جستجو می کند، موتور جستجو تلاش می کند صفحاتی را پیدا کند که بیشترین ارتباط را با این نیاز داشته باشند و آن ها را به شکلی مرتب در اختیار کاربر قرار دهد.
گوگل، Bing و موتورهای جستجوی دیگری که صفحات وب را جستجو می کنند، نمونه هایی از Web Search Engine هستند.
اما وظیفه موتور جستجو فقط پیدا کردن صفحاتی نیست که دقیقاً همان کلمات جستجو شده را داخل خود دارند. یک موتور جستجوی مدرن تلاش می کند مواردی مثل این ها را هم درک کند:
- کاربر دقیقاً دنبال چه چیزی است؟
- موضوع اصلی هر صفحه چیست؟
- کدام صفحات اطلاعات مفیدتری ارائه می کنند؟
- کدام منابع قابل اعتمادترند؟
- آیا اطلاعات باید به روز باشند؟
- کاربر احتمالاً دنبال مقاله، محصول، تصویر، ویدئو یا یک کسب وکار محلی است؟
به همین دلیل مفهوم Search از یک تطبیق ساده کلمات بسیار فراتر رفته است.
چرا اصلاً به موتور جستجو نیاز داریم؟
وب ساختاری شبیه یک کتاب مرتب با فهرست ثابت ندارد.
هر روز صفحات جدیدی منتشر می شوند، صفحات قبلی تغییر می کنند، بعضی URLها حذف می شوند و لینک های جدیدی میان سایت ها شکل می گیرد.
اگر موتور جستجو وجود نداشت، برای پیدا کردن یک مقاله باید از قبل آدرس دقیق آن را می دانستیم یا از طریق لینک سایت دیگری به آن می رسیدیم.
موتور جستجو نقش یک سیستم کشف و بازیابی اطلاعات را دارد. این سیستم باید ابتدا صفحات را پیدا کند، درباره آن ها اطلاعات جمع کند و سپس زمانی که کاربر چیزی را جستجو می کند، از میان اطلاعات موجود مناسب ترین نتایج را انتخاب کند.
همین مسئله یکی از دلایلی است که شناخت نحوه کار موتور جستجو برای سئو اهمیت زیادی دارد.
اگر هنوز با مفهوم SEO آشنا نیستید، در مقاله سئو چیست نقطه شروع کامل تری برای این موضوع داریم.
گوگل همان لحظه کل اینترنت را جستجو نمی کند
یکی از مهم ترین نکاتی که در ابتدای یادگیری SEO باید بدانید همین است.
وقتی عبارت خاصی را در Google Search وارد می کنید، گوگل قرار نیست همان لحظه به میلیون ها سایت سر بزند و تمام صفحات اینترنت را از ابتدا بررسی کند.
در عوض، گوگل از قبل اطلاعات زیادی درباره صفحات وب جمع آوری و آن ها را در Search Index خود سازمان دهی کرده است.
سپس هنگام جستجوی کاربر، سیستم های رتبه بندی از میان اطلاعات موجود در این Index به دنبال نتایج مناسب می گردند.
گوگل توضیح می دهد که سیستم های رتبه بندی آن هنگام انجام جستجو از میان میلیاردها صفحه موجود در Search Index عبور می کنند تا اطلاعات مفید را ارائه دهند.
می توانیم با یک مثال بسیار ساده موضوع را تصور کنیم. فرض کنید وارد یک کتابخانه بزرگ می شوید.
اگر برای پیدا کردن هر موضوع مجبور باشید تمام کتاب های کتابخانه را یکی یکی ورق بزنید، رسیدن به پاسخ بسیار زمان بر خواهد بود.
اما اگر کتابخانه یک سیستم فهرست بندی دقیق داشته باشد، ابتدا موضوع موردنظر را در فهرست پیدا می کنید و بعد به کتاب ها یا منابع مرتبط می رسید.
Search Index دقیقاً همان فهرست ساده نیست، اما این مثال کمک می کند منطق کلی کار را بهتر تصور کنیم.
«اگر می خواهید این فرایند را از منبع رسمی و فنی تر دنبال کنید، مستندات گوگل درباره نحوه کار Google Search مراحل Crawling، Indexing و نمایش نتایج را توضیح داده است.»
موتور جستجو چگونه کار می کند؟
در یک مدل ساده می توان فرایند کار موتور جستجو را به چند مرحله تقسیم کرد:
- کشف URLها
- Crawling یا خزش
- پردازش و Indexing
- درک جستجوی کاربر
- Ranking و نمایش نتایج
در ادامه هر مرحله را بررسی می کنیم.
مرحله اول: موتور جستجو چگونه صفحات جدید را پیدا می کند؟
قبل از اینکه گوگل بتواند یک صفحه را بررسی کند، ابتدا باید از وجود آن مطلع شود.
هیچ فهرست مرکزی و کاملی وجود ندارد که هر صفحه جدید اینترنت به طور خودکار داخل آن ثبت شود. موتورهای جستجو باید URLهای جدید را کشف کنند.
یکی از مهم ترین راه های این کشف، لینک ها هستند.
فرض کنید وبتیک مقاله جدیدی درباره Search Intent منتشر کند و مقاله «سئو چیست» به آن لینک بدهد.
زمانی که خزنده موتور جستجو دوباره مقاله «سئو چیست» را بررسی کند، ممکن است لینک مقاله جدید را پیدا کند و URL آن را نیز برای بررسی در نظر بگیرد.
Google Search Central هم توضیح می دهد که صفحات جدید می توانند از طریق لینک صفحات شناخته شده کشف شوند و بخش بزرگی از URLها به همین شکل در جریان Crawl پیدا می شوند.
راه دیگر، XML Sitemap است.
Sitemap می تواند فهرستی از URLهای مهم سایت را در اختیار موتورهای جستجو قرار دهد و کشف صفحات را ساده تر کند.
اما Sitemap تضمین نمی کند که تمام URLهای موجود در آن حتماً Crawl یا Index شوند.
Crawling چیست؟
بعد از کشف URL، موتور جستجو ممکن است تصمیم بگیرد صفحه را Crawl کند.
Crawling یا خزش فرایندی است که طی آن نرم افزارهای خودکار موتور جستجو صفحات وب را درخواست و بررسی می کنند.
به این نرم افزارها معمولاً Crawler، Spider یا Bot گفته می شود.
خزنده اصلی Google Search را احتمالاً با نام Googlebot دیده اید.
گوگل Crawling را فرایند پیدا کردن صفحات جدید یا به روزشده برای اضافه شدن به سیستم خود توصیف می کند.
فرض کنید Googlebot به این URL برسد:
webtick.net/سئو-چیست/
سرور سایت صفحه را در اختیار خزنده قرار می دهد و گوگل می تواند محتوا و منابع آن را بررسی کند.
در همین صفحه ممکن است لینک هایی به صفحات دیگر وجود داشته باشد و این لینک ها مسیر کشف URLهای بیشتری را ایجاد کنند.
به همین دلیل لینک سازی داخلی فقط برای هدایت کاربر نیست؛ لینک های قابل Crawl در کشف و ارتباط میان صفحات نیز نقش دارند.
آیا گوگل همیشه هر URL را Crawl می کند؟
خیر، کشف یک URL الزاماً به معنی Crawl فوری آن نیست.
موتور جستجو باید منابع خود را مدیریت کند و عوامل مختلفی می توانند روی زمان و دفعات Crawl صفحات اثر بگذارند.
همچنین مالک سایت می تواند از ابزارهایی مانند robots.txt برای مدیریت دسترسی Crawlers به بخش هایی از سایت استفاده کند. گوگل نیز در مستندات Crawling خود توضیح می دهد که robots.txt می تواند برای اجازه دادن یا جلوگیری از Crawl برخی مسیرها استفاده شود.
جزئیات این مرحله را در مقاله مستقل Crawling چیست؟ آشنایی کامل با خزش گوگل بررسی کرده ایم.
Indexing چیست؟
Crawl شدن یک صفحه هنوز به این معنی نیست که آن صفحه حتماً در نتایج جستجو ظاهر خواهد شد.
بعد از دریافت صفحه، موتور جستجو باید محتوای آن را پردازش کند.
گوگل تلاش می کند موضوع صفحه، متن، تصاویر، عناصر اصلی، ارتباط صفحه با URLهای دیگر و اطلاعات موجود در آن را درک کند.
اگر صفحه برای Indexing مناسب باشد، اطلاعات آن ممکن است وارد Search Index شود.
به این مرحله Indexing می گوییم.
گوگل یک صفحه Indexed را صفحه ای توصیف می کند که توسط Googlebot بازدید و محتوای آن تحلیل و در Google Index ذخیره شده باشد. چنین صفحه ای در صورت رعایت شرایط لازم می تواند امکان حضور در نتایج Google Search را داشته باشد.
مثال ساده
فرض کنید امروز مقاله ای جدید منتشر می کنید.
وجود صفحه روی سایت فقط ثابت می کند URL منتشر شده است.
ممکن است:
- گوگل هنوز URL را کشف نکرده باشد؛
- URL را کشف کرده ولی هنوز Crawl نکرده باشد؛
- صفحه Crawl شده باشد ولی هنوز Index نشده باشد؛
- صفحه Index شده باشد ولی برای جستجوی موردنظر رتبه مناسبی نداشته باشد.
این مراحل را نباید با هم اشتباه گرفت.
به همین دلیل وقتی یک صفحه در نتایج گوگل دیده نمی شود، سؤال «چرا رتبه ندارم؟» همیشه سؤال اول درستی نیست.
اول باید بفهمیم:
آیا صفحه اصلاً Index شده است؟
این موضوع را در مقاله مستقل Indexing چیست؟ چرا صفحات سایت در گوگل ایندکس نمی شوند؟ با جزئیات بیشتری بررسی می کنیم.
موتور جستجو چگونه جستجوی کاربر را می فهمد؟
تا اینجا درباره سایت ها صحبت کردیم، اما طرف دیگر ماجرا کاربر است.
وقتی کسی چیزی جستجو می کند، موتور جستجو باید بفهمد منظور او چیست.
مثلاً این سه عبارت را ببینید:
- «آیفون 17»
- «بررسی آیفون 17»
- «خرید آیفون 17»
هر سه درباره یک محصول هستند، اما انتظار کاربران یکسان نیست.
در اولین جستجو Intent می تواند نسبتاً باز باشد.
در جستجوی دوم، کاربر احتمالاً به دنبال بررسی، مشخصات یا تجربه استفاده است.
در جستجوی سوم، نیت خرید بسیار واضح تر است.
موتور جستجوی مدرن فقط به وجود کلمات داخل صفحه نگاه نمی کند؛ باید ارتباط نتیجه با مفهوم جستجو را نیز تشخیص دهد.
گوگل توضیح می دهد که سیستم های Search برای ارائه نتایج عواملی مثل کلمات Query، ارتباط و کاربردپذیری صفحات، تخصص منابع و همچنین موقعیت و تنظیمات را در نظر می گیرند و اهمیت هر عامل بسته به نوع جستجو متفاوت است.
این موضوع همان چیزی است که در SEO با مفهوم Search Intent یا نیت جستجو ارتباط پیدا می کند.
Ranking چیست؟
حالا فرض کنید موتور جستجو صدها یا هزاران صفحه در Index دارد که تا حدی با Query کاربر مرتبط هستند.
کدام صفحه باید اول نمایش داده شود؟
اینجاست که وارد مرحله Ranking می شویم.
Ranking یعنی انتخاب و مرتب سازی نتایج برای یک جستجوی مشخص.
این مرحله بسیار پیچیده تر از آن است که بتوان آن را به یک فرمول ساده تبدیل کرد.
در اینترنت ممکن است با عباراتی مثل «۲۰۰ فاکتور قطعی رتبه بندی گوگل» یا «فرمول دقیق الگوریتم گوگل» روبه رو شوید، اما چنین مدل ساده ای تصویر دقیقی از سیستم های مدرن Search ارائه نمی دهد.
سیستم های گوگل می توانند بسته به نوع Query به سیگنال های مختلف وزن متفاوتی بدهند.
مثلاً Freshness یا تازگی اطلاعات در عبارت:
«نتیجه بازی امشب»
اهمیت زیادی دارد.
اما برای Query:
«مساحت دایره چگونه محاسبه می شود؟»
تازگی محتوا احتمالاً اهمیت مشابهی ندارد.
گوگل نیز صراحتاً توضیح می دهد که وزن عوامل رتبه بندی بر اساس ماهیت جستجو متفاوت است و Freshness برای موضوعات خبری اهمیت بیشتری نسبت به برخی موضوعات ثابت دارد.
جزئیات این بخش را در مقاله Ranking چیست؟ گوگل چگونه نتایج را رتبه بندی می کند؟ باز می کنیم.
Crawling، Indexing و Ranking چه تفاوتی دارند؟
این سه مفهوم یکی از رایج ترین نقاط سردرگمی افراد تازه کار هستند.
| مرحله | سؤال اصلی | مثال ساده |
|---|---|---|
| Crawling | آیا موتور جستجو صفحه را بررسی کرده است؟ | Googlebot صفحه مقاله را باز می کند |
| Indexing | آیا اطلاعات صفحه در Index موتور جستجو قرار گرفته است؟ | گوگل موضوع و محتوای مقاله را پردازش می کند |
| Ranking | صفحه برای یک Query در چه جایگاهی نمایش داده می شود؟ | مقاله برای «موتور جستجو چیست» در نتایج رقابت می کند |
پس:
Crawl شدن ≠ Index شدن ≠ رتبه گرفتن
ممکن است صفحه ای Crawl شود اما Index نشود.
ممکن است Index شود اما برای کلمات موردنظر شما رتبه خوبی نگیرد.
حتی ممکن است برای صدها Query مختلف رتبه های متفاوتی داشته باشد.
برای مقایسه عمیق تر این مراحل، مقاله مستقل تفاوت Crawling، Indexing و Ranking را خواهیم داشت.
آیا یک صفحه فقط یک رتبه در گوگل دارد؟
خیر، عبارت «رتبه یک صفحه» می تواند گمراه کننده باشد.
یک URL ممکن است برای تعداد زیادی Query متفاوت در نتایج ظاهر شود.
مثلاً همین مقاله ممکن است برای عبارت هایی مانند:
- موتور جستجو چیست
- موتور جستجو چگونه کار میکند
- نحوه کار گوگل
- Google Search چگونه کار میکند
- عملکرد موتور جستجو
در موقعیت های متفاوت دیده شود.
رتبه حتی می تواند بسته به جستجو، موقعیت جغرافیایی، زمان، دستگاه و شرایط دیگر متفاوت باشد.
بنابراین در تحلیل حرفه ای SEO معمولاً بهتر است عملکرد یک صفحه را فقط با یک Keyword و یک Position ارزیابی نکنیم.
موتور جستجو بر چه اساسی نتایج را مرتب می کند؟
فرمول دقیق سیستم های Ranking عمومی نیست و دائماً نیز تغییرات و بهبودهایی در Search ایجاد می شود.
اما می توان چند مفهوم کلی را در نظر گرفت.
ارتباط با جستجوی کاربر
صفحه باید با چیزی که کاربر دنبال آن است ارتباط داشته باشد.
وجود یک Keyword به تنهایی کافی نیست. موضوع، مفهوم و نوع محتوا باید با نیاز جستجو هماهنگ باشد.
کیفیت و مفید بودن محتوا
محتوا باید پاسخ مناسبی به نیاز کاربر ارائه دهد.
مقاله ای که صرفاً موضوعات سایت های دیگر را بازنویسی کرده، الزاماً ارزش بیشتری از منابع موجود ایجاد نمی کند.
اعتبار و اعتماد
در بعضی موضوعات، اعتبار منبع اهمیت ویژه ای پیدا می کند.
برای مثال اطلاعات پزشکی یا مالی حساسیت بیشتری نسبت به یک موضوع سرگرمی دارند.
لینک ها
لینک ها می توانند به کشف صفحات و همچنین درک ارتباط و اعتبار آن ها کمک کنند.
اما مفهوم لینک در موتورهای جستجوی مدرن بسیار پیچیده تر از «هرکس بک لینک بیشتری دارد برنده است» است.
تجربه استفاده از صفحه
یک صفحه باید برای کاربر قابل استفاده باشد.
گوگل توضیح می دهد که سیستم های اصلی Ranking به دنبال پاداش دادن به محتوایی هستند که تجربه کلی خوبی برای صفحه فراهم می کند و توصیه می کند صاحبان سایت فقط روی یک معیار منفرد متمرکز نشوند.
«برای جزئیات بیشتر، مستندات گوگل درباره Page Experience توضیح می دهد که تجربه صفحه مجموعه ای از عوامل است و امتیاز خوب Core Web Vitals به تنهایی تضمین کننده رتبه بالا نیست.»
تازگی، در صورت نیاز
همه Queryها به محتوای تازه احتیاج ندارند.
اما در موضوعاتی مثل اخبار، قیمت ها، قوانین، رویدادها یا اطلاعاتی که مرتب تغییر می کنند، تازگی می تواند بسیار مهم تر باشد.
آیا گوگل فقط دنبال کلمه کلیدی می گردد؟
خیر، این تصور بیشتر مربوط به نگاه بسیار ساده و قدیمی به موتورهای جستجو است.
فرض کنید کاربر بنویسد:
«کفش برای دویدن»
ممکن است یک نتیجه مناسب دقیقاً همین عبارت را داخل عنوان نداشته باشد و از واژه هایی مثل Running Shoes استفاده کرده باشد.
گوگل در راهنمای خود توضیح می دهد که نتایج بسیار مرتبط ممکن است لزوماً تمام کلمات دقیق Query را نداشته باشند و سیستم Search می تواند اصطلاحات مرتبط را نیز در نظر بگیرد.
به همین دلیل تکرار افراطی Keyword نه تنها لازم نیست، بلکه می تواند خوانایی متن را خراب کند.
هدف محتوا باید پوشش درست موضوع و پاسخ به نیاز کاربر باشد.
SERP چیست؟
بعد از انتخاب و مرتب سازی نتایج، موتور جستجو آن ها را در صفحه نتایج نمایش می دهد.
به این صفحه معمولاً SERP گفته می شود که مخفف Search Engine Results Page است.
SERP الزاماً فقط فهرستی از ده لینک آبی نیست.
بسته به Query ممکن است شامل موارد مختلفی باشد:
- نتایج ارگانیک
- تبلیغات
- تصاویر
- ویدئو
- نتایج محلی
- Featured Snippet
- Rich Results
- بخش های پرسش و پاسخ
- محصولات
- قابلیت های مبتنی بر هوش مصنوعی
به همین دلیل «حضور در Search» دیگر فقط به معنای گرفتن یک لینک آبی ساده نیست.
در مقاله SERP چیست؟ آشنایی با صفحه نتایج جستجوی گوگل ساختار صفحه نتایج را جداگانه بررسی می کنیم.
آیا انتشار یک صفحه برای دیده شدن در گوگل کافی است؟
خیر، یکی از اشتباهات متداول صاحبان سایت این است که تصور می کنند:
صفحه منتشر شده، پس باید در گوگل هم وجود داشته باشد.
انتشار صفحه تنها مرحله ای در سمت سایت شماست.
موتور جستجو هنوز باید بتواند URL را کشف و پردازش کند.
موارد مختلفی ممکن است جلوی دیده شدن یک URL را بگیرند:
- صفحه هنوز کشف نشده است؛
- دسترسی Crawlers مشکل دارد؛
- صفحه
noindexاست؛ - URL Canonical دیگری دارد؛
- مشکل فنی یا سروری وجود دارد؛
- محتوای صفحه ارزش کافی برای Index شدن ایجاد نکرده است؛
- صفحه بسیار مشابه URL دیگری است؛
- سایت یا صفحه ساختار لینک داخلی مناسبی ندارد.
البته وجود هرکدام از این موارد باید با بررسی واقعی مشخص شود و نباید صرفاً حدس زد.
لینک های داخلی چه نقشی در موتور جستجو دارند؟
لینک داخلی فقط ابزاری برای سئو کردن انکر تکست نیست.
لینک ها چند نقش مهم دارند.
اول اینکه به کاربر کمک می کنند بین محتواهای مرتبط حرکت کند.
دوم اینکه Crawlers می توانند از طریق لینک های قابل Crawl صفحات دیگر را کشف کنند.
سوم اینکه ساختار لینک ها به موتور جستجو کمک می کند ارتباط بخش های مختلف سایت را بهتر بفهمد.
به همین دلیل سایتی که صدها صفحه دارد اما هیچ ساختار ارتباطی منطقی بین آن ها وجود ندارد، معمولاً مدیریت سخت تری خواهد داشت.
مثلاً در وبتیک صفحه:
موتور جستجو چیست؟
طبیعتاً باید به صفحات:
- Crawling چیست؟
- Indexing چیست؟
- Ranking چیست؟
- SERP چیست؟
لینک بدهد.
این صفحات نیز باید به مقاله مادر خودشان و در سطح بالاتر به مقاله سئو چیست متصل شوند.
به این ترتیب یک ساختار موضوعی واقعی ایجاد می شود، نه مجموعه ای از مقالات جدا و پراکنده.
Sitemap چه کمکی می کند؟
XML Sitemap فایلی است که می تواند URLهای مهم سایت را در اختیار موتورهای جستجو قرار دهد.
Sitemap مخصوصاً در سایت هایی که URLهای زیادی دارند یا ساختار پیچیده تری دارند می تواند به کشف صفحات کمک کند.
اما باید یک سوءبرداشت را کنار بگذاریم:
قرار دادن URL در Sitemap تضمین Index شدن آن نیست.
Sitemap بیشتر یک سیگنال برای معرفی و کشف URLهاست.
کیفیت صفحه، دسترسی فنی، Canonicalization و عوامل دیگر همچنان اهمیت دارند.
robots.txt چه کاری انجام می دهد؟
فایل robots.txt یکی از ابزارهای مدیریت Crawl است.
با استفاده از آن می توان مشخص کرد Crawlers مشخصی اجازه دسترسی به بعضی مسیرهای سایت را داشته باشند یا نداشته باشند.
اما robots.txt را نباید با دستور noindex یکی دانست.
این دو ابزار هدف یکسانی ندارند.
یکی از خطاهای فنی رایج این است که مدیر سایت بدون درک تفاوت Crawl و Index، تنظیماتی انجام می دهد که نتیجه مورد انتظارش را ایجاد نمی کند.
این موارد را در خوشه سئو تکنیکال با جزئیات بیشتری بررسی می کنیم.
موتور جستجو و سئو چه ارتباطی دارند؟
اگر سئو را بدون درک Search Engine یاد بگیریم، بسیاری از کارها تبدیل به مجموعه ای از دستورهای حفظی می شوند.
مثلاً کسی می گوید:
- Sitemap بساز.
- لینک داخلی بده.
- Canonical قرار بده.
- محتوا بنویس.
- بک لینک بگیر.
اما تا وقتی ندانیم موتور جستجو چه مسئله ای را حل می کند، نمی دانیم چرا این کارها اهمیت دارند یا چه زمانی اصلاً لازم نیستند.
وقتی منطق موتور جستجو را درک کنیم، بسیاری از مفاهیم SEO منطقی می شوند.
مثلاً:
چرا Internal Link اهمیت دارد؟
چون هم کاربر و هم Crawler باید بتوانند بین صفحات مرتبط حرکت کنند.
چرا Search Intent اهمیت دارد؟
چون موتور جستجو می خواهد نتیجه ای ارائه دهد که نیاز واقعی کاربر را پاسخ دهد.
چرا Technical SEO مهم است؟
چون اگر موتور جستجو نتواند به صفحه دسترسی مناسب داشته باشد یا آن را پردازش کند، محتوای خوب به تنهایی کافی نیست.
چرا محتوای باکیفیت مهم است؟
چون هدف Search نمایش اطلاعات مفید به کاربران است، نه صرفاً صفحاتی که بیشترین تعداد Keyword را دارند.
Search Console در این فرایند چه کمکی می کند؟
Google Search Console یکی از مهم ترین ابزارهایی است که صاحب سایت می تواند برای مشاهده بخشی از رابطه سایت خود با Google Search استفاده کند.
با Search Console می توان اطلاعاتی درباره مواردی مثل:
- Queryهایی که سایت برای آن ها دیده شده؛
- Click و Impression؛
- بعضی وضعیت های Indexing؛
- URLهای سایت؛
- Sitemap؛
- Core Web Vitals؛
- برخی مشکلات مرتبط با Search
را بررسی کرد.
Search Console تمام جزئیات داخلی سیستم گوگل را نشان نمی دهد، اما یکی از مهم ترین منابع برای تحلیل وضعیت واقعی یک سایت در Google Search است.
بعداً یک راهنمای کامل برای Google Search Console خواهیم داشت.
چند تصور اشتباه درباره نحوه کار گوگل
«اگر صفحه را منتشر کنم همان لحظه در گوگل می آید»
لزومی ندارد، کشف، Crawl و Indexing می توانند در زمان متفاوتی اتفاق بیفتند.
«اگر صفحه Index شد، یعنی باید رتبه خوبی بگیرد»
خیر، Index شدن فقط یعنی صفحه امکان حضور در Search را پیدا کرده است. Ranking مرحله دیگری است.
«هرچه کلمه کلیدی را بیشتر تکرار کنم، گوگل بهتر موضوع را می فهمد»
خیر، محتوا باید طبیعی، دقیق و موضوع محور باشد.
«هرچه بک لینک بیشتری داشته باشم، رتبه بالاتری می گیرم»
تعداد خام لینک یک فرمول ساده برای Ranking نیست. کیفیت، ارتباط و ماهیت لینک ها اهمیت زیادی دارند.
«سرعت 100 در PageSpeed یعنی رتبه یک»
خیر، تجربه صفحه بخشی از تصویر بزرگ تر است و هیچ امتیاز منفردی تضمین کننده Ranking نیست. گوگل نیز توصیه می کند Page Experience را به یکی دو معیار محدود نکنیم.
«گوگل همیشه برای همه یک نتیجه یکسان نشان می دهد»
نه الزاماً، عواملی مانند موقعیت جغرافیایی، تنظیمات و نوع Query می توانند روی نتایج تأثیر داشته باشند.
برای کمک به موتور جستجو چه کارهایی می توانیم انجام دهیم؟
هدف SEO این نیست که موتور جستجو را فریب دهیم.
کار اصلی این است که موانع را کم کنیم و اطلاعات را واضح تر ارائه دهیم.
برای یک سایت معمولاً باید به این موارد توجه شود:
- ساختار سایت منطقی باشد؛
- صفحات مهم لینک داخلی داشته باشند؛
- Crawlers به محتوای لازم دسترسی داشته باشند؛
- URLهای مهم قابل Index باشند؛
- محتوای هر صفحه هدف مشخصی داشته باشد؛
- Search Intent در تولید محتوا در نظر گرفته شود؛
- صفحات تکراری و کم ارزش بی دلیل ایجاد نشوند؛
- سایت در موبایل قابل استفاده باشد؛
- سرعت و تجربه استفاده مناسب باشد؛
- عنوان و ساختار محتوا واضح باشد؛
- اطلاعات مهم به روز و قابل اعتماد باشند.
این مجموعه همان جایی است که بهینه سازی سایت برای موتورهای جستجو یا SEO وارد ماجرا می شود.
جمع بندی
موتور جستجو سیستمی است که اطلاعات موجود در وب را کشف، پردازش و سازمان دهی می کند و هنگام جستجوی کاربر تلاش می کند نتایج مناسب را پیدا و مرتب کند.
برای درک ساده Google Search می توان فرایند را این طور تصور کرد:
Discovery → Crawling → Indexing → Understanding Query → Ranking → Search Results
اما نکته مهم این است که این مراحل مستقل از یکدیگرند.
منتشر شدن صفحه به معنی Crawl شدن نیست.
Crawl شدن به معنی Index شدن نیست.
Index شدن هم تضمین نمی کند صفحه برای هر Query رتبه بالایی بگیرد.
اگر این تفاوت را به درستی درک کنید، بسیاری از مفاهیم بعدی SEO بسیار ساده تر می شوند.
قدم منطقی بعدی این است که وارد اولین مرحله اصلی این فرایند شویم و دقیق تر ببینیم Crawling چیست و Googlebot چگونه صفحات وب را پیدا و بررسی می کند.

اولین دیدگاه را بنویسید