

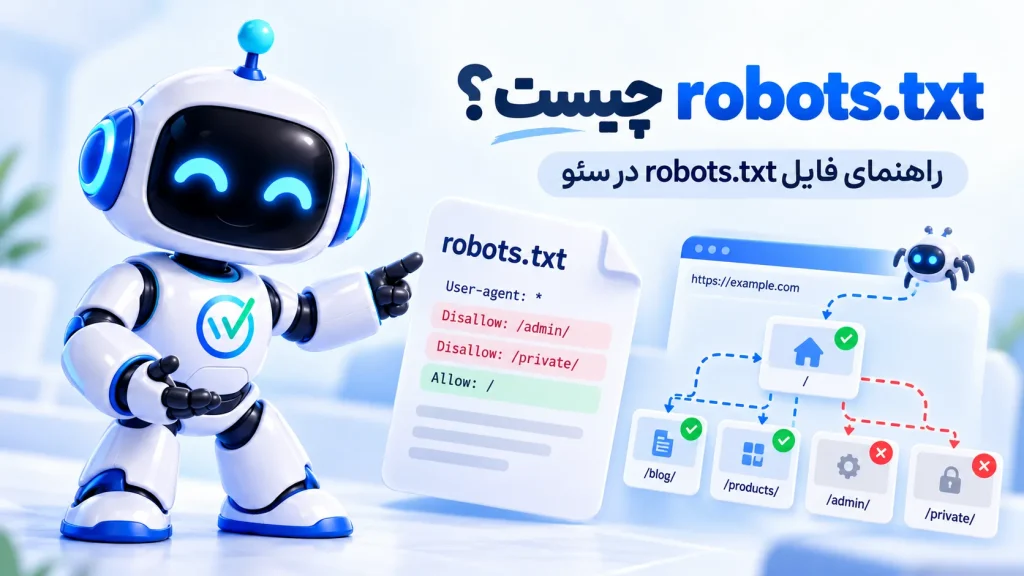
فایل robots.txt شاید فقط چند خط متن باشد، اما یک Rule اشتباه داخل همین فایل می تواند دسترسی Googlebot به صدها یا هزاران URL را تغییر دهد.
مثلا ممکن است یک سایت بعد از انتقال از محیط آزمایشی به نسخه اصلی همچنان این دستور را داشته باشد:
User-agent: *
Disallow: /
و عملا Crawl کل سایت را برای Crawlerهای مشمول Rule محدود کند.
در طرف مقابل، بعضی سایت ها هیچ کنترلی روی URLهای فیلتر، پارامترها و مسیرهای کم ارزش ندارند و Crawler می تواند زمان زیادی را صرف URLهایی کند که هیچ نقش واقعی در Search ندارند.
robots.txt ابزاری برای مدیریت دسترسی Crawlerها به URLهای سایت است.
اما قبل از هر چیز باید یک تفاوت بنیادی را بدانیم:
robots.txt برای مدیریت Crawling است، نه برای دستور مستقیم به Google جهت حذف یک صفحه از Index.
اگر هنوز تفاوت مراحل کشف، خزش، ایندکس و رتبه بندی برایتان کاملا روشن نیست، مطالعه راهنمای تفاوت خزش، ایندکس و رتبه بندی قبل از ادامه این مقاله کمک می کند نقش robots.txt را دقیق تر درک کنید.
در ادامه یاد می گیریم robots.txt چیست، Google چگونه آن را می خواند، Allow و Disallow چگونه کار می کنند، Wildcard چیست، چه مسیرهایی را نباید بی دلیل Block کنیم و چگونه این فایل را بدون آسیب زدن به سئو بررسی کنیم.
robots.txt چیست؟
robots.txt یک فایل متنی است که در ریشه Host قرار می گیرد و به Crawlerهای سازگار اعلام می کند اجازه دارند کدام مسیرهای سایت را Crawl کنند و از Crawl کدام مسیرها خودداری کنند.
برای مثال:
User-agent: *
Disallow: /private/
به Crawlerهایی که Rule عمومی را دنبال می کنند می گوید URLهای زیر مسیر /private/ را Crawl نکنند.
برای فهم جایگاه این فایل باید بدانیم موتور جستجو قبل از Index کردن محتوا ابتدا باید URL را پیدا کند و در بسیاری از موارد آن را Crawl کند. اگر می خواهید تصویر کلی این فرایند را ببینید، مقاله موتور جستجو چگونه کار می کند؟ نقطه شروع مناسبی است.
robots.txt چه نقشی در خزش Google دارد؟
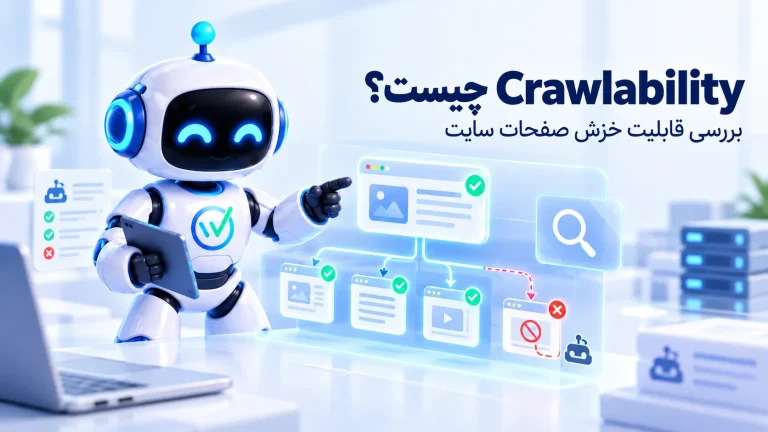
Googlebot هنگام Crawl یک سایت باید بداند آیا برای درخواست یک URL اجازه دارد یا نه. robots.txt یکی از منابعی است که این محدودیت را مشخص می کند.
بنابراین این فایل مستقیما با فرایند خزش Google در ارتباط است.
به زبان ساده:
URL کشف می شود ← robots.txt بررسی می شود ← در صورت مجاز بودن، Crawl انجام می شود
البته این یک مدل ساده شده است، اما برای فهم نقش robots.txt کافی است.
اگر Rule فایل اجازه Crawl یک مسیر را ندهد، Googlebot معمولا محتوای URLهای Match شده با آن Rule را درخواست نمی کند.
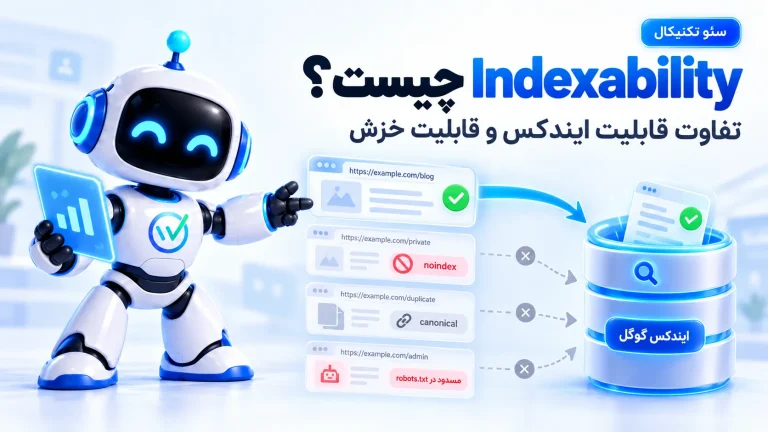
robots.txt ابزار Noindex نیست
یکی از رایج ترین اشتباهات Technical SEO این است که برای حذف یک صفحه از Google آن را در robots.txt مسدود کنیم.
مثلا:
User-agent: *
Disallow: /old-page/
این Rule می گوید URL را Crawl نکن، نه اینکه URL نباید در Search حضور داشته باشد.
اگر Google از طریق لینک های داخلی، لینک خارجی یا منابع دیگر URL را بشناسد، ممکن است خود URL بدون Crawl شدن محتوا همچنان شناخته شود.
برای جلوگیری از Index شدن یک صفحه باید مسئله Indexing را مدیریت کنیم، نه فقط Crawling را. برای درک کامل این تفاوت، راهنمای ایندکس Google را ببینید.
robots.txt و noindex چه تفاوتی دارند؟
| robots.txt | noindex |
|---|---|
| دسترسی Crawler را مدیریت می کند | حضور صفحه در Index را مدیریت می کند |
| قبل از دریافت محتوای صفحه بررسی می شود | داخل HTML یا HTTP Header دیده می شود |
| می تواند Crawl را محدود کند | از نمایش صفحه در Search جلوگیری می کند |
| به تنهایی تضمین نمی کند URL از Search حذف شود | برای پردازش باید برای Crawler قابل مشاهده باشد |
فرض کنید این تگ روی صفحه وجود دارد:
<meta name="robots" content="noindex">
Googlebot باید بتواند صفحه را دریافت کند تا این دستور را ببیند.
اگر همان URL را در robots.txt هم مسدود کنید، ممکن است Googlebot نتواند اصلا به تگ noindex برسد.
پس این ترکیب معمولا منطقی نیست:
Disallow + noindex
اگر هدف شما Noindex کردن صفحه است، اجازه Crawl آن برای پردازش دستور اهمیت دارد.
آیا URL مسدود شده در robots.txt می تواند در Google دیده شود؟
بله.
فرض کنید URL زیر توسط robots.txt Block شده است:
/private-page/
اما چند سایت خارجی و چند صفحه داخلی به آن لینک داده اند.
Google می تواند از وجود URL باخبر باشد، حتی اگر اجازه Crawl محتوا را نداشته باشد.
در نتیجه نباید این رابطه را در ذهن داشته باشیم:
Blocked by robots.txt = حذف کامل از گوگل
این دو مفهوم یکسان نیستند.
robots.txt کجا قرار می گیرد؟
فایل باید با نام:
robots.txt
در Root همان Host قرار بگیرد.
مثلا برای دامنه اصلی:
https://example.com/robots.txt
فایلی که داخل یک Subdirectory قرار گرفته باشد robots.txt اصلی آن Host محسوب نمی شود:
https://example.com/blog/robots.txt
robots.txt برای Subdomainها چگونه کار می کند؟
Scope فایل به Host مربوط است.
مثلا:
example.com
و:
shop.example.com
Hostهای متفاوتی هستند.
اگر برای Subdomain فروشگاه Ruleهای Crawl جداگانه نیاز دارید، robots.txt همان Host باید تنظیم شود.
همین موضوع هنگام طراحی ساختار URL سایت نیز اهمیت دارد؛ چون Protocol، Host، Path و پارامترها می توانند رفتار URLها را تغییر دهند.
ساختار یک فایل robots.txt چگونه است؟
یک نمونه ساده:
User-agent: *
Disallow: /private/
Allow: /private/public-page/
Sitemap: https://example.com/sitemap.xml
چهار Directive مهمی که معمولا با آن ها سروکار داریم عبارتند از:
User-agentبرای مشخص کردن Crawler؛Disallowبرای محدود کردن Crawl یک Path؛Allowبرای تعریف استثنا؛Sitemapبرای معرفی Sitemap.
User-agent چیست؟
User-agent مشخص می کند Ruleهای بعدی مربوط به کدام Crawler هستند.
برای تمام Crawlerهای سازگار با گروه عمومی می توان نوشت:
User-agent: *
یا برای Googlebot:
User-agent: Googlebot
سپس Allow و Disallowهای مربوط به همان Group نوشته می شوند.
Disallow چیست؟
Directive Disallow مشخص می کند Crawler نباید URLهایی را که با Path مورد نظر Match می شوند Crawl کند.
مثلا:
User-agent: *
Disallow: /private/
این Rule مسیرهایی مثل:
/private/file/
و:
/private/page/
را شامل می شود.
Disallow خالی چه معنایی دارد؟
اگر مقدار Disallow خالی باشد:
User-agent: *
Disallow:
برای آن Group محدودیتی از طریق این Directive ایجاد نشده است.
در سایت هایی که تقریبا تمام صفحات عمومی باید Crawl شوند، ممکن است robots.txt بسیار ساده باشد.
Disallow: / چه کاری انجام می دهد؟
این Rule بسیار مهم است:
User-agent: *
Disallow: /
Slash ریشه سایت را Match می کند و در این Context باعث می شود تمام مسیرهای همان Host برای User-agent مربوطه مسدود شوند.
این اتفاق مخصوصا هنگام انتقال سایت از Staging به Production خطرناک است.
ممکن است نسخه آزمایشی عمدا برای Botها بسته شده باشد و بعد همان Rule روی سایت اصلی باقی بماند.
Allow در robots.txt چیست؟
Allow برای ایجاد استثنا داخل یک مسیر مسدودشده کاربرد دارد.
مثلا:
User-agent: Googlebot
Disallow: /folder/
Allow: /folder/public/
در این حالت بخش عمومی تر مسدود شده ولی مسیر مشخص تری اجازه Crawl دارد.
وقتی Allow و Disallow با هم تضاد دارند چه می شود؟
برای Google، Match خاص تر اهمیت دارد.
Ruleای که Path طولانی تر و مشخص تری با URL داشته باشد، نسبت به Rule عمومی تر اولویت پیدا می کند.
مثلا:
Disallow: /products/
Allow: /products/public/
URL:
/products/public/example/
با Rule مشخص تر Allow Match می شود.
به همین دلیل robots.txt را نباید فقط با نگاه کردن به ترتیب خطوط تحلیل کرد.
Wildcard در robots.txt چیست؟
علامت * برای Match کردن تعداد متغیری از کاراکترها استفاده می شود.
برای مثال:
Disallow: /*?sort=
می تواند URLهایی را که Pattern مورد نظر را دارند محدود کند.
Wildcardها مخصوصا برای URLهای پارامتردار کاربرد دارند، اما Rule بیش از حد عمومی ممکن است URLهای مهم را نیز درگیر کند.
قبل از نوشتن Rule برای پارامترها بهتر است ابتدا بفهمید URLهای سایت چگونه ساخته می شوند و کدام نسخه واقعا باید در Search حضور داشته باشد. راهنمای URL مناسب سئو برای فهم این بخش مفید است.
علامت $ در robots.txt چیست؟
علامت $ انتهای URL را مشخص می کند.
مثلا:
Disallow: /*.pdf$
الگو را به URLهایی محدود می کند که در همان نقطه با .pdf تمام شوند.
این تفاوت هنگام ساخت Ruleهای دقیق اهمیت دارد.
آیا robots.txt به حروف بزرگ و کوچک حساس است؟
نام Directiveها از نظر Google نسبت به حروف بزرگ و کوچک حساس نیست.
مثلا:
User-agent
و:
user-agent
به عنوان همان Field شناخته می شوند.
اما Path URL ممکن است Case-sensitive باشد.
بنابراین:
/Folder/
الزاما همان:
/folder/
نیست.
چگونه داخل robots.txt کامنت بنویسیم؟
برای توضیح Ruleها می توان از # استفاده کرد.
مثلا:
# Block internal search
User-agent: *
Disallow: /search/
هر چیزی بعد از # در همان خط به عنوان Comment در نظر گرفته می شود.
برای robots.txtهای بزرگ، Comment مناسب می تواند مدیریت فایل را ساده تر کند.
آیا crawl-delay برای Google کار می کند؟
خیر.
Google از Directive زیر در robots.txt پشتیبانی نمی کند:
Crawl-delay: 10
ممکن است بعضی Crawlerهای دیگر از چنین Directiveای استفاده کنند، اما برای کنترل Googlebot نباید روی آن حساب کرد.
آیا noindex داخل robots.txt معتبر است؟
خیر.
این ساختار برای Google روش پشتیبانی شده ای برای Noindex نیست:
Noindex: /example/
اگر هدف جلوگیری از حضور صفحه در Search است باید از مکانیزم های Indexing استفاده کنید، نه یک Directive اختراعی در robots.txt.
Sitemap در robots.txt چه کاربردی دارد؟
می توانید آدرس Sitemap سایت را داخل robots.txt اعلام کنید:
Sitemap: https://example.com/sitemap.xml
اگر چند Sitemap دارید، می توانید چند Directive جداگانه تعریف کنید.
وجود Sitemap به Google برای کشف URLها کمک می کند، اما یک نکته مهم وجود دارد:
Sitemap نمی تواند یک URL مسدود شده توسط robots.txt را ناگهان Crawlable کند.
اگر یک URL در Sitemap باشد ولی Rule فایل Crawl آن را مسدود کند، دو بخش سایت پیام های متفاوتی درباره همان URL می فرستند.
آیا Sitemap جای لینک داخلی را می گیرد؟
خیر.
قرار دادن یک URL داخل Sitemap به معنی این نیست که معماری داخلی سایت دیگر اهمیتی ندارد.
صفحات مهم بهتر است از مسیر منطقی سایت نیز قابل دسترسی باشند.
Google می تواند URLها را از لینک ها کشف کند و ساختار لینک های سایت در درک روابط صفحات نقش دارد.
آیا فایل های CSS و JavaScript را Block کنیم؟
معمولا نباید Resourceهایی را که برای Render صحیح صفحات مهم لازم هستند بی دلیل مسدود کنید.
Google برای مشاهده صفحه مشابه کاربر ممکن است به CSS و JavaScript آن نیاز داشته باشد.
اگر Resource اصلی Template را Block کنید، ممکن است Google نسخه ناقصی از صفحه را Render کند.
پس Ruleهایی مثل:
Disallow: /assets/
را بدون بررسی محتوای واقعی آن Directory اضافه نکنید.
آیا مسیر wp-content را در WordPress مسدود کنیم؟
به صورت کلی، Block کردن کامل /wp-content/ تصمیم مناسبی نیست.
این مسیر می تواند شامل مواردی مثل:
CSS، JavaScript، تصاویر، فایل های قالب، فایل های افزونه و فونت ها باشد.
بعضی از این Resourceها برای Render صحیح صفحات لازم هستند.
اگر فقط به دلیل اینکه نام Directory مربوط به WordPress است آن را Block کنید، ممکن است Googlebot را از Resourceهای مفید محروم کنید.
آیا تصاویر را می توان با robots.txt مسدود کرد؟
بله.
برای مثال می توان مسیر مشخصی از تصاویر را برای Crawler محدود کرد.
اما اگر آن تصاویر باید در Google Images حضور داشته باشند یا برای درک صفحه اهمیت دارند، این تصمیم باید آگاهانه باشد.
برای بهینه سازی خود تصاویر، Alt، حجم، Lazy Loading و نحوه دسترسی Google به فایل ها، راهنمای سئو تصاویر را مطالعه کنید.
robots.txt ابزار امنیتی نیست
مسیرهای فایل robots.txt عمومی هستند.
اگر بنویسید:
Disallow: /secret-files/
هر کاربری که robots.txt را باز کند می تواند نام این مسیر را ببیند.
اگر محتوا واقعا خصوصی است، باید از Authentication و Permission واقعی سمت Server استفاده شود.
robots.txt فقط یک درخواست Crawl برای Crawlerهای سازگار است، نه دیوار امنیتی.
آیا صفحه Login را با robots.txt مسدود کنیم؟
ممکن است Crawl بعضی مسیرهای مدیریتی نیازی نداشته باشد، اما نباید robots.txt را جای سیستم امنیتی در نظر بگیریم.
برای مثال WordPress باید از طریق سیستم احراز هویت خودش از بخش مدیریت محافظت کند، نه فقط:
Disallow: /wp-admin/
این Rule صرفا مسئله Crawling را مدیریت می کند.
نمونه robots.txt ساده برای WordPress
یک نمونه رایج و ساده می تواند چنین باشد:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/sitemap.xml
اما این یک Template عمومی است، نه نسخه ای که باید بدون بررسی Copy کنید.
ساختار سایت، افزونه ها، فروشگاه، پارامترها و URLهای هر پروژه متفاوت هستند.
آیا باید robots.txt سایت های دیگر را کپی کنیم؟
خیر.
دو سایت WordPress ممکن است ظاهر مشابهی داشته باشند ولی معماری URL آن ها کاملا متفاوت باشد.
یک Rule مفید برای فروشگاهی با هزاران Facet ممکن است روی یک سایت محتوایی کاملا غیرضروری باشد.
حتی ممکن است Pathی که در سایت دیگری کم ارزش است، در سایت شما شامل Landing Pageهای اصلی باشد.
URLهای فیلتر و پارامتر را با robots.txt مسدود کنیم؟
گاهی می تواند بخشی از راه حل باشد، اما نه بدون تحلیل.
فرض کنید فروشگاه این URLها را تولید می کند:
?color=blue
?size=large
?sort=price
?brand=x
ترکیب آن ها ممکن است تعداد بسیار زیادی URL بسازد.
اما قبل از Block کردن باید بدانیم آیا بعضی فیلترها Search Demand دارند و قرار است صفحات مستقل باشند یا نه.
اگر تمام Pattern را کورکورانه مسدود کنید، شاید Landing Pageهایی را هم از Crawl خارج کنید که واقعا برای Search ارزش دارند.
robots.txt و Crawl Budget چه ارتباطی دارند؟
محدود کردن Crawl مسیرهای واقعا غیرضروری می تواند در سایت های بسیار بزرگ به مدیریت Crawl کمک کند.
اما برای یک سایت کوچک یا متوسط، پیچیده کردن robots.txt به بهانه Crawl Budget معمولا اولین اولویت نیست.
در این سایت ها مواردی مثل:
ساختار URL سالم، لینک داخلی منطقی، جلوگیری از URLهای بی نهایت و پاسخ درست Server معمولا مسائل مهم تری هستند.
آیا لینک داخلی به URL مسدود شده اشتباه است؟
بستگی به هدف صفحه دارد.
اگر صفحه مهمی باید توسط Google Crawl و پردازش شود ولی لینک های داخلی به URLی اشاره می کنند که robots.txt آن را مسدود کرده است، ساختار نیاز به بررسی دارد.
وجود لینک باعث می شود Google بتواند از وجود URL مطلع شود، اما Rule robots.txt می تواند مانع درخواست محتوای همان URL شود.
به همین دلیل باید بین:
Discovery
و:
Crawling
تفاوت قائل شویم.
robots.txt چگونه با ساختار URL ارتباط دارد؟
Ruleهای robots.txt براساس Path و Patternهای URL کار می کنند.
پس هرچه ساختار URL سایت بی نظم تر باشد، مدیریت Ruleها نیز دشوارتر می شود.
مثلا اگر یک Feature ده ها نوع پارامتر غیرقابل پیش بینی تولید کند، نوشتن Ruleهای ایمن بسیار سخت تر از سایتی با URLهای کنترل شده است.
به همین دلیل قبل از اضافه کردن تعداد زیادی Pattern بهتر است خود معماری URLهای سایت بررسی شود.
اگر robots.txt وجود نداشته باشد چه می شود؟
وجود نداشتن robots.txt لزوما خطای Technical SEO نیست.
اگر Google برای فایل درخواست ارسال کند و پاسخ معمولی از نوع نبود فایل دریافت کند، در حالت عادی فرض می کند محدودیت Crawl تعریف نشده است.
برای سایت کوچکی که نیاز خاصی به محدود کردن Crawl ندارد، robots.txt بسیار ساده یا حتی نبود Rule محدودکننده عجیب نیست.
اگر robots.txt خطای Server بدهد چه می شود؟
این وضعیت با نبود معمول فایل فرق دارد.
اگر robots.txt با خطاهای Server مثل 5xx در دسترس نباشد، Google با احتیاط بیشتری رفتار می کند زیرا نمی تواند مطمئن شود چه محدودیت هایی برای Crawl تعریف شده اند.
Google در چنین شرایطی می تواند Crawl را موقتا متوقف یا محدود کند و دوباره برای دریافت فایل تلاش کند.
اگر نسخه سالم قبلی در Cache وجود داشته باشد نیز ممکن است مدتی از آن استفاده شود.
پس:
robots.txt باید یک فایل سبک و قابل اتکا باشد و نباید به شکل مداوم خطای Server تولید کند.
اگر robots.txt Redirect شود چه؟
Google می تواند Redirect فایل robots.txt را دنبال کند، اما ایجاد Redirect Chain برای چنین فایل ساده و مهمی هیچ مزیت خاصی ندارد.
بهتر است:
/robots.txt
مستقیما فایل نهایی را ارائه کند.
آیا Google robots.txt را Cache می کند؟
بله.
robots.txt توسط Google Cache می شود، بنابراین تغییر فایل ممکن است همان لحظه در تمام رفتارهای Crawl منعکس نشود.
بعد از تغییر مهم بهتر است فایل را دوباره بررسی کنید و در صورت نیاز از گزارش robots.txt در Search Console برای بررسی وضعیت پردازش فایل استفاده کنید.
حجم robots.txt چقدر می تواند باشد؟
Google فقط بخش محدودی از فایل را پردازش می کند و محتوای بعد از حدود 500 KiB را نادیده می گیرد.
البته برای یک robots.txt عادی رسیدن به چنین حجمی بسیار غیرمعمول است.
اگر فایل شما صدها کیلوبایت Rule دارد، مسئله بزرگ تر احتمالا معماری URL سایت است.
چگونه robots.txt سایت را Audit کنیم؟
برای بررسی فایل بهتر است از یک Workflow مشخص استفاده کنید.
1. فایل را مستقیم باز کنید
ابتدا:
yourdomain.com/robots.txt
را باز کنید.
مطمئن شوید File مورد انتظار نمایش داده می شود و خطای Server یا Redirect عجیب وجود ندارد.
2. User-agentهای فایل را بررسی کنید
مشخص کنید Rule عمومی وجود دارد یا Groupهای اختصاصی برای Botهای مختلف نوشته شده اند.
به خصوص:
User-agent: *
و:
User-agent: Googlebot
را بررسی کنید.
3. دنبال Disallowهای خطرناک بگردید
مثلا:
Disallow: /
یا Ruleهای بسیار کوتاه و گسترده را با دقت بررسی کنید.
4. URLهای اصلی سایت را تست کنید
نمونه ای از این URLها را انتخاب کنید:
- صفحه اصلی؛
- صفحات خدمات؛
- مقالات؛
- دسته بندی های مهم؛
- تصاویر و Resourceهای اصلی.
بررسی کنید هیچ Rule ناخواسته ای روی آن ها Match نمی شود.
5. URLهای Block شده را Crawl کنید
ابزارهایی مثل Screaming Frog می توانند URLهایی را که توسط robots.txt محدود شده اند گزارش کنند.
اما وجود URL در گزارش Blocked by robots.txt به تنهایی خطا نیست.
باید مشخص کنید Block شدن آن عمدی است یا ناخواسته.
6. Search Console را بررسی کنید
گزارش robots.txt در Search Console نشان می دهد Google چه فایل هایی را پیدا کرده، آخرین بار چه زمانی آن ها را Crawl کرده و آیا هنگام پردازش Warning یا Error وجود داشته است.
برای URLهای مهم نیز URL Inspection می تواند در تشخیص مشکلات Crawl کمک کند.
7. بعد از اصلاح دوباره Crawl کنید
فقط ذخیره کردن فایل کافی نیست.
بعد از تغییر Ruleها، Crawl سایت را دوباره اجرا کنید تا مطمئن شوید URL دیگری ناخواسته تحت تاثیر قرار نگرفته است.
چگونه بفهمیم یک Rule بیش از حد گسترده است؟
برای هر Rule دقیقا بررسی کنید چه URLهایی با آن Match می شوند.
مثلا:
Disallow: /product
فقط یک URL با نام product را هدف نمی گیرد؛ URLهایی که Path آن ها با همین Pattern شروع می شود نیز ممکن است Match شوند.
Ruleهای کوتاه معمولا Scope گسترده تری دارند.
قبل از انتشار robots.txt باید چند URL واقعی را مقابل هر Pattern تست کنید.
چه مسیرهایی را در robots.txt مسدود کنیم؟
هیچ لیست ثابتی برای همه سایت ها وجود ندارد.
برای هر مسیر سه سوال بپرسید:
آیا Crawl شدن این URL برای Search فایده ای دارد؟
آیا Crawl شدن آن واقعا مشکلی ایجاد می کند؟
آیا robots.txt ابزار مناسب حل این مسئله است؟
اگر هدف امنیت است، robots.txt انتخاب مناسبی نیست.
اگر هدف جلوگیری از Index است، robots.txt ابزار اصلی نیست.
اگر URL قدیمی حذف شده است، شاید Status Code یا Redirect راه حل باشد.
robots.txt زمانی منطقی است که مسئله واقعی شما مدیریت Crawl باشد.
چک لیست بررسی robots.txt
- □ فایل در Root صحیح Host قرار دارد.
- □ robots.txt پاسخ سالم دریافت می کند.
- □ سایت Production دارای
Disallow: /ناخواسته نیست. - □ صفحات اصلی و خدمات Block نشده اند.
- □ مقالات مهم قابل Crawl هستند.
- □ CSS و JavaScript ضروری مسدود نشده اند.
- □ تصاویر مورد نیاز Search بی دلیل Block نشده اند.
- □ Ruleهای Googlebot بررسی شده اند.
- □ Wildcardها روی URLهای ناخواسته Match نمی شوند.
- □ از robots.txt برای Noindex استفاده نشده است.
- □ اطلاعات خصوصی فقط به robots.txt متکی نیستند.
- □ Sitemap صحیح معرفی شده است.
- □ Crawl-delay برای کنترل Googlebot استفاده نشده است.
- □ فایل Redirect Chain غیرضروری ندارد.
- □ URLهای Block شده در Crawler بررسی شده اند.
- □ بعد از تغییر فایل، سایت دوباره Crawl شده است.
اشتباهات رایج در robots.txt
بخش زیادی از مشکلات robots.txt از چند الگوی تکراری ایجاد می شوند:
- استفاده از robots.txt برای حذف صفحه از Index؛
- باقی ماندن Disallow کل سایت بعد از Staging؛
- مسدود کردن wp-content بدون بررسی Resourceها؛
- Block کردن CSS و JavaScript مهم؛
- نوشتن noindex داخل robots.txt؛
- استفاده از Crawl-delay برای Google؛
- کپی فایل robots.txt سایت دیگر؛
- استفاده افراطی از Wildcard؛
- Block کردن صفحات مهم همراه با قرار دادن آن ها در Sitemap؛
- استفاده از robots.txt به عنوان ابزار امنیتی؛
- فراموش کردن Subdomainها؛
- ویرایش فایل بدون تست URLهای واقعی.
آیا سایت کوچک به robots.txt پیچیده نیاز دارد؟
در بسیاری از موارد خیر.
یک سایت محتوایی با چند صد URL سالم معمولا به صدها Rule نیاز ندارد.
هر Rule اضافی یک شرط جدید به معماری Crawl سایت اضافه می کند.
پیچیدگی فقط زمانی ارزش دارد که مسئله واقعی را حل کند.
اگر Site Architecture تمیز باشد و URLهای غیرضروری به شکل کنترل نشده تولید نشوند، robots.txt می تواند بسیار ساده باقی بماند.
robots.txt را در چه زمان هایی دوباره بررسی کنیم؟
بعد از تغییرات مهم فنی بهتر است فایل و اثر Ruleهای آن دوباره Audit شود؛ مخصوصا بعد از:
- تغییر دامنه یا Subdomain؛
- تغییر ساختار URL؛
- مهاجرت سایت؛
- راه اندازی فروشگاه یا سیستم فیلتر؛
- فعال کردن CDN جدید؛
- تغییر قالب یا سیستم Rendering؛
- تغییر Sitemap؛
- انتقال Staging به Production.
گاهی یک تغییر کوچک در Path باعث می شود Rule قدیمی robots.txt روی بخش کاملا متفاوتی از سایت Match شود.
پاسخ کوتاه: robots.txt دقیقا برای چیست؟
robots.txt برای مدیریت دسترسی Crawlerها به مسیرهای سایت است؛ نه برای تضمین Index شدن، حذف صفحه از Google یا محافظت امنیتی از اطلاعات.
اگر فقط همین تفاوت را به خاطر بسپارید، بسیاری از خطاهای robots.txt اتفاق نمی افتند.
جمع بندی
robots.txt یکی از ابزارهای مهم سئو تکنیکال برای مدیریت Crawling است.
این فایل در Root Host قرار می گیرد و با Directiveهایی مثل User-agent، Disallow، Allow و Sitemap مشخص می کند Crawlerهای سازگار چگونه با مسیرهای مختلف سایت رفتار کنند.
اما robots.txt نباید با Indexing اشتباه گرفته شود. اگر می خواهید صفحه ای در Google نمایش داده نشود، باید مسئله Indexing را جداگانه بررسی کنید؛ همان طور که در راهنمای ایندکس Google توضیح داده ایم.
همچنین Ruleهای robots.txt نباید جای معماری صحیح سایت را بگیرند. URLهای ساده و قابل کنترل، لینک های داخلی منطقی و مسیرهای Crawl واضح معمولا مدیریت Technical SEO را بسیار ساده تر می کنند.
برای همین بهترین robots.txt لزوما طولانی ترین یا پیچیده ترین فایل نیست. فایل خوب، فایلی است که فقط محدودیت های لازم را اعمال کند، صفحات مهم را برای Googlebot قابل Crawl نگه دارد و هیچ Rule مبهم یا ناخواسته ای در مسیر موتور جستجو قرار ندهد.
بعد از هر تغییر مهم نیز باید نتیجه را با Crawl سایت و داده های Search Console بررسی کنید؛ چون یک خط کوتاه در robots.txt می تواند روی تعداد بسیار زیادی URL اثر بگذارد.

اولین دیدگاه را بنویسید