

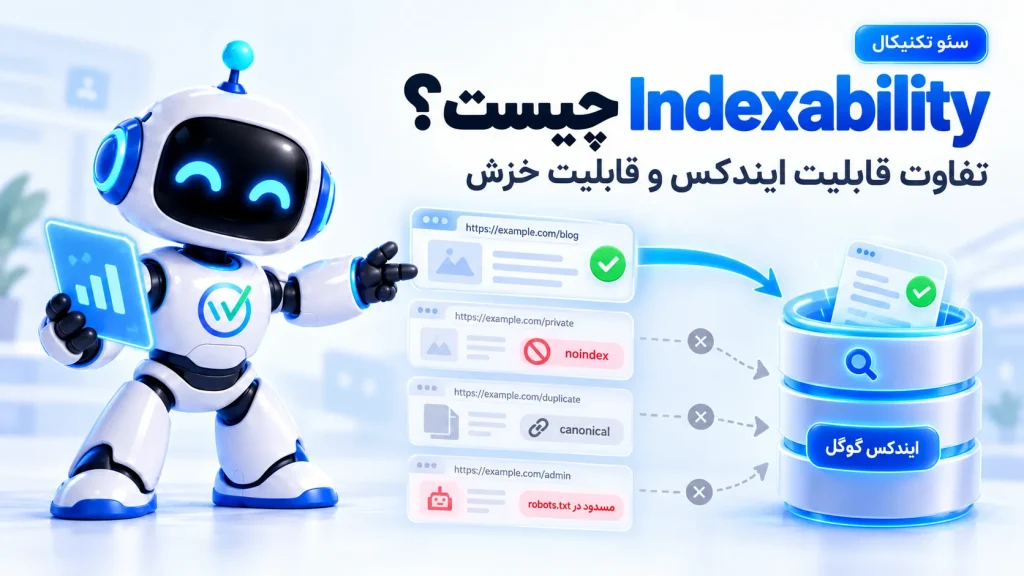
ممکن است Google بتواند یک صفحه را Crawl کند، محتوای آن را ببیند و حتی در Search Console گزارش کند که صفحه با موفقیت Fetch شده است؛ اما همان URL همچنان شرایط لازم برای Index شدن را نداشته باشد.
اینجاست که مفهوم Indexability یا قابلیت ایندکس اهمیت پیدا می کند.
Indexability مشخص می کند آیا یک URL از نظر فنی اجازه و شرایط اولیه لازم برای قرار گرفتن در Index موتور جستجو را دارد یا نه.
مواردی مثل noindex، Canonical، Redirect، Status Code، صفحات تکراری، Soft 404 و بعضی محدودیت های دسترسی می توانند روی وضعیت Indexability یک صفحه اثر بگذارند.
اما یک نکته از همان ابتدا باید روشن باشد:
Indexable بودن یک صفحه به معنی Indexed بودن آن نیست.
ممکن است صفحه کاملا قابل Crawl و قابل Index باشد، اما Google همچنان تصمیم بگیرد آن را وارد Index نکند.
در این راهنما بررسی می کنیم Indexability چیست، چه تفاوتی با Crawlability و Indexing دارد و چگونه مشکلات قابلیت ایندکس صفحات سایت را مرحله به مرحله پیدا کنیم.
Indexability چیست؟
Indexability یا قابلیت ایندکس یعنی یک صفحه از نظر فنی مانع مستقیمی برای قرار گرفتن در Index موتور جستجو نداشته باشد.
برای مثال، یک صفحه معمولی که قرار است در Google حضور داشته باشد معمولا باید شرایطی مثل این موارد داشته باشد:
- Google بتواند به محتوای آن دسترسی داشته باشد؛
- دستور
noindexنداشته باشد؛ - پاسخ HTTP مناسب دریافت شود؛
- صفحه Redirect نباشد؛
- به عنوان صفحه خطا یا Soft 404 تشخیص داده نشود؛
- Canonical و سایر سیگنال ها با هدف صفحه تضاد جدی نداشته باشند.
اما حتی اگر تمام این موارد درست باشند، Google موظف نیست صفحه را Index کند.
Google در ابزار URL Inspection نیز میان قابل Index بودن URL و Indexed بودن آن تفاوت قائل می شود.
تفاوت Indexability و Indexing چیست؟
Indexability درباره امکان و مجاز بودن ایندکس شدن است.
Indexing خود فرایندی است که طی آن Google محتوا را تحلیل می کند و در صورت انتخاب، اطلاعات صفحه را وارد Index می کند.
به زبان ساده:
Indexability = آیا صفحه می تواند ایندکس شود؟
Indexing = آیا Google واقعا آن را وارد Index کرده است؟
فرض کنید صفحه ای:
- HTTP 200 دارد؛
noindexندارد؛- قابل Crawl است؛
- Canonical آن به خودش اشاره می کند.
این صفحه از نظر پایه می تواند Indexable باشد.
اما Google ممکن است به دلایلی مثل کیفیت ناکافی، شباهت زیاد به URL دیگر یا انتخاب Canonical متفاوت آن را وارد Index نکند.
برای شناخت خود فرایند Indexing می توانید راهنمای ایندکس Google چیست؟ را مطالعه کنید.
تفاوت Indexability و Crawlability چیست؟
این دو مفهوم رابطه نزدیکی دارند، اما وظیفه متفاوتی دارند.
| Crawlability | Indexability |
|---|---|
| آیا Crawler می تواند به صفحه دسترسی داشته باشد؟ | آیا صفحه اجازه و شرایط اولیه Index شدن را دارد؟ |
| robots.txt اهمیت زیادی دارد | noindex اهمیت زیادی دارد |
| Server و دسترسی شبکه مهم هستند | Canonical و وضعیت Indexing مهم هستند |
| مربوط به دریافت URL است | مربوط به امکان ورود URL به Index است |
مثلا ممکن است صفحه ای کاملا Crawlable باشد اما این دستور را داشته باشد:
<meta name="robots" content="noindex">
Google می تواند صفحه را دریافت کند، ولی نباید آن را در نتایج Search نگه دارد.
برعکس، اگر صفحه با robots.txt مسدود باشد، Google ممکن است نتواند حتی دستور noindex داخل آن را مشاهده کند.
رابطه Crawlability و Indexability چگونه است؟
برای بسیاری از صفحات HTML، Google باید بتواند صفحه را Crawl کند تا دستورها و محتوای آن را پردازش کند.
مدل ساده را می توان این طور تصور کرد:
Discovery → Crawlability → Crawling → Indexability → Indexing
البته سیستم واقعی Google پیچیده تر است، اما این مدل برای Debug کردن مشکلات مفید است.
اگر صفحه در مرحله Crawl مسدود باشد، بررسی بعضی سیگنال های Indexing داخل خود صفحه نیز ممکن نیست.
آیا Crawl شدن صفحه یعنی Indexable است؟
خیر.
Google ممکن است صفحه را با موفقیت Crawl کند، ولی صفحه:
noindexداشته باشد؛- Redirect شود؛
- Canonical آن URL دیگری باشد؛
- Soft 404 تشخیص داده شود؛
- Duplicate یک صفحه دیگر باشد.
پس گزارش:
Page fetch: Successful
به تنهایی اثبات نمی کند URL باید Index شود.
آیا Indexable بودن یعنی صفحه حتما در Google ایندکس می شود؟
خیر.
این یکی از مهم ترین نکات Indexability است.
حتی URL Inspection در Live Test نیز توضیح می دهد که نتیجه مثبت به معنی تضمین Index شدن نیست.
ممکن است یک صفحه از نظر فنی قابلیت Index داشته باشد، اما Google براساس مجموعه سیگنال های دیگر آن را انتخاب نکند.
بنابراین:
Indexable ≠ Indexed
و همین طور:
Indexed ≠ Guaranteed Ranking
مهم ترین عوامل فنی Indexability چیست؟
برای بررسی قابلیت ایندکس بهتر است چند عامل اصلی را جداگانه تحلیل کنیم.
1. Meta Robots
یکی از مستقیم ترین روش های کنترل Indexability صفحه استفاده از Robots Meta Tag است.
مثلا:
<meta name="robots" content="noindex">
به موتور جستجویی که این دستور را پشتیبانی می کند اعلام می کند صفحه در نتایج Search نمایش داده نشود.
اگر هدف شما Index شدن صفحه است، وجود ناخواسته noindex یک مشکل جدی محسوب می شود.
مستند رسمی Google درباره Robots Meta Tag
Meta Robots index لازم است؟
در حالت عادی نیازی نیست روی همه صفحات این تگ را بنویسید:
<meta name="robots" content="index">
Google در نبود محدودیت Indexing می تواند صفحه را برای Index شدن بررسی کند.
یعنی:
index
بیشتر بیان صریح رفتار پیش فرض است و اضافه کردن آن تضمین Index شدن ایجاد نمی کند.
noindex دقیقا چه کاری انجام می دهد؟
دستور noindex به Google اعلام می کند صفحه یا منبع در Search نمایش داده نشود.
Google توضیح می دهد وقتی Googlebot صفحه را Crawl کند و این دستور را ببیند، صفحه از نتایج Google حذف می شود؛ حتی اگر سایت های دیگری به آن لینک داده باشند.
اما برای اثر کردن این دستور، Google باید بتواند آن را مشاهده کند.
راهنمای Google برای جلوگیری از Index با noindex
چرا نباید noindex را با robots.txt ترکیب کنیم؟
یکی از اشتباهات رایج این است که صفحه هم در robots.txt مسدود شود و هم داخل آن noindex قرار بگیرد.
مشکل این است که اگر Googlebot اجازه Crawl صفحه را نداشته باشد، ممکن است نتواند تگ noindex را ببیند.
در نتیجه:
robots.txt ← جلوگیری از Crawl
noindex ← جلوگیری از Index
اگر هدف حذف URL از Search است، مسدود کردن Crawl همان کاری نیست که noindex انجام می دهد.
آیا می توان noindex را داخل robots.txt قرار داد؟
خیر.
Google استفاده از دستور noindex داخل robots.txt را پشتیبانی نمی کند.
برای کنترل Indexing باید از روش هایی مثل Robots Meta Tag یا X-Robots-Tag استفاده شود.
X-Robots-Tag چیست؟
دستورهای Indexing همیشه لازم نیست داخل HTML باشند.
می توان از HTTP Response Header نیز استفاده کرد:
X-Robots-Tag: noindex
این روش مخصوصا برای منابعی که HTML نیستند کاربرد دارد، مثل:
- PDF؛
- فایل تصویر؛
- بعضی فایل های دانلودی.
پس هنگام Debug یک URL فقط Source HTML را بررسی نکنید. HTTP Header نیز ممکن است دستور Indexing داشته باشد.
اگر Meta Robots و X-Robots-Tag با هم متفاوت باشند چه می شود؟
وجود چند دستور متناقض می تواند وضعیت را پیچیده کند.
مثلا HTML اجازه Index بدهد ولی Server Header:
X-Robots-Tag: noindex
برگرداند.
در Audit باید تمام دستورهای قابل مشاهده برای Googlebot را بررسی کنید، نه فقط تنظیم افزونه سئو داخل WordPress.
Canonical چه ارتباطی با Indexability دارد؟
Canonical مستقیما دستور noindex نیست.
اما روی اینکه Google کدام نسخه از مجموعه URLهای مشابه را به عنوان نسخه اصلی انتخاب کند تاثیر دارد.
فرض کنید:
Page A → canonical → Page B
Google ممکن است A را Crawl و تحلیل کند، ولی B را به عنوان Canonical انتخاب کند.
در این وضعیت ممکن است URL A خودش به عنوان صفحه مستقل در Index نگهداری نشود.
پس Canonical و Indexability به هم مرتبط هستند، ولی:
Canonical ≠ noindex
راهنمای رسمی Google درباره Canonicalization
آیا Canonical یک دستور قطعی است؟
خیر.
Google Canonical را یکی از سیگنال های انتخاب URL اصلی در نظر می گیرد.
در کنار آن مواردی مثل:
- Redirect؛
- Sitemap؛
- لینک های داخلی؛
- HTTPS؛
- محتوای URLها
نیز می توانند در Canonicalization نقش داشته باشند.
بنابراین ممکن است شما URL A را Canonical معرفی کنید ولی Google براساس سایر سیگنال ها URL B را انتخاب کند.
User-declared Canonical و Google-selected Canonical چه تفاوتی دارند؟
در URL Inspection ممکن است دو مقدار ببینید:
User-declared canonical یعنی URLی که سایت شما ترجیح خود را با آن اعلام کرده است.
Google-selected canonical یعنی URLی که Google در نهایت به عنوان نسخه اصلی مجموعه انتخاب کرده است.
اگر این دو با هم متفاوت باشند، باید دلیل اختلاف بررسی شود.
مواردی مثل محتوای مشابه، لینک های داخلی متناقض یا Sitemap ناسازگار می توانند سرنخ باشند.
Duplicate Content چگونه روی Indexability اثر می گذارد؟
ممکن است چند URL از نظر فنی:
- HTTP 200 داشته باشند؛
- noindex نداشته باشند؛
- قابل Crawl باشند؛
اما محتوای آن ها تقریبا یکسان باشد.
در این وضعیت Google می تواند URLها را در یک Duplicate Cluster قرار دهد و یکی را به عنوان Canonical انتخاب کند.
در نتیجه همه نسخه ها لزوما به شکل مستقل Index نمی شوند.
این به معنی «خطا» بودن تمام Duplicateها نیست؛ وجود بعضی نسخه های مشابه در سایت طبیعی است.
آیا Self-Canonical صفحه را Indexable می کند؟
Self-Canonical سیگنال خوبی برای مشخص کردن نسخه اصلی صفحه است:
Page A → canonical → Page A
اما این تگ به تنهایی Index شدن را تضمین نمی کند.
صفحه ممکن است Self-Canonical داشته باشد ولی:
- noindex باشد؛
- Soft 404 باشد؛
- محتوای بسیار کم ارزش داشته باشد؛
- یا Google Canonical دیگری انتخاب کند.
Status Code چه تاثیری بر Indexability دارد؟
وضعیت HTTP یکی از لایه های اصلی بررسی است.
برای یک صفحه عادی که قرار است محتوای خودش Index شود، معمولا انتظار داریم پاسخ نهایی موفق باشد.
چند وضعیت رایج:
| Status | رفتار کلی |
|---|---|
| 200 | محتوا می تواند برای پردازش Indexing بررسی شود |
| 301 / 308 | URL به مقصد دیگری منتقل می شود |
| 302 / 307 | Redirect موقت |
| 404 | محتوا وجود ندارد |
| 410 | منبع حذف شده است |
| 5xx | Server نتوانسته پاسخ سالم ارائه کند |
اما حتی پاسخ 200 نیز تضمین نمی کند Google صفحه را Index کند.
آیا صفحه Redirect شده Indexable است؟
اگر URL A به URL B Redirect شود، معمولا انتظار نداریم محتوای مستقلی از A پردازش شود.
مثلا:
/old-page/ → 301 → /new-page/
تمرکز Indexing به مقصد Redirect منتقل می شود.
بنابراین وقتی ابزار Audit می گوید یک URL Redirect شده، نباید صرفا به آن index اضافه کنیم؛ ابتدا باید ببینیم آیا Redirect عمدی و صحیح است یا نه.
404 و 410 چه تاثیری بر Index دارند؟
اگر صفحه واقعا وجود ندارد، پاسخ 404 یا 410 رفتار طبیعی و قابل قبول است.
Google چنین URLهایی را برای حضور پایدار در Search نگه نمی دارد.
مشکل زمانی است که:
- صفحه مهم اشتباها 404 شده باشد؛
- لینک های داخلی هنوز به آن اشاره کنند؛
- یا صفحه موجود باشد ولی Server Status اشتباه برگرداند.
Soft 404 چیست؟
Soft 404 زمانی رخ می دهد که Server پاسخ موفق مثل 200 بدهد، ولی محتوای صفحه عملا نشان دهد چیزی وجود ندارد یا محتوای اصلی قابل استفاده نیست.
مثلا:
HTTP 200
ولی متن صفحه:
محصول مورد نظر پیدا نشد.
Google می تواند چنین صفحه ای را Soft 404 تشخیص دهد و آن را از Search کنار بگذارد.
پس:
200 = Indexable
همیشه درست نیست.
راهنمای Google درباره Soft 404
صفحه خالی می تواند Soft 404 شود؟
بله، در بعضی شرایط صفحه ای که پاسخ 200 می دهد ولی محتوای اصلی ندارد یا هنگام Render تقریبا خالی است ممکن است Soft 404 تشخیص داده شود.
این وضعیت مخصوصا در مشکلات JavaScript، Database یا Template قابل مشاهده است.
بنابراین فقط Status Code را بررسی نکنید؛ محتوای Render شده نیز مهم است.
آیا robots.txt روی Indexability تاثیر دارد؟
robots.txt مستقیما دستور Indexing نیست، اما می تواند به شکل غیرمستقیم Debug Indexability را تحت تاثیر قرار دهد.
اگر Google نتواند صفحه را Crawl کند، امکان مشاهده Meta Robots یا بعضی سیگنال های داخل صفحه را ندارد.
Google حتی توضیح می دهد وقتی صفحه توسط robots.txt مسدود باشد، URL Inspection ممکن است برای بخش:
Indexing allowed?
مقدار Yes نشان دهد، چون Google نتوانسته محتوای صفحه را ببیند تا دستور احتمالی noindex را پردازش کند.
این یکی از دلایلی است که Crawlability و Indexability باید جدا بررسی شوند.
آیا صفحه پشت Login قابل Index است؟
اگر محتوا فقط بعد از Authentication قابل مشاهده باشد، Googlebot عادی نیز معمولا نمی تواند آن را مثل یک صفحه عمومی دریافت کند.
برای صفحاتی مثل:
- حساب کاربری؛
- پنل مشتری؛
- صفحه مدیریت؛
- محتوای خصوصی
این وضعیت معمولا عمدی است و مشکلی محسوب نمی شود.
تمام صفحات سایت قرار نیست Indexable باشند.
آیا همه صفحات سایت باید Indexable باشند؟
خیر.
یکی از اشتباهات رایج Audit این است که هر URL غیرقابل Index را خطا در نظر بگیریم.
صفحات زیر ممکن است عمدا Index نشوند:
- صفحه ورود؛
- حساب کاربری؛
- سبد خرید؛
- نتایج جستجوی داخلی؛
- بعضی صفحات فیلتر؛
- نسخه های Duplicate؛
- صفحات مدیریتی؛
- صفحات موقت یا خصوصی.
سوال درست این نیست:
چند صفحه Non-Indexable داریم؟
بلکه:
آیا صفحه ای که باید در Search حضور داشته باشد، به اشتباه Non-Indexable شده است؟
چگونه Indexability یک صفحه را بررسی کنیم؟
برای Debug یک URL بهتر است مراحل را به ترتیب بررسی کنیم.
مرحله 1: مشخص کنید صفحه اصلا باید Index شود یا نه
قبل از بررسی Technical ابتدا Job صفحه را مشخص کنید.
مثلا یک مقاله آموزشی اصلی باید احتمالا Index شود.
اما صفحه:
/my-account/
ممکن است هیچ نیازی به حضور در Search نداشته باشد.
بدون این تصمیم، نمی توان گفت noindex روی صفحه خطاست یا تنظیم صحیح.
مرحله 2: Status Code را بررسی کنید
برای صفحه ای که قرار است محتوای خودش Index شود، وضعیت HTTP نهایی را بررسی کنید.
اگر URL:
- Redirect است؛
- 404 است؛
- 5xx دارد؛
ابتدا باید همین مسئله بررسی شود.
مرحله 3: Meta Robots را بررسی کنید
Source یا DOM صفحه را بررسی کنید.
به دنبال مواردی مثل این باشید:
<meta name="robots" content="noindex">
یا:
<meta name="googlebot" content="noindex">
وجود این دستور برای صفحه ای که باید Index شود نیاز به اصلاح دارد.
مرحله 4: HTTP Header را بررسی کنید
بررسی کنید Server این Header را برنگرداند:
X-Robots-Tag: noindex
این مورد گاهی در Source HTML دیده نمی شود و به همین دلیل ممکن است در Audit دستی فراموش شود.
مرحله 5: Canonical را بررسی کنید
ببینید User-declared Canonical چه URLی است.
اگر صفحه مهم:
Page A
به اشتباه Canonical به:
Page B
باشد، باید دلیل آن مشخص شود.
مرحله 6: robots.txt را بررسی کنید
حتی اگر هدف اصلی Indexing است، باید مطمئن شوید Google می تواند صفحه را Crawl کند و دستورهای آن را ببیند.
مرحله 7: URL Inspection را بررسی کنید
در Google Search Console URL را Inspect کنید.
مخصوصا این بخش ها مهم هستند:
- Crawl allowed?
- Page fetch
- Indexing allowed?
- User-declared canonical
- Google-selected canonical
- Last crawl
این اطلاعات کمک می کنند بفهمید Google چه نسخه ای از صفحه را پردازش کرده است.
مرحله 8: Live Test را اجرا کنید
اگر اخیرا مشکلی را اصلاح کرده اید، داده Indexed ممکن است هنوز وضعیت قبلی را نشان دهد.
در این حالت Test Live URL کمک می کند نسخه فعلی صفحه را بررسی کنید.
اما Live Test نیز تمام شرایط Indexing را بررسی نمی کند.
مثلا Duplicate بودن و بعضی تصمیم های Canonicalization ممکن است فقط در پردازش کامل Google مشخص شوند.
اگر URL Inspection بگوید Indexing allowed: Yes ولی صفحه Index نشده چه؟
این وضعیت لزوما تناقض نیست.
Indexing allowed: Yes
یعنی سایت شما دستور مستقیمی برای جلوگیری از Indexing ارائه نکرده است.
این عبارت به معنی:
Google حتما این صفحه را Index می کند
نیست.
سپس باید موارد دیگری را بررسی کنید:
- آیا صفحه Crawl شده؟
- محتوا ارزش مستقل دارد؟
- Duplicate نیست؟
- Canonical انتخابی چیست؟
- Soft 404 نشده؟
- Google URL دیگری را ترجیح نداده؟
Page is not indexed: Duplicate یعنی چه؟
ممکن است Google تشخیص دهد محتوای URL با صفحه دیگری بسیار مشابه است.
در این حالت معمولا یک نسخه را Canonical انتخاب می کند.
اگر Google همان URL مورد انتظار شما را انتخاب کرده، لزوما مشکلی وجود ندارد.
اما اگر URL اشتباهی Canonical شده، باید سیگنال های سایت را بررسی کنید.
Crawled – currently not indexed یعنی Non-Indexable است؟
نه لزوما.
این وضعیت معمولا یعنی Google صفحه را Crawl کرده ولی در آن زمان تصمیم نگرفته آن را وارد Index کند.
ممکن است صفحه از نظر فنی Indexing را مجاز کرده باشد.
پس اضافه کردن تصادفی:
index, follow
معمولا درمان این وضعیت نیست.
باید کیفیت، تمایز، ارزش صفحه و رابطه آن با URLهای مشابه بررسی شود.
Discovered – currently not indexed چه تفاوتی دارد؟
در این وضعیت Google URL را می شناسد ولی هنوز آن را Crawl نکرده یا پردازش کامل آن انجام نشده است.
پس قبل از نتیجه گیری درباره Indexability باید مسئله Discovery و Crawl نیز بررسی شود.
این مثال دوباره نشان می دهد چرا باید:
Discovery
Crawling
Indexability
Indexing
را مفاهیم جدا در نظر بگیریم.
چگونه Indexability کل سایت را Audit کنیم؟
برای سایت بزرگ بررسی دستی تمام URLها عملی نیست.
می توانید سایت را با Crawlerهایی مثل Screaming Frog Crawl کنید و حداقل این داده ها را استخراج کنید:
- Status Code؛
- Indexability؛
- Indexability Status؛
- Meta Robots؛
- X-Robots-Tag؛
- Canonical؛
- Canonical Status؛
- Redirectها؛
- Soft 404های احتمالی.
بعد URLها را براساس نوع صفحه تقسیم کنید.
مثلا:
مقالات ← باید Index شوند
صفحات خدمات ← باید Index شوند
حساب کاربری ← نباید Index شود
نتایج جستجوی داخلی ← معمولا نیازی به Index ندارند
این مقایسه بسیار مفیدتر از نگاه کردن به عدد خام Non-Indexable URLs است.
گزارش Indexability ابزارها را چگونه تفسیر کنیم؟
اگر Crawler صفحه ای را Non-Indexable اعلام کرد، ابتدا ببینید دلیل چیست.
ممکن است دلیل کاملا صحیح باشد:
Non-Indexable: Redirected
برای URL قدیمی که عمدا Redirect شده است.
یا:
Non-Indexable: noindex
برای صفحه حساب کاربری.
اما همان وضعیت روی مقاله مهم می تواند مشکل جدی باشد.
پس Report بدون Context تصمیم نهایی نیست.
چگونه Indexability صفحات مهم را اولویت بندی کنیم؟
مشکلات را براساس اهمیت URL بررسی کنید.
| مشکل | اولویت تقریبی |
|---|---|
| noindex ناخواسته روی صفحه اصلی | بحرانی |
| noindex گسترده روی صفحات خدمات | بحرانی |
| Canonical اشتباه روی صفحات استراتژیک | خیلی بالا |
| 5xx گسترده | خیلی بالا |
| مقاله مهم Soft 404 شده | بالا |
| Duplicate غیرضروری | متوسط تا بالا |
| صفحه بی ارزش عمدا noindex | بدون مشکل |
این اولویت ها ثابت نیستند و باید براساس سایت و ارزش URLها تعیین شوند.
آیا XML Sitemap روی Indexability اثر دارد؟
Sitemap یکی از سیگنال هایی است که Google می تواند برای Canonicalization و Discovery استفاده کند، اما URL موجود در Sitemap خودکار Indexable نمی شود.
قرار دادن صفحه noindex داخل Sitemap نیز تضاد سیگنال ایجاد می کند:
Sitemap ← این URL برای سایت مهم است
noindex ← این URL در Search نباشد
بهتر است Sitemap اصلی بیشتر شامل URLهایی باشد که واقعا قصد Index شدن آن ها را دارید.
آیا لینک داخلی روی Indexability اثر دارد؟
لینک داخلی مستقیما noindex را حذف نمی کند، اما بخشی از مجموعه سیگنال های سایت است.
اگر صفحه ای:
- Canonical خودش است؛
- در Sitemap قرار دارد؛
- ولی هیچ لینک داخلی دریافت نمی کند؛
ساختار سایت پیام کاملا یکدستی درباره اهمیت آن URL نمی دهد.
برای صفحات مهم بهتر است معماری و لینک سازی داخلی نیز با هدف Index شدن هماهنگ باشند.
آیا Nofollow باعث Non-Indexable شدن صفحه مقصد می شود؟
خیر.
Nofollow روی لینک، دستور noindex برای صفحه مقصد نیست.
Google ممکن است URL را از:
- لینک دیگر؛
- Sitemap؛
- Redirect؛
- یا سابقه قبلی Crawl
بشناسد.
پس اگر هدف جلوگیری از Index شدن یک URL است، Nofollow روش مناسبی برای این کار نیست.
JavaScript چگونه Indexability را تحت تاثیر قرار می دهد؟
اگر Meta Robots، Canonical یا محتوای اصلی توسط JavaScript تغییر کند، باید نسخه Render شده را بررسی کنید.
ممکن است Source اولیه چنین باشد:
<meta name="robots" content="index">
ولی JavaScript بعدا آن را به:
<meta name="robots" content="noindex">
تغییر دهد.
یا Canonical بعد از Render متفاوت شود.
برای سایت های JavaScript محور فقط View Source کافی نیست؛ DOM نهایی و چیزی که Google Render کرده نیز باید بررسی شود.
آیا کیفیت محتوا بخشی از Indexability است؟
اگر Indexability را به معنای محدود و فنی در نظر بگیریم، کیفیت محتوا با دستورهایی مثل noindex متفاوت است.
اما در عمل ممکن است صفحه از نظر فنی Indexable باشد و Google همچنان آن را Index نکند.
بنابراین هنگام Debug باید دو سوال مستقل بپرسید:
آیا مانع فنی برای Indexing وجود دارد؟
و:
آیا صفحه ارزش و تمایز کافی برای نگهداری در Index دارد؟
این دو سوال را نباید با هم یکی کرد.
چرا افزودن index, follow معمولا مشکل Indexing را حل نمی کند؟
یکی از واکنش های رایج وقتی صفحه Index نمی شود این است که:
<meta name="robots" content="index, follow">
اضافه کنیم.
اما اگر صفحه از ابتدا noindex نداشته، این کار معمولا چیزی را تغییر نمی دهد.
مشکل ممکن است در:
- Canonical؛
- Duplicate Content؛
- Soft 404؛
- Crawl؛
- ارزش محتوا؛
- یا انتخاب Google
باشد.
اگر صفحه مهم Index نمی شود، از کجا شروع کنیم؟
- مطمئن شوید URL باید Index شود.
- Status Code را بررسی کنید.
- Crawlability را بررسی کنید.
- Meta Robots را بررسی کنید.
- X-Robots-Tag را بررسی کنید.
- Canonical را بررسی کنید.
- URL Inspection را باز کنید.
- Google-selected canonical را بررسی کنید.
- Duplicate بودن صفحه را ارزیابی کنید.
- Soft 404 را بررسی کنید.
- محتوای Render شده را ببینید.
- لینک داخلی و Sitemap را بررسی کنید.
- بعد از اصلاح، Live Test و Request Indexing را در صورت نیاز اجرا کنید.
چک لیست Indexability
- □ صفحه واقعا باید در Google حضور داشته باشد.
- □ URL پاسخ مناسب دریافت می کند.
- □ URL Redirect نشده است.
- □ Meta Robots دارای noindex ناخواسته نیست.
- □ Googlebot-specific noindex وجود ندارد.
- □ X-Robots-Tag صفحه را noindex نکرده است.
- □ robots.txt مانع مشاهده دستورهای صفحه نشده است.
- □ Canonical به URL مورد انتظار اشاره می کند.
- □ Google-selected canonical بررسی شده است.
- □ صفحه Duplicate ناخواسته نیست.
- □ صفحه Soft 404 تشخیص داده نشده است.
- □ Render نهایی محتوای اصلی را نشان می دهد.
- □ صفحه مهم در Sitemap مناسب قرار دارد.
- □ لینک های داخلی به نسخه اصلی URL اشاره می کنند.
- □ نسخه HTTPS و URL نهایی با Canonical هماهنگ هستند.
- □ URL Inspection مقدار Indexing allowed را بررسی کرده است.
- □ نتیجه Live Test با وضعیت Indexed اشتباه گرفته نشده است.
- □ بعد از اصلاح، فرصت Crawl مجدد به Google داده شده است.
اشتباهات رایج درباره Indexability
- یکی دانستن Indexable و Indexed؛
- یکی دانستن Crawlability و Indexability؛
- استفاده از robots.txt برای noindex کردن صفحه؛
- قرار دادن noindex روی صفحه ای که robots.txt آن را Block کرده است؛
- تصور اینکه index, follow باعث Index شدن می شود؛
- تصور اینکه HTTP 200 برای Index شدن کافی است؛
- استفاده از Canonical به جای noindex بدون درک هدف آن؛
- قرار دادن صفحات noindex در Sitemap اصلی بدون دلیل؛
- اعتماد کامل به وضعیت Indexability یک Crawler؛
- بررسی نکردن X-Robots-Tag؛
- نادیده گرفتن Google-selected canonical؛
- در نظر گرفتن تمام صفحات Non-Indexable به عنوان خطا؛
- درخواست مکرر Indexing بدون حل مشکل اصلی.
آیا Request Indexing مشکل Indexability را حل می کند؟
خیر.
Request Indexing فقط به Google اعلام می کند URL را دوباره بررسی کند.
اگر صفحه هنوز:
- noindex باشد؛
- Canonical اشتباه داشته باشد؛
- مشکل Fetch داشته باشد؛
- یا Non-Indexable باشد،
درخواست مجدد مشکل اصلی را برطرف نمی کند.
ابتدا Issue را اصلاح کنید و بعد در صورت نیاز Request Indexing را استفاده کنید.
آیا Indexability یک Ranking Factor است؟
Indexability را بهتر است یک پیش نیاز فنی برای حضور معمول صفحه در Search بدانیم، نه یک امتیاز رتبه بندی که بتوان آن را از 0 تا 100 افزایش داد.
یک صفحه یا مانع مشخصی برای Indexing دارد یا ندارد.
بعد از اینکه صفحه قابلیت ورود به Index را داشته باشد، موضوعاتی مثل کیفیت محتوا، ارتباط با Query، اعتبار و سایر سیگنال ها وارد مراحل بعدی می شوند.
پاسخ کوتاه: Indexability دقیقا چیست؟
Indexability یعنی یک URL از نظر فنی اجازه و شرایط لازم برای بررسی شدن به عنوان کاندید ورود به Index موتور جستجو را داشته باشد.
اما کاندید بودن با پذیرفته شدن یکسان نیست.
ممکن است URL کاملا Indexable باشد و Google همچنان تصمیم بگیرد آن را Index نکند.
جمع بندی
Indexability یا قابلیت ایندکس مشخص می کند آیا یک صفحه مانع فنی مشخصی برای حضور در Index موتور جستجو دارد یا نه.
برای بررسی آن باید مواردی مثل Meta Robots، X-Robots-Tag، Canonical، Status Code، Redirect، Soft 404، Duplicate Content، robots.txt و داده های URL Inspection را کنار هم بررسی کنیم.
مهم ترین نکته این است که Indexability را با Crawling یا Indexing یکی ندانیم.
یک URL می تواند Crawl شود ولی noindex باشد. می تواند Indexable باشد ولی هنوز وارد Index نشده باشد. حتی می تواند در Index باشد ولی برای Query مورد نظر شما رتبه نگیرد.
پس هنگام Debug بهتر است زنجیره را مرحله به مرحله بررسی کنیم:
Discovery → Crawl → Indexability → Indexing → Ranking
اگر صفحه مهمی Index نشده، قبل از تغییر تصادفی Meta Tag یا ارسال چندباره Request Indexing، ابتدا مشخص کنید دقیقا در کدام مرحله مشکل وجود دارد.

اولین دیدگاه را بنویسید