

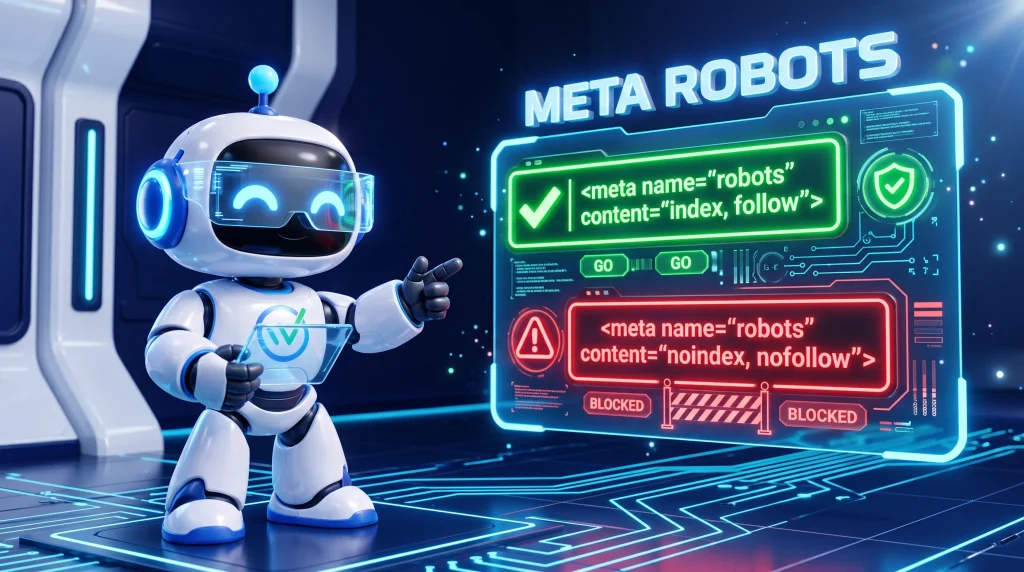
تگ متای ربات ها یا Meta Robots یکی از کدهای دستوری بنیادین در فرآیند نمایه سازی وب است که به مدیران سایت اجازه می دهد نحوه برخورد خزنده ها با تک تک صفحات را در سطح صفحه (Page-level) مدیریت کنند. در حالی که ابزارهای هدایت خزش، دسترسی بات ها به آدرس ها را مشخص می کنند، تگ Meta Robots مستقیماً با پایگاه داده هر موتور جستجو مانند گوگل گفتگو می کند و فرمان می دهد که آیا یک صفحه مجاز به ذخیره در ایندکس هست یا خیر، و اینکه آیا اعتبار پیوندهای موجود در آن باید دنبال شود یا نه.
درک کارکرد این قطعه کد کوچک در حوزه سئو تکنیکال اهمیت حیاتی دارد؛ چرا که یک اشتباه جزئی در تنظیم دستورات آن (مانند فعال ماندن تصادفی دستور noindex) می تواند در عرض چند روز هزاران صفحه باارزش را از صفحه نتایج جستجو حذف کرده و ترافیک ارگانیک کسب وکار را به صفر برساند. برای تسلط بر سلامت فنی سایت، باید مرزبندی دقیق میان خزش، ایندکس و هدایت لینک ها را بشناسیم.
تگ Meta Robots چیست و چگونه در کدهای سایت قرار می گیرد؟
تگ Meta Robots یک برچسب متادیتا در ساختار HTML است که در بخش هدر صفحه (بین تگ های <head> و </head>) قرار می گیرد. این تگ شامل دو بخش اصلی است: شناسه ربات هدف (اتریبیوت name) و دستورات اجرایی (اتریبیوت content). بر خلاف فایل های متنی خارجی، این تگ بخشی از سورس کد اختصاصی همان صفحه وب است و تنها پس از دانلود و بررسی محتوای صفحه توسط خزنده ها پردازش می شود.
قاعده محوری: تگ Meta Robots یک دستور قطعی (Directive) برای سیستم ایندکسینگ است، نه یک پیشنهاد. اگر در این تگ دستور noindex صادر شود، گوگل موظف است صفحه را از نتایج عمومی جستجو حذف یا از ورود آن ممانعت کند.
آناتومی و سینتکس استاندارد کدهای HTML
ساختار استاندارد تگ متای ربات به شکل زیر نوشته می شود:
<meta name="robots" content="noindex, nofollow">در این ساختار، مرورگرها و ربات ها متوجه می شوند که دستورات مشخص شده در بخش content باید برای خزنده های عمومی وب اعمال شوند. در صورت درج چند دستور، آن ها را با ویرگول انگلیسی (Comma) از یکدیگر تفکیک می کنند.
تفاوت User-Agent هدفمند و عمومی
زمانی که مقدار اتریبیوت name برابر با robots قرار می گیرد، این دستور به تمامی خزنده های وب (گوگل، بینگ، یاندکس و غیره) ابلاغ می شود. با این حال، وبمسترها می توانند دستورات اختصاصی برای یک موتور جستجوی خاص صادر کنند. به عنوان مثال، اگر قصد داشته باشید صفحه ای برای همه در دسترس باشد اما اختصاصاً خزشگر اصلی گوگل به آن واکنش متفاوتی نشان دهد، از شناسه اختصاصی استفاده می شود:
<meta name="googlebot" content="noindex">
<meta name="googlebot-news" content="nosnippet">
در صورت وجود تناقض میان دستور عمومی (robots) و دستور اختصاصی (googlebot)، موتور جستجوی گوگل همیشه دستوری را که دقیق تر و محدودکننده تر است در اولویت قرار می دهد.
جایگزین پنهان: هدر X-Robots-Tag چیست و چه زمانی کاربرد دارد؟
تگ های HTML تنها در اسنادی کاربرد دارند که ساختار متنی وب دارند؛ اما وب سایت ها میزبان فایل های غیر HTML مانند کاتالوگ های PDF، فایل های متنی، اسناد Word یا تصاویر گرافیکی نیز هستند. از آنجا که یک فایل PDF بخش <head> ندارد، نمی توان تگ meta robots را درون آن قرار داد.
در چنین سناریوهایی، از هدر پاسخ سرور با عنوان X-Robots-Tag استفاده می شود. وب سرور (مانند Apache یا Nginx) هنگام تحویل فایل به ربات، دستور ایندکسینگ را مستقیماً در هدرهای HTTP پاسخ می دهد:
HTTP/1.1 200 OK
Date: Sun, 18 Oct 2026 12:00:00 GMT
Content-Type: application/pdf
X-Robots-Tag: noindex, nofollow
این هدر از نظر قدرت اجرایی کاملاً هم ارز با تگ Meta Robots عمل می کند و بر شاخص قابلیت ایندکس فایل های رسانه ای و اسناد دانلودی نظارت کامل دارد.
تشریح فنی دستورات کلیدی تگ ربات (Directives)
دستورات متعددی برای کنترل رفتار موتورهای جستجو در این پروتکل وجود دارد، اما چهار مفهوم اصلی، شالوده تصمیم گیری های تکنیکال را تشکیل می دهند.
دستور index در برابر noindex: مرز ورود به پایگاه داده گوگل
دستور index به موتور جستجو اعلام می کند که مجاز است این صفحه را بررسی، تحلیل و در پایگاه داده نتایج جستجو ذخیره کند. از آنجا که حالت پیش فرض (Default) تمام صفحات وب از نظر گوگل index است، معمولاً نیازی به نوشتن دستی این دستور وجود ندارد، مگر اینکه بخواهید دستوری از پیش تعیین شده را لغو کنید.
در مقابل، دستور noindex صریح ترین فرمان برای ممانعت از نمایش صفحه در نتایج است. زمانی که Googlebot این دستور را در صفحه مشاهده کند، صفحه را به طور کامل از چرخه نمایش به کاربران خارج می سازد؛ حتی اگر آن صفحه محتوای جامعی داشته باشد یا پیوندهای خارجی معتبری دریافت کرده باشد.
دستور follow در برابر nofollow: کنترل جریان لینک ها در سطح صفحه
دستور follow به ربات اعلام می کند که می تواند پیوندهای موجود در این صفحه را دنبال کند و اعتبار (PageRank) را در ساختار سایت به گردش درآورد. این حالت نیز وضعیت پیش فرض وب است.
دستور nofollow در تگ متای ربات، به این معناست که خزنده ها نباید هیچ یک از پیوندهای قرار گرفته در این صفحه را دنبال کنند یا اعتباری به صفحات مقصد منتقل سازند. برای درک عمیق تر تفاوت میان پیوندهای دنبال شونده و مسدود، مطالعه راهنمای اختصاصی لینک داخلی فالو و نوفالو زوایای بیشتری از این موضوع را روشن می کند.
ترکیب های چهارگانه متداول و کاربرد عملی آن ها
از کنار هم قرار گرفتن این دستورات، چهار سناریوی عملیاتی شکل می گیرد:
- index, follow (وضعیت عادی): صفحه در نتایج جستجو نمایش داده می شود و لینک های آن نیز خزش شده و اعتبار را منتقل می کنند. اگر هیچ تگی ننویسید، این حالت به صورت خودکار اعمال می شود.
- noindex, follow (عدم نمایش صفحه، حفظ جریان پیوندها): صفحه نباید در نتایج جستجو ایندکس شود، اما پیوندهای موجود در آن همچنان معتبر هستند و ربات می تواند از طریق آن ها سایر بخش های سایت را پیدا کند. این ترکیب برای صفحات آرشیو، دسته بندی های تکراری و صفحات صفحه بندی (Pagination) کاربرد فراوان دارد.
- noindex, nofollow (قطع دسترسی و ارتباط کامل): نه صفحه باید در نتایج ظاهر شود و نه لینک های آن ارزشی برای خزش و توزیع اعتبار دارند. این گزینه برای صفحات مدیریت، پنل ورود کاربران و بخش های محرمانه سیستم ایده آل است.
- index, nofollow (نمایش صفحه بدون انتقال اعتبار پیوندها): صفحه در نتایج گوگل ایندکس می شود، اما هیچ کدام از لینک های خروجی آن توسط ربات دنبال نخواهند شد. این سناریو به ندرت استفاده می شود و معمولاً در صفحاتی با لینک های متعدد تولیدشده توسط کاربر (UGC) کاربرد دارد.
سرنوشت دستور noindex, follow در درازمدت بر اساس پاسخ های رسمی گوگل
جان مولر (از مدیران و سخنگویان ارشد گوگل) در بیانیه های متعدد تأیید کرده است که اگر دستوری به صورت noindex, follow برای مدتی طولانی روی یک صفحه فعال بماند، سیستم های گوگل پس از اطمینان از حذف دائمی صفحه از ایندکس، خزش لینک های درون آن را به شدت کاهش داده و در نهایت با آن دقیقاً مانند یک دستور noindex, nofollow رفتار خواهند کرد. بنابراین، نباید از یک صفحه Noindex شده به عنوان تنها کانال برای رساندن بات به صفحات کلیدی سایت استفاده کرد.
فرامین پیشرفته کنترل نمایش در نتایج (SERP Snippets Directives)
علاوه بر دوگانه ایندکس و فالو، استانداردهای مدرن سئو امکان کنترل نحوه نمایش اسنیپت ها در موتورهای جستجو را فراهم آورده اند:
- nosnippet: از نمایش هرگونه توضیح متنی (Meta Description) یا پیش نمایش متنی در صفحه نتایج جلوگیری می کند.
- max-snippet:[number]: حداکثر تعداد کاراکترهای مجاز برای نمایش در اسنیپت متنی نتایج را تعیین می کند (مثلاً
max-snippet:150). مقدار صفر معادل nosnippet خواهد بود. - max-image-preview:[size]: ابعاد تصویر پیش نمایش در نتایج جستجو و به ویژه فید Google Discover را مشخص می کند. مقادیر معتبر آن
none،standardیاlargeهستند. تنظیم این دستور رویmax-image-preview:largeتوصیه رسمی گوگل برای افزایش نرخ کلیک و حضور مؤثر در گوگل دیسکاور است. - noarchive: مانع از ذخیره نسخه کش شده (Cached page) توسط موتورهای جستجو می شود.
- noimageindex: مانع از ایندکس شدن تصاویر موجود در این صفحه درون بخش جستجوی تصاویر گوگل (Google Images) می گردد؛ با این توضیح که اگر همان تصویر در صفحه دیگری بدون این تگ استفاده شده باشد، ممکن است همچنان ایندکس شود. برای بررسی جزئیات این تمایز، راهنمای سئو تصاویر نکات تکمیلی را بررسی کرده است.
تفاوت های بنیادین که نباید اشتباه گرفته شوند
تداخل مفاهیم تکنیکال اغلب زمینه ساز اشتباهات پرهزینه می شود. تفکیک دقیق مرزهای عملیاتی دو بخش زیر برای هر کارشناس سئو الزامی است.
تفاوت Meta Robots با فایل Robots.txt (خزش در برابر ایندکس)
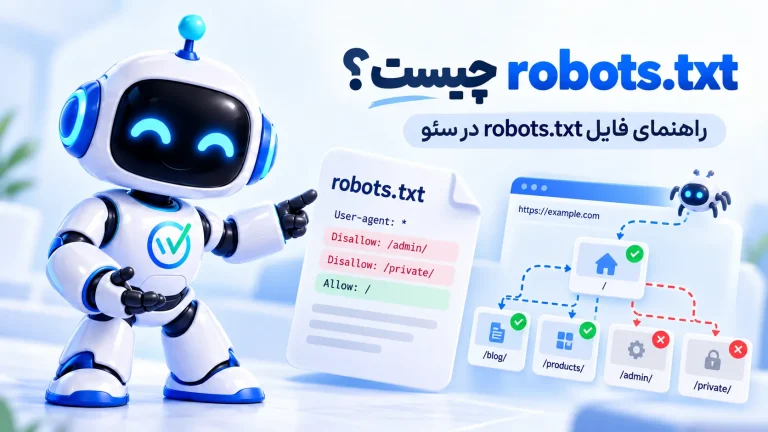
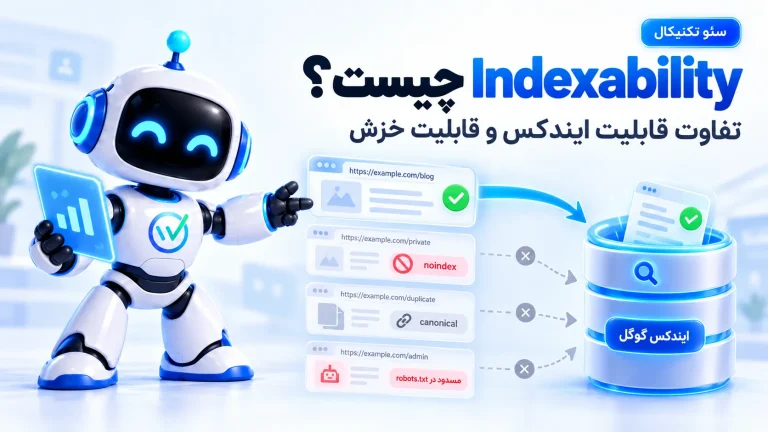
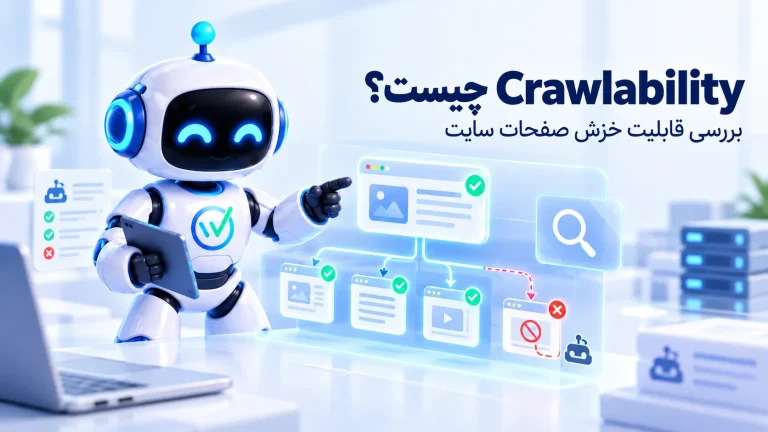
برای مسلط شدن بر این مبحث، درک زنجیره تفاوت خزش، ایندکس و رتبه بندی حیاتی است. فایل متنی Robots.txt در بالاترین سطح بر شاخص قابلیت خزش (Crawlability) نظارت می کند و مانع از دانلود منابع توسط سرور می شود. در حالی که تگ Meta Robots کنترل مرحله ایندکس را در دست دارد. اگر صفحه ای در robots.txt مسدود شود، ربات نمی تواند کدهای HTML آن را بخواند؛ بنابراین هرگز تگ noindex موجود در صفحه را نخواهد دید!
تفاوت Page-level Nofollow با Link-level Nofollow
وقتی در تگ Meta Robots عبارت nofollow قرار می گیرد، این دستور به شکل سراسری بر تمام پیوندهای داخل صفحه اعمال می شود. اما ویژگی rel="nofollow" که درون تگ پیوند (<a>) درج می شود، رفتاری گزینشی دارد و صرفاً ارزش و اعتبار همان یک پیوند خاص را کنترل می نماید، بدون اینکه تأثیری بر سایر لینک های داخلی صفحه داشته باشد.
سناریوهای کاربردی: چه صفحاتی را باید Noindex کنیم؟
استفاده هوشمندانه از دستور noindex مانع از رقیق شدن اعتبار دامنه و اتلاف منابع ایندکسینگ می شود. این صفحات معمولاً در ۳ دسته قرار می گیرند:
۱. صفحات مدیریتی و حساب های کاربری
صفحاتی مانند لاگین، سبد خرید، صفحه نهایی تسویه حساب (Checkout)، پروفایل کاربری و داشبوردها اختصاصاً برای هر کاربر تولید می شوند. این صفحات فاقد بار معنایی عمومی هستند و قرارگیری آن ها در پایگاه داده گوگل تنها نمونه ای از محتوای ضعیف (Thin Content) به حساب می آید که ارزش ارگانیک ندارد.
۲. نتایج جستجوی داخلی و فیلترهای بدون تقاضا
موتورهای جستجو به صراحت در دستورالعمل های وبمستر اعلام کرده اند که صفحات جستجوی داخلی نباید ایندکس شوند. باز ماندن این صفحات می تواند میلیون ها آدرس بی فایده و آلوده به هرزنامه (Search Spam) ایجاد کند. همچنین فیلترهای محصولی پیچیده ای که تقاضای جستجوی هدفمندی ندارند، برای جلوگیری از ایجاد محتوای تکراری باید به دستور noindex تجهیز شوند.
۳. لندینگ های تبلیغات پولی (PPC / Google Ads)
صفحاتی که اختصاصاً برای کمپین های تبلیغاتی با رویکرد تبدیل مستقیم طراحی می شوند، اغلب دارای محتوای بسیار کوتاه یا کپی از صفحات اصلی هستند. برای حفظ ساختار پاک سئو و پیشگیری از هم نوع خواری با لندینگ پیج های ارگانیک، بهتر است از تگ noindex در آن ها استفاده شود.
۳ خطای فاجعه بار در تنظیم Meta Robots که ترافیک سایت را نابود می کند
تجربه پروژه های متعدد نشان داده است که بزرگ ترین آسیب های تکنیکال معمولاً ناشی از بی توجهی به این ۳ سناریوی خطرناک است:
۱. مسدود کردن هم زمان در robots.txt و درج دستور noindex
این مورد یکی از رایج ترین اشتباهات است. وبمستر برای حذف یک صفحه از نتایج، هم زمان آدرس آن را در robots.txt دیس الاو (Disallow) کرده و در کدهای صفحه تگ noindex قرار می دهد. نتیجه معکوس خواهد بود: خزشگر به دلیل مسدود بودن مسیر در robots.txt، صفحه را دانلود نمی کند، متوجه تگ noindex نمی شود و بر اساس انکرتکست های لینک های ورودی به صفحه، آن را با عنوان بدون توضیحات در نتایج نمایش می دهد! برای حذف قطعی صفحه از ایندکس، دسترسی آن در robots.txt باید باز باشد تا گوگل کدهای صفحه را خوانده و دستور noindex را پردازش کند.
۲. تضاد میان تگ کنونیکال و متاتگ noindex
تگ Canonical اعلام می کند: «این صفحه نسخه اصلی است یا به صفحه اصلی دیگری متصل است»، در حالی که دستور noindex اعلام می کند: «این صفحه نباید ایندکس شود». ارسال این دو سیگنال متضاد سیستم تصمیم گیری موتور جستجو را مختل کرده و ممکن است گوگل هر دو سیگنال را نادیده بگیرد یا صفحه هدف کنونیکال را نیز از اعتبار ساقط کند.
۳. فراموش شدن تگ noindex پس از انتقال از محیط تست (Staging)
در زمان توسعه وب سایت، طراحان معمولاً تگ noindex را روی کل سایت تستی فعال می کنند تا نسخه های ناقص ایندکس نشوند. بارها مشاهده شده که پس از لانچ نسخه نهایی و انتقال دیتابیس به دامنه اصلی، فراموشی در غیرفعال سازی این تگ، باعث دی ایندکس شدن کل وب سایت در کمتر از یک هفته شده است.
جدول ماتریس تصمیم گیری و ارزیابی سلامت تگ های ربات
برای تعیین صحیح کدهای دستوری در هر بخش از وب سایت، جدول راهنمای زیر چارچوب تصمیم گیری استاندارد را در اختیار شما قرار می دهد:
| نوع صفحه / بخش وب سایت | کد متای پیشنهادی | وضعیت در Robots.txt | هدف سئو و پیامد مورد انتظار |
|---|---|---|---|
| مقالات بلاگ، صفحات خدمات و محصولات | index, follow, max-image-preview:large |
کاملاً باز (Allow) | نمایه سازی کامل، بهینه سازی حضور در دیسکاور و ارتقای رتبه |
| دسته بندی های صفحه بندی شده (Pagination) | noindex, follow (یا ایندکس بدون تگ) |
کاملاً باز (Allow) | جلوگیری از رقابت با صفحه اصلی دسته و هدایت کامل لینک ها به مقالات |
| پنل کاربری، سبد خرید، صفحه ورود | noindex, nofollow |
ترجیحاً باز برای درک noindex (یا مسدودسازی آدرس) | پاک سازی کامل داده های اختصاصی کاربر از موتورهای جستجو |
| کاتالوگ های پی دی اف داخلی و اسناد | X-Robots-Tag: noindex |
کاملاً باز (Allow) | حذف اسناد غیرضروری از نتایج جستجو و حفظ ساختار سایت |
| صفحات لندینگ تست A/B و کمپین های کلیکی | noindex, follow |
کاملاً باز (Allow) | ممانعت از ایجاد محتوای تکراری و تضعیف لندینگ های ارگانیک |

اولین دیدگاه را بنویسید