

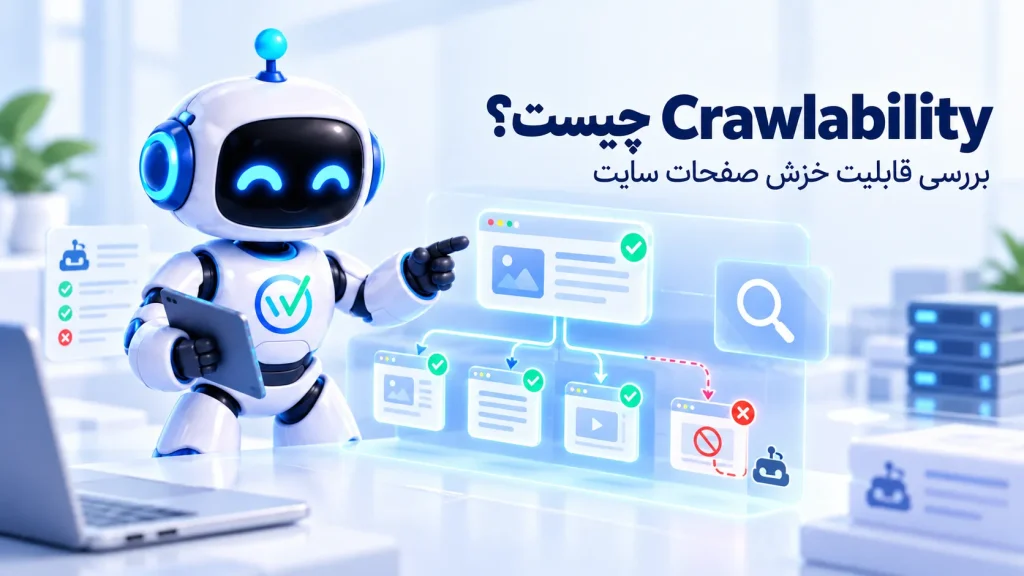
ممکن است یک URL در سایت وجود داشته باشد، در Sitemap هم قرار گرفته باشد و حتی از چند صفحه دیگر به آن لینک داده باشید، اما Googlebot نتواند محتوای آن را Crawl کند.
در چنین شرایطی با مسئله Crawlability یا قابلیت خزش روبه رو هستیم.
Crawlability مشخص می کند آیا Crawler موتور جستجو می تواند به یک URL دسترسی پیدا کند، درخواست HTTP برای آن ارسال کند و پاسخ مورد نیاز را دریافت کند یا نه.
مشکلاتی مثل دستور اشتباه در robots.txt، خطای Server، محدودیت Firewall، ساختار نامناسب لینک ها، Authentication، Redirectهای خراب و بعضی مشکلات JavaScript می توانند باعث شوند Google نتواند صفحات مهم سایت را به شکل مورد انتظار Crawl کند.
در این راهنما بررسی می کنیم Crawlability چیست، چه تفاوتی با Crawling و Indexability دارد و چگونه قابلیت خزش صفحات سایت را مرحله به مرحله بررسی کنیم.
Crawlability چیست؟
Crawlability یا قابلیت خزش به توانایی Crawler برای دسترسی و دریافت یک URL گفته می شود.
اگر Googlebot بتواند URL را پیدا کند، اجازه درخواست آن را داشته باشد و Server نیز پاسخ قابل استفاده ای برگرداند، از نظر پایه آن URL قابلیت Crawl شدن دارد.
برای مثال فرض کنید URL زیر را داریم:
https://example.com/technical-seo/
برای اینکه Googlebot بتواند آن را Crawl کند، چند شرط باید برقرار باشد:
- Google باید از وجود URL باخبر شود؛
- robots.txt نباید دسترسی Googlebot را مسدود کرده باشد؛
- URL نباید پشت Login یا محدودیت دسترسی قرار گرفته باشد؛
- Server باید در دسترس باشد؛
- DNS و شبکه باید درست کار کنند؛
- پاسخ HTTP نباید مانع دسترسی Crawler شود.
Crawlability یکی از پیش نیازهای مهم برای پردازش محتوای صفحه است، اما قابل Crawl بودن یک URL به معنی Index شدن یا رتبه گرفتن آن نیست.
Crawlability با Crawling چه تفاوتی دارد؟
این دو مفهوم نزدیک هستند اما یکی نیستند.
Crawling خود فرایندی است که Crawler در آن URL را درخواست و محتوای آن را بررسی می کند.
Crawlability شرایطی است که مشخص می کند این Crawl اصلا امکان پذیر است یا نه.
به زبان ساده:
Crawlability = آیا امکان خزش وجود دارد؟
Crawling = عمل خزش انجام شده است.
برای مثال یک صفحه ممکن است از نظر فنی کاملا قابل Crawl باشد، اما Google هنوز به آن URL سر نزده باشد.
اگر می خواهید خود فرایند Crawling را دقیق تر بشناسید، راهنمای خزش Google چیست؟ را مطالعه کنید.
Crawlability با Discoverability چه تفاوتی دارد؟
قبل از اینکه Crawler بتواند URL را درخواست کند، ابتدا باید از وجود آن باخبر شود.
به این مرحله معمولا Discovery یا کشف URL گفته می شود.
Google می تواند URLها را از مسیرهایی مثل این موارد پیدا کند:
- لینک های داخلی؛
- لینک های خارجی؛
- XML Sitemap؛
- Redirectها؛
- URLهایی که قبلا شناخته است.
پس ممکن است یک صفحه:
- قابل Crawl باشد ولی هنوز کشف نشده باشد؛
- کشف شده باشد ولی Crawl آن توسط robots.txt مسدود شده باشد؛
- کشف و Crawl شده باشد ولی Index نشود.
این سه وضعیت را نباید با هم اشتباه گرفت.
Crawlability با Indexability چه تفاوتی دارد؟
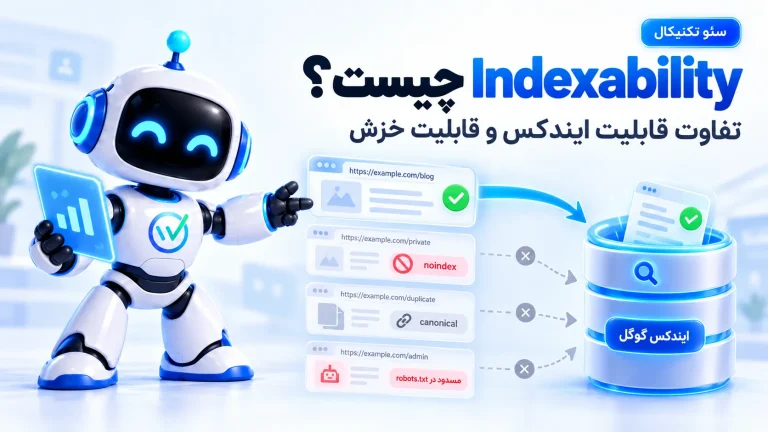
یکی از مهم ترین تمایزها در Technical SEO تفاوت میان قابلیت Crawl و قابلیت Index است.
صفحه ممکن است کاملا قابل Crawl باشد ولی اجازه Index شدن نداشته باشد.
مثلا:
<meta name="robots" content="noindex">
در این حالت Google باید بتواند صفحه را Crawl کند تا دستور noindex را ببیند.
برعکس، اگر URL را در robots.txt مسدود کنیم، Google ممکن است نتواند محتوای صفحه و Meta Robots آن را مشاهده کند.
| وضعیت | Crawl | Index |
|---|---|---|
| صفحه عادی | مجاز | ممکن است Index شود |
| robots.txt Disallow | مسدود | URL ممکن است همچنان شناخته شود |
| Meta Robots noindex | مجاز | Index نباید شود |
| صفحه پشت Login | عملا محدود | معمولا قابل Index نیست |
Google نیز تاکید می کند که robots.txt ابزار جلوگیری از Index شدن صفحه نیست.
راهنمای رسمی Google درباره robots.txt
آیا صفحه مسدود شده در robots.txt می تواند در Google دیده شود؟
بله، در بعضی شرایط URL آن می تواند شناخته و حتی در نتایج ظاهر شود.
Google توضیح می دهد اگر URL از جاهای دیگر لینک دریافت کرده باشد، ممکن است URL را بدون Crawl کردن محتوای آن بشناسد.
در چنین حالتی ممکن است Google خود URL و اطلاعات محدودی را نمایش دهد، حتی اگر اجازه Crawl صفحه را نداشته باشد.
بنابراین این تصور اشتباه است:
Disallow = حذف صفحه از Google
اگر هدف جلوگیری از Index شدن است، باید از روش مناسب همان هدف مثل noindex استفاده شود و Google نیز باید بتواند صفحه را Crawl کند تا دستور را مشاهده کند.
چه چیزهایی Crawlability را تحت تاثیر قرار می دهند؟
قابلیت خزش فقط به robots.txt وابسته نیست.
چند لایه مختلف می توانند باعث شوند Googlebot نتواند URL را به درستی دریافت کند.
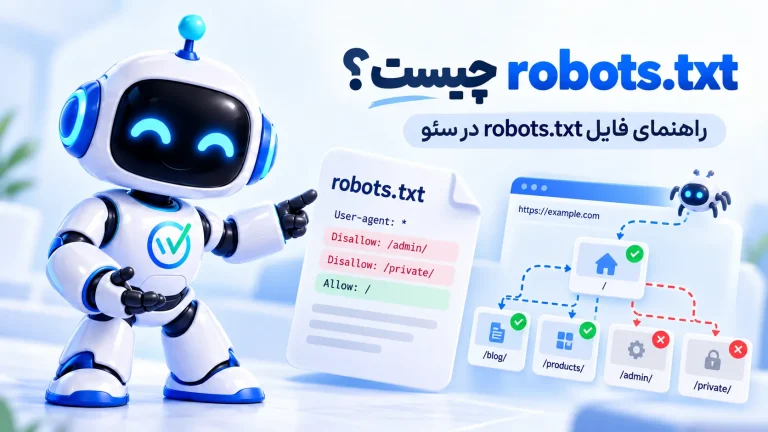
1. robots.txt
یکی از واضح ترین موارد، دستورهای فایل robots.txt است.
برای مثال:
User-agent: *
Disallow: /private/
این دستور به Crawlerهای مشمول قانون اعلام می کند مسیر /private/ را درخواست نکنند.
مشکل معمولا زمانی رخ می دهد که یک قانون گسترده به اشتباه صفحات مهم را نیز پوشش دهد.
2. خطاهای Server
اگر Server در زمان درخواست Googlebot نتواند پاسخ مناسبی بدهد، Crawl ممکن است با مشکل روبه رو شود.
نمونه های مهم:
- 500 Internal Server Error؛
- 502 Bad Gateway؛
- 503 Service Unavailable؛
- 504 Gateway Timeout.
اگر این خطاها موقت و محدود باشند ممکن است Google بعدا دوباره تلاش کند، اما خطاهای گسترده یا طولانی مدت می توانند Crawl سایت را مختل کنند.
3. مشکلات DNS و شبکه
گاهی مشکل قبل از رسیدن درخواست به WordPress یا CMS رخ می دهد.
برای مثال:
- DNS اشتباه؛
- Timeout شبکه؛
- مشکل CDN؛
- اختلال Hosting؛
- پیکربندی نادرست Proxy.
در این حالت ممکن است Browser شما در بعضی زمان ها سایت را باز کند ولی Googlebot در Crawlهای خودش با خطا مواجه شود.
4. Firewall و سیستم های امنیتی
WAF، Firewall، CDN یا افزونه امنیتی ممکن است درخواست های Googlebot را مسدود کنند.
مثلا سیستم امنیتی ممکن است براساس تعداد Requestها، IP یا User-Agent دسترسی را ببندد.
یک نکته مهم این است که فقط دیدن عبارت Googlebot در User-Agent کافی نیست، چون User-Agent قابل جعل است.
Google برای تشخیص Googlebot واقعی روش های تایید IP و Reverse DNS ارائه کرده است.
5. Authentication
صفحه ای که فقط بعد از ورود کاربر قابل مشاهده است معمولا برای Googlebot نیز قابل دسترسی عمومی نیست.
مثلا:
- صفحه حساب کاربری؛
- پنل مدیریت؛
- بخش داخلی مشتریان؛
- محتوای Password Protected.
این وضعیت لزوما مشکل سئو نیست. بعضی صفحات نباید Crawl یا Index شوند.
6. ساختار URL نامناسب
URLهایی که به شکل بی نهایت یا غیرقابل کنترل تولید می شوند می توانند Crawl سایت را پیچیده کنند.
نمونه رایج:
/products/?color=blue&size=large&sort=price
اگر هر ترکیب پارامتر URL تازه ای ایجاد کند، Crawler ممکن است با تعداد بسیار زیادی URL روبه رو شود.
Google توصیه می کند ساختار URL قابل Crawl و قابل مدیریت باشد.
7. لینک های غیرقابل Crawl
Google معمولا لینک هایی را به شکل قابل اتکا استخراج می کند که از ساختار استاندارد:
<a href="...">
استفاده کنند.
برای مثال این ساختار مناسب است:
<a href="/services/">خدمات</a>
اما اگر Navigation فقط با یک Event جاوا اسکریپت ساخته شود و URL واقعی داخل href وجود نداشته باشد، کشف صفحات می تواند ضعیف تر شود.
راهنمای Google درباره لینک های قابل Crawl
آیا نبود لینک داخلی باعث Non-Crawlable شدن صفحه می شود؟
از نظر دقیق فنی، نه لزوما.
اگر URL را مستقیم به Google بدهید یا در Sitemap قرار داشته باشد، Server همچنان ممکن است اجازه Crawl آن را بدهد.
اما نبود لینک داخلی می تواند کشف URL و مسیر طبیعی Crawl را ضعیف کند.
به همین دلیل بهتر است میان دو مفهوم تفاوت قائل شویم:
URL قابل Crawl است
با:
Google مسیر مناسبی برای پیدا کردن URL دارد
یک صفحه یتیم ممکن است از نظر Server کاملا Crawlable باشد ولی در معماری داخلی سایت مسیر مناسبی برای Discovery نداشته باشد.
آیا Sitemap مشکل Crawlability را حل می کند؟
خیر.
Sitemap می تواند به Google درباره وجود URL اطلاع دهد، اما محدودیت فنی آن URL را برطرف نمی کند.
مثلا اگر URL:
- در robots.txt مسدود باشد؛
- Server Error داشته باشد؛
- نیاز به Login داشته باشد؛
- یا Redirect خراب داشته باشد؛
قرار دادن آن در Sitemap مشکل را حل نمی کند.
پس Sitemap بیشتر ابزار Discovery است، نه ابزاری برای اجبار Google به Crawl.
Status Code مناسب برای صفحه Crawlable چیست؟
اگر می خواهید محتوای همان URL پردازش شود، معمولا انتظار داریم URL پاسخ موفق از گروه 2xx و در اغلب صفحات عادی 200 برگرداند.
Google توضیح می دهد پاسخ موفق 2xx می تواند وارد مرحله بعدی پردازش شود، اما حتی پاسخ 200 نیز Index شدن را تضمین نمی کند.
اگر صفحه Redirect باشد، Google با رفتار متفاوتی روبه رو می شود.
مثلا:
/old-page/ → 301 → /new-page/
Google می تواند Redirect را دنبال کند، اما محتوایی که قرار است پردازش شود در مقصد قرار دارد.
راهنمای Google درباره HTTP Status Codeها
آیا 404 یک مشکل Crawlability است؟
بستگی دارد.
اگر URL واقعا حذف شده است، پاسخ 404 می تواند کاملا صحیح باشد.
اما اگر صفحه مهمی باید در دسترس باشد و به اشتباه 404 می دهد، آن صفحه عملا محتوای مورد انتظار را برای Crawler ارائه نمی کند.
مشکل بزرگ تر زمانی است که لینک های داخلی سایت همچنان کاربران و Crawlerها را به URLهای 404 هدایت کنند.
Redirect Chain چه تاثیری بر Crawl دارد؟
Redirect Chain یعنی Crawler قبل از رسیدن به مقصد نهایی چند انتقال را دنبال کند:
A → B → C → D
وجود یک Redirect معمولی مسئله عجیبی نیست، اما Chainهای طولانی:
- ساختار سایت را پیچیده می کنند؛
- زمان رسیدن به مقصد را افزایش می دهند؛
- Debug را سخت می کنند؛
- و احتمال خراب شدن مسیر را افزایش می دهند.
اگر مقصد نهایی از قبل مشخص است، بهتر است لینک های داخلی مستقیما به همان URL اشاره کنند.
JavaScript چه تاثیری روی Crawlability دارد؟
در سایت های JavaScript محور باید بین Crawl اولیه و Rendering تفاوت قائل شویم.
Google ابتدا URL را درخواست می کند و بعد ممکن است صفحه را Render کند.
اگر منابع ضروری JavaScript توسط robots.txt مسدود شده باشند یا اجرای Script با خطا روبه رو شود، ممکن است Google نسخه ناقصی از صفحه را مشاهده کند.
همچنین لینک هایی که با JavaScript ساخته می شوند بهتر است در DOM نهایی همچنان به شکل استاندارد <a href> باشند.
پس برای سایت های JavaScript محور فقط Source اولیه را بررسی نکنید؛ Render نهایی صفحه نیز اهمیت دارد.
چگونه Crawlability یک URL را بررسی کنیم؟
برای بررسی یک URL بهتر است از ساده ترین لایه شروع کنیم و مرحله به مرحله جلو برویم.
مرحله 1: URL را مستقیم باز کنید
ابتدا بررسی کنید صفحه برای کاربر عادی باز می شود یا نه.
اگر Browser نیز نتواند URL را باز کند، احتمالا قبل از رسیدن به مسائل SEO یک مشکل عمومی دسترسی وجود دارد.
مرحله 2: Status Code را بررسی کنید
ببینید Server چه پاسخی برمی گرداند.
می توانید از ابزارهای HTTP Checker، DevTools یا دستورهایی مثل:
curl -I https://example.com/page/
استفاده کنید.
برای صفحه عادی معمولا انتظار داریم پاسخ نهایی 200 باشد.
مرحله 3: robots.txt را بررسی کنید
فایل معمولا در این مسیر قرار دارد:
https://example.com/robots.txt
ببینید آیا User-Agent مربوط به Googlebot یا قانون عمومی * مسیر صفحه را مسدود کرده است.
مثلا:
Disallow: /blog/
اگر مقاله مهم شما داخل /blog/ باشد، این قانون نیاز به بررسی دارد.
مرحله 4: URL Inspection را اجرا کنید
در Google Search Console URL را وارد کنید و Test Live URL را اجرا کنید.
در بخش Availability یا Page Indexing مواردی مثل این ها را بررسی کنید:
- Crawl allowed?
- Page fetch
- HTTP response
- Rendered page
- Indexing allowed?
مهم است بدانید Live Test تضمین نمی کند URL Index خواهد شد؛ این ابزار فقط بخشی از شرایط فنی دسترسی و Indexability را بررسی می کند.
راهنمای URL Inspection در Google Search Console
مرحله 5: لینک های داخلی را بررسی کنید
مشخص کنید Google از چه مسیرهایی می تواند URL را پیدا کند.
سوال های مهم:
- آیا حداقل یک صفحه داخلی به این URL لینک دارد؟
- لینک با
<a href>ساخته شده؟ - URL لینک مستقیما به مقصد نهایی می رود؟
- لینک فقط در نسخه دسکتاپ وجود ندارد؟
- Navigation موبایل نیز آن را حفظ کرده است؟
مرحله 6: Sitemap را بررسی کنید
اگر URL مهم و قابل Index است، بررسی کنید آیا در Sitemap مناسب قرار دارد.
اما وجود URL در Sitemap را به عنوان اثبات Crawlability در نظر نگیرید.
مرحله 7: Render صفحه را بررسی کنید
اگر سایت از JavaScript سنگین استفاده می کند، Render نهایی را در URL Inspection یا Browser DevTools مشاهده کنید.
بررسی کنید:
- محتوای اصلی نمایش داده می شود؟
- لینک های مهم وجود دارند؟
- Canonical درست است؟
- Meta Robots نهایی صحیح است؟
- Script Error وجود ندارد؟
مرحله 8: Log Server را بررسی کنید
اگر نیاز دارید بدانید Googlebot واقعا چه زمانی و چند بار URL را درخواست کرده، Server Log یکی از دقیق ترین منابع است.
از Log می توان فهمید:
- Googlebot چه URLهایی را درخواست کرده؛
- چه Status Codeهایی دریافت کرده؛
- کدام بخش ها بیشتر Crawl می شوند؛
- چه URLهایی مدت زیادی Crawl نشده اند.
برای سایت های کوچک همیشه لازم نیست از Log Analysis شروع کنید، اما در مسائل پیچیده بسیار مفید است.
چگونه Crawlability کل سایت را بررسی کنیم؟
بررسی تک تک URLها برای سایت بزرگ عملی نیست.
برای Audit کل سایت معمولا یک Crawler مثل Screaming Frog استفاده می شود.
بعد از Crawl می توانید موارد زیر را استخراج کنید:
- URLهای Blocked by robots.txt؛
- 4xx؛
- 5xx؛
- Redirectها؛
- Redirect Chainها؛
- صفحاتی که لینک داخلی ندارند؛
- صفحاتی با Crawl Depth زیاد؛
- Canonicalهای ناسازگار؛
- لینک های غیرقابل دسترس.
اما یک نکته مهم وجود دارد:
Crawler سایت رفتار Googlebot را شبیه سازی می کند؛ خودش Googlebot نیست.
پس برای مسائل مهم بهتر است داده Crawler را با Search Console و در صورت نیاز Server Log مقایسه کنید.
اگر Screaming Frog نتواند صفحه را Crawl کند یعنی Google هم نمی تواند؟
نه همیشه.
ممکن است تنظیم User-Agent ابزار متفاوت باشد یا Firewall رفتار متفاوتی با Botها داشته باشد.
همچنین ممکن است JavaScript Rendering در Crawl خاموش باشد.
بنابراین نتیجه Crawler یک سرنخ مهم است، نه حکم نهایی.
برای URLهای مهم نتیجه را با URL Inspection بررسی کنید.
چگونه بفهمیم robots.txt عامل مشکل است؟
اگر URL Inspection مقدار:
Crawl allowed? No
نشان دهد، یکی از اولین مواردی که باید بررسی شود robots.txt است.
سپس مسیر URL را با Ruleها مقایسه کنید.
مثلا:
Disallow: /category/
ممکن است به صورت ناخواسته تمام صفحات مهم داخل آن مسیر را مسدود کرده باشد.
بعد از اصلاح robots.txt نیز باید اجازه دهید Google نسخه جدید فایل را مشاهده و پردازش کند.
اگر Crawl allowed باشد ولی Page fetch شکست بخورد چه؟
در این حالت مشکل احتمالا دیگر robots.txt نیست.
باید مواردی مثل این ها بررسی شوند:
- 5xx؛
- DNS؛
- Timeout؛
- Firewall؛
- CDN؛
- محدودیت Rate Limit؛
- Redirect خراب.
این تفکیک در Debug بسیار مهم است:
اجازه Crawl وجود دارد
الزاما به معنی:
Google توانسته صفحه را دریافت کند
نیست.
آیا noindex باعث کاهش Crawlability می شود؟
به صورت مستقیم نه.
noindex دستور Indexing است، نه Crawling.
Google می تواند صفحه noindex را Crawl کند.
اتفاقا برای مشاهده Meta Robots noindex باید بتواند محتوای صفحه را دریافت کند.
پس در Audit بهتر است دو ستون مستقل داشته باشید:
Crawl Allowed
Index Allowed
Canonical باعث جلوگیری از Crawl می شود؟
خیر.
Canonical نیز مکانیزم مسدود کردن Crawl نیست.
اگر صفحه A به B Canonical باشد، Google ممکن است همچنان A را Crawl کند تا محتوای آن و سیگنال های Canonicalization را بررسی کند.
پس استفاده از Canonical برای جلوگیری از Crawl کردن تعداد زیادی URL راه حل مستقیم این مسئله نیست.
Nofollow همان جلوگیری از Crawl است؟
خیر.
قرار دادن nofollow روی یک لینک به معنی ایجاد یک Firewall برای URL مقصد نیست.
Google ممکن است URL مقصد را از مسیرهای دیگری مثل Sitemap، لینک دیگر یا سابقه Crawl بشناسد.
پس Nofollow ابزار مطمئن برای جلوگیری از Crawl یک URL نیست.
آیا Crawlability یک Ranking Factor است؟
بهتر است Crawlability را یک امتیاز مستقل رتبه بندی در نظر نگیریم.
اگر Google نتواند محتوای یک صفحه را دریافت کند، ممکن است اساسا امکان پردازش معمول آن صفحه فراهم نشود.
بنابراین Crawlability بیشتر یک پیش نیاز فنی است تا چیزی شبیه امتیاز مستقلی که هرچه بالاتر باشد رتبه بهتر شود.
هدف این نیست که تمام URLهای سایت را برای Google قابل Crawl کنیم؛ هدف این است که URLهایی که باید در Search حضور داشته باشند مانع فنی نداشته باشند.
آیا همه URLهای سایت باید Crawlable باشند؟
خیر.
بعضی URLها ممکن است عمدا نیاز به Crawl نداشته باشند.
مثلا:
- بخش های مدیریتی؛
- URLهای بی نهایت فیلتر؛
- بعضی Endpointهای داخلی؛
- منابعی که برای Search ارزشی ندارند.
هدف Technical SEO باز کردن تمام درها برای Crawler نیست.
هدف مدیریت منطقی دسترسی است.
Crawlability در سایت های کوچک و بزرگ چه تفاوتی دارد؟
در سایت کوچک معمولا مشکلات Crawlability بیشتر به شکل خطای واضح دیده می شوند:
- robots.txt اشتباه؛
- 404؛
- 5xx؛
- صفحه یتیم؛
- Navigation خراب.
در سایت های بزرگ مسائل دیگری نیز اهمیت پیدا می کنند:
- Faceted Navigation؛
- پارامترها؛
- تعداد بسیار زیاد URL؛
- Crawl Efficiency؛
- Server Load؛
- Log File Analysis.
به همین دلیل نباید مشکلات یک فروشگاه چند میلیون URLی را به یک سایت 200 صفحه ای تعمیم داد.
Crawlability در موبایل را جدا بررسی کنیم؟
اگر Navigation یا محتوای نسخه موبایل با دسکتاپ تفاوت دارد، بله.
Google عمدتا نسخه موبایل سایت را برای Indexing پردازش می کند.
اگر لینک مهمی فقط در Desktop وجود داشته باشد ولی در نسخه موبایل حذف شده باشد، Discovery صفحات می تواند تحت تاثیر قرار بگیرد.
در Audit Responsive بررسی کنید لینک های مهم و محتوای اصلی در موبایل نیز باقی مانده باشند.
نشانه های احتمالی مشکل Crawlability چیست؟
موارد زیر می توانند نشانه باشند، اما هرکدام نیاز به بررسی دقیق دارند:
- URL Inspection خطای Page Fetch نشان می دهد؛
- Crawl allowed روی No قرار دارد؛
- تعداد زیادی URL در Crawler با Blocked by robots.txt دیده می شوند؛
- 5xx افزایش پیدا کرده؛
- Googlebot در Server Log به صفحات مهم نمی رسد؛
- صفحات مهم هیچ لینک داخلی ندارند؛
- URLها در Redirect Loop گرفتار شده اند؛
- Navigation جاوا اسکریپتی URL واقعی تولید نمی کند؛
- CDN یا Firewall درخواست Bot را رد می کند.
اگر یک صفحه Crawl نمی شود از کجا شروع کنیم؟
برای Debug سریع این ترتیب را پیشنهاد می کنیم:
- URL را در Browser باز کنید.
- Status Code را بررسی کنید.
- robots.txt را بررسی کنید.
- URL Inspection را اجرا کنید.
- Live Test را ببینید.
- لینک های داخلی به URL را بررسی کنید.
- Redirectها را بررسی کنید.
- در صورت JavaScript محور بودن، Render نهایی را ببینید.
- Firewall و CDN را بررسی کنید.
- در مسائل پیچیده Server Log را تحلیل کنید.
این ترتیب کمک می کند قبل از رفتن سراغ تحلیل های پیچیده، خطاهای ساده و رایج پیدا شوند.
چک لیست Crawlability
- □ URL مهم در Browser قابل دسترسی است.
- □ پاسخ HTTP نهایی صحیح است.
- □ Server خطای 5xx نمی دهد.
- □ robots.txt صفحه مهم را مسدود نکرده است.
- □ Googlebot توسط Firewall یا CDN Block نشده است.
- □ URL پشت Login قرار ندارد.
- □ حداقل یک مسیر داخلی منطقی برای کشف صفحه وجود دارد.
- □ لینک داخلی از ساختار استاندارد
<a href>استفاده می کند. - □ لینک ها مستقیما به URL نهایی اشاره می کنند.
- □ Redirect Loop وجود ندارد.
- □ Redirect Chain غیرضروری وجود ندارد.
- □ نسخه موبایل لینک های مهم را حذف نکرده است.
- □ URL در صورت نیاز داخل Sitemap قرار دارد.
- □ JavaScript مانع نمایش محتوای اصلی نیست.
- □ منابع ضروری Render توسط robots.txt مسدود نشده اند.
- □ URL Inspection امکان Crawl را تایید می کند.
- □ در مسائل مهم، Server Log نیز بررسی شده است.
اشتباهات رایج هنگام بررسی Crawlability
- یکی دانستن Crawlability و Indexability؛
- استفاده از robots.txt برای Noindex؛
- تصور اینکه Sitemap می تواند Block را دور بزند؛
- تصور اینکه پاسخ 200 یعنی صفحه حتما Index می شود؛
- یکی دانستن Discoverability و Crawlability؛
- استفاده از Canonical برای جلوگیری از Crawl؛
- استفاده از Nofollow به عنوان ابزار قطعی Block کردن URL؛
- اعتماد کامل به یک Crawler بدون بررسی Search Console؛
- نادیده گرفتن Firewall و CDN؛
- بررسی نکردن نسخه موبایل؛
- نادیده گرفتن Redirect Chain؛
- باز کردن تمام URLها برای Crawl بدون توجه به ارزش آن ها.
Crawlability را هر چند وقت یک بار بررسی کنیم؟
برای همه سایت ها یک فاصله زمانی ثابت وجود ندارد.
اما بعد از تغییرات زیر بهتر است Crawlability دوباره بررسی شود:
- تغییر robots.txt؛
- تغییر Hosting یا Server؛
- فعال کردن CDN یا Firewall جدید؛
- تغییر ساختار URL؛
- مهاجرت سایت؛
- تغییر Navigation؛
- تغییر قالب؛
- تغییر معماری JavaScript؛
- انتقال HTTP به HTTPS؛
- حذف یا Redirect تعداد زیادی URL.
گاهی یک تغییر کوچک فنی می تواند روی هزاران URL اثر بگذارد؛ برای همین Crawl مجدد بعد از تغییرات مهم ارزش زیادی دارد.
آیا Google باید تمام صفحات سایت را Crawl کند؟
نه.
هدف این نیست که Googlebot بیشترین تعداد Request ممکن را به سایت ارسال کند.
هدف این است که:
صفحات مهم به راحتی قابل کشف و Crawl باشند و URLهای کم ارزش باعث پیچیده شدن مسیر Crawl نشوند.
در بیشتر سایت های کوچک و متوسط، تمرکز روی معماری منطقی، لینک های قابل Crawl، Server سالم و کنترل صحیح robots.txt بسیار مهم تر از وسواس روی تعداد درخواست های Googlebot است.
جمع بندی
Crawlability یا قابلیت خزش مشخص می کند آیا Crawler موتور جستجو می تواند به یک URL دسترسی پیدا کند و پاسخ آن را دریافت کند یا نه.
اما Crawlability را نباید با Discovery، Crawling یا Indexing یکی دانست.
یک صفحه ممکن است کشف شده باشد ولی اجازه Crawl نداشته باشد، یا Crawl شود ولی به دلیل noindex وارد Index نشود.
برای بررسی قابلیت خزش باید چند لایه را کنار هم ببینیم: robots.txt، Status Code، Server، Firewall، لینک های داخلی، Redirectها، Sitemap، JavaScript و داده های Search Console.
در عمل بهترین روش این است که ابتدا مطمئن شویم صفحات مهم سایت مسیر واضحی برای کشف دارند، Googlebot اجازه دسترسی به آن ها را دارد و Server نیز پاسخ صحیح ارائه می کند.
وقتی این زیرساخت درست باشد، تازه می توان مراحل بعدی مثل Indexing و Ranking را با معنی بیشتری تحلیل کرد.

اولین دیدگاه را بنویسید