

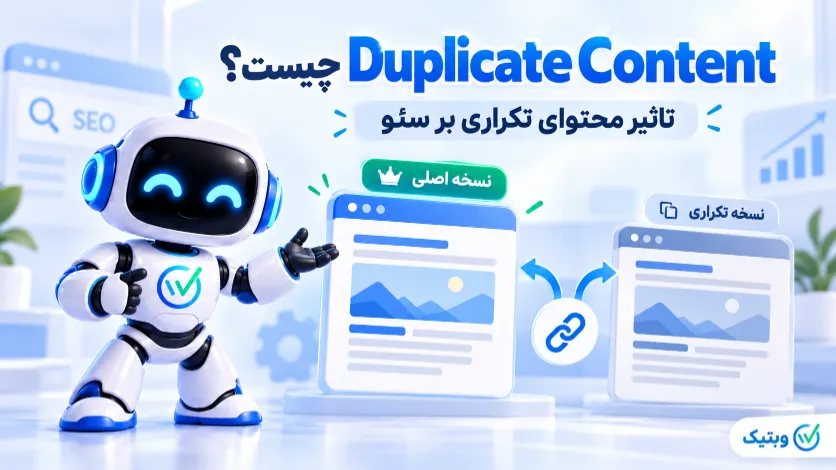
اگر یک محتوای یکسان یا بسیار مشابه از چند URL در دسترس باشد، با مسئله Duplicate Content یا محتوای تکراری روبه رو هستیم.
این اتفاق همیشه نتیجه کپی کردن مقاله نیست. پارامترهای URL، صفحات فیلتر و مرتب سازی، نسخه های مختلف یک محصول، HTTP و HTTPS، نسخه آزمایشی سایت یا حتی تنظیم اشتباه CMS می توانند باعث شوند یک محتوا با چند آدرس مختلف قابل دسترسی باشد.
نکته مهم این است که Duplicate Content را نباید با «جریمه خودکار Google» یکی بدانیم. Google صراحتا توضیح می دهد که وجود محتوای تکراری داخل سایت به خودی خود نقض Spam Policies نیست. معمولا Google نسخه های مشابه را در یک گروه قرار می دهد و یک URL را به عنوان نسخه اصلی یا Canonical انتخاب می کند.
مشکل زمانی ایجاد می شود که این تکرار باعث شود URL اشتباه در نتایج نمایش داده شود، منابع Crawl برای نسخه های غیرضروری مصرف شوند، داده های عملکرد بین چند URL تقسیم شوند یا ساختار سایت برای کاربر و موتور جستجو مبهم شود.
در این راهنما بررسی می کنیم Duplicate Content چیست، چگونه آن را پیدا کنیم، چه تاثیری بر سئو دارد و چه زمانی باید از Redirect، Canonical، noindex یا بازطراحی محتوا استفاده کنیم.
Duplicate Content یا محتوای تکراری چیست؟
Duplicate Content زمانی رخ می دهد که محتوای اصلی یک صفحه به صورت کامل یا بسیار مشابه از بیش از یک URL قابل دسترسی باشد.
مثلا فرض کنید این دو آدرس عملا یک صفحه را نمایش دهند:
https://example.com/product/shoe
https://example.com/product/shoe?color=blue
اگر محتوای اصلی هر دو URL تقریبا یکسان باشد، Google ممکن است آن ها را نسخه های تکراری یک محتوا تشخیص دهد.
در مستند رسمی Canonicalization، Google توضیح می دهد وقتی چند صفحه محتوای یکسان یا بسیار مشابه داشته باشند، آن ها را در یک گروه قرار می دهد و سپس یک URL را به عنوان نسخه نماینده انتخاب می کند.
راهنمای رسمی Google درباره Canonicalization و صفحات تکراری
آیا Duplicate Content باعث جریمه Google می شود؟
معمولا نه.
این یکی از رایج ترین سوء برداشت های سئو است.
Google می گوید وجود محتوای یکسان روی چند URL داخل سایت به خودی خود نقض سیاست های Spam نیست.
مثلا فروشگاه اینترنتی ممکن است یک محصول را از چند مسیر، فیلتر یا URL پارامتردار نمایش دهد. این اتفاق به تنهایی به معنی Spam نیست.
اما وضعیت متفاوت می شود اگر محتوای کپی شده یا صفحات بسیار مشابه با هدف دستکاری رتبه بندی و بدون ارزش برای کاربران در مقیاس زیاد تولید شوند. چنین روش هایی می توانند وارد محدوده سیاست های Spam، Scraping یا Scaled Content Abuse شوند.
پس بهتر است بین این دو حالت تفاوت بگذاریم:
- تکرار فنی یا طبیعی: چند URL برای یک محتوا؛
- تولید عمدی صفحات تکراری کم ارزش: ایجاد تعداد زیاد صفحه برای گرفتن رتبه.
اگر جریمه نیست، پس چرا محتوای تکراری مهم است؟
چون مسئله اصلی Duplicate Content معمولا «Penalty» نیست؛ مسئله این است که Google و خود سایت باید تصمیم بگیرند کدام URL نسخه اصلی است.
اگر این تصمیم واضح نباشد، چند مشکل ممکن است ایجاد شود.
ممکن است URL دیگری به عنوان نسخه اصلی انتخاب شود
شما می توانید نسخه Canonical موردنظر خود را به Google پیشنهاد دهید، اما این انتخاب دستور قطعی نیست.
Google ممکن است براساس مجموعه سیگنال ها URL دیگری را مناسب تر بداند. حتی اگر Canonical مشخص کرده باشید، Google می تواند نسخه دیگری را انتخاب کند.
خزش روی URLهای غیرضروری مصرف می شود
اگر یک محتوای یکسان از ده ها یا هزاران URL قابل دسترسی باشد، Googlebot ممکن است بخشی از زمان خود را صرف Crawl نسخه هایی کند که ارزش مستقلی ندارند.
برای سایت کوچک این مسئله معمولا بحرانی نیست، اما در سایت های بزرگ، فروشگاه ها و سایت های دارای فیلترهای زیاد می تواند مهم تر شود.
اگر هنوز با این فرایند آشنا نیستید، مقاله خزش Google توضیح می دهد موتور جستجو چگونه URLها را کشف و بررسی می کند.
تحلیل عملکرد سخت تر می شود
وقتی یک محتوا روی چند URL وجود دارد، ممکن است لینک ها، داده های Search و ورودی کاربران بین نسخه های مختلف پراکنده شوند.
یکی از دلایلی که Google برای مشخص کردن Canonical مطرح می کند، ساده تر شدن تحلیل عملکرد محتوا و تجمیع سیگنال های صفحات مشابه است.
کاربر ممکن است با چند نسخه مشابه روبه رو شود
اگر دو صفحه تقریبا یکسان داخل سایت وجود داشته باشند، حتی خود کاربر ممکن است نداند تفاوت آن ها چیست یا کدام صفحه نسخه اصلی است.
Google هم در SEO Starter Guide اشاره می کند که وجود یک محتوای یکسان در چند URL می تواند تجربه گیج کننده ای ایجاد کند.
Google با Duplicate Content چگونه برخورد می کند؟
Google معمولا فرآیندی به نام Canonicalization انجام می دهد.
به شکل ساده:
- URLهای مشابه را Crawl می کند؛
- محتوای اصلی صفحات را مقایسه می کند؛
- صفحات یکسان یا بسیار مشابه را در یک گروه قرار می دهد؛
- یک URL را به عنوان Canonical انتخاب می کند؛
- معمولا همان نسخه را در نتایج جستجو نمایش می دهد.
Google توضیح می دهد که نسخه Canonical معمولا بیشتر Crawl می شود و نسخه های تکراری کمتر Crawl می شوند.
پس اگر در Search Console می بینید بعضی URLهای مشابه ایندکس نشده اند، این وضعیت لزوما مشکل نیست.
Canonical URL چیست؟
Canonical URL آدرسی است که قرار است نسخه اصلی و نماینده مجموعه ای از صفحات یکسان یا بسیار مشابه باشد.
مثلا اگر این آدرس ها یک محصول را نمایش دهند:
/shoes/nike-air
/shoes/nike-air?utm_source=email
/shoes/nike-air?sort=new
نسخه اصلی ممکن است این باشد:
https://example.com/shoes/nike-air
و نسخه های دیگر به این URL Canonical اشاره کنند.
آیا Canonical یک دستور قطعی برای Google است؟
خیر.
این نکته بسیار مهم است.
Google تگ Canonical را یک سیگنال برای انتخاب نسخه اصلی در نظر می گیرد، نه دستوری که همیشه مجبور باشد اجرا کند.
اگر مثلا صفحه A را Canonical صفحه B اعلام کنید اما:
- محتوای دو صفحه تفاوت زیادی داشته باشد؛
- لینک های داخلی بیشتر به B اشاره کنند؛
- Redirectها سیگنال متفاوتی بدهند؛
- یا سایر سیگنال ها با Canonical شما ناسازگار باشند؛
ممکن است Google نسخه دیگری را انتخاب کند.
چه چیزهایی باعث Duplicate Content داخل سایت می شوند؟
بخش بزرگی از Duplicate Content از اشتباه نویسنده ایجاد نمی شود؛ از ساختار فنی سایت می آید.
پارامترهای URL
مثلا:
/product/shirt
/product/shirt?utm_source=instagram
/product/shirt?ref=homepage
اگر هر سه همان محتوا را نمایش دهند، چند URL برای یک صفحه داریم.
فیلتر و مرتب سازی
فروشگاه ها معمولا URLهایی مثل این تولید می کنند:
/shoes?color=black
/shoes?sort=price
/shoes?brand=nike
بعضی از این صفحات ممکن است ارزش جستجوی مستقل داشته باشند و بعضی فقط نسخه دیگری از همان دسته بندی باشند.
پس نمی توان همه Filter URLها را کورکورانه Canonical کرد یا بست. ابتدا باید مشخص شود هر URL آیا نیاز جستجوی مستقلی دارد یا خیر.
HTTP و HTTPS
اگر هر دو نسخه زیر در دسترس باشند:
http://example.com/page
https://example.com/page
ممکن است یک محتوا از دو URL قابل دسترسی باشد.
نسخه www و بدون www
https://www.example.com/page
https://example.com/page
اگر Redirect مناسب وجود نداشته باشد، دو نسخه ایجاد می شود.
حروف بزرگ و کوچک در URL
بعضی سرورها این دو URL را متفاوت در نظر می گیرند:
/SEO/
/seo/
اگر هر دو همان محتوا را برگردانند، بهتر است یک الگوی ثابت برای URLها داشته باشید.
راهنمای ساختار URL مناسب سئو اصول طراحی آدرس های ساده و پایدار را توضیح می دهد.
صفحه های چاپی یا نسخه های جایگزین
بعضی سایت ها برای یک مقاله URL جداگانه چاپ تولید می کنند:
/article/seo
/article/seo/print
اگر هر دو محتوای مشابهی داشته باشند، باید رابطه آن ها مشخص باشد.
سایت آزمایشی یا Staging
گاهی نسخه آزمایشی سایت ناخواسته برای Google قابل Crawl باقی می ماند:
staging.example.com
example.com
در این حالت کل سایت ممکن است یک نسخه تکراری داشته باشد.
صفحات محصول بسیار مشابه
مثلا هر رنگ یک محصول URL جدا داشته باشد ولی توضیح و محتوای اصلی تقریبا یکسان باشد.
اینجا باید تصمیم بگیرید آیا هر Variation واقعا صفحه مستقل لازم دارد یا بهتر است داخل یک URL مدیریت شود.
Duplicate Content خارجی چیست؟
محتوای تکراری فقط داخل یک دامنه اتفاق نمی افتد.
ممکن است مقاله شما در سایت دیگری نیز منتشر شود یا فروشگاه های مختلف از توضیح یکسان تولیدکننده استفاده کنند.
نمونه ها:
- انتشار مقاله مهمان در چند سایت؛
- Syndication محتوا؛
- کپی شدن مقاله توسط سایت دیگر؛
- توضیح یکسان محصولات در چند فروشگاه؛
- استفاده از Feed محتوا.
این وضعیت الزاما باعث جریمه سایت اصلی نمی شود، اما ممکن است تشخیص نسخه نماینده برای موتور جستجو پیچیده تر شود.
Google در مستند Canonicalization حتی اشاره می کند که در موارد نادر ممکن است یک سایت کپی کننده به اشتباه به عنوان Canonical انتخاب شود و برای موارد نقض حق نشر راهکارهای جداگانه وجود دارد.
Duplicate Content چه تفاوتی با Cannibalization دارد؟
این دو مشکل اغلب با هم اشتباه گرفته می شوند.
Duplicate Content: محتوای اصلی صفحات تقریبا یکسان است.
Cannibalization: چند URL برای یک Intent یا مجموعه Query مشابه رقابت می کنند، حتی اگر متن آن ها کاملا متفاوت باشد.
مثلا:
صفحه A: چگونه عنوان سئو بنویسیم؟
صفحه B: 15 نکته برای نوشتن SEO Title
ممکن است متن دو مقاله متفاوت باشد اما هر دو یک Job را انجام دهند. این بیشتر مسئله کنیبالیزیشن کلمات کلیدی است، نه Duplicate Content فنی.
Duplicate Content چه تفاوتی با Thin Content دارد؟
Thin Content درباره ارزش صفحه است.
Duplicate Content درباره تکرار محتوا بین چند URL است.
ممکن است یک صفحه محتوای بسیار خوب و عمیقی داشته باشد اما همان محتوا از سه URL در دسترس باشد. در این حالت مشکل Duplicate داریم ولی محتوا Thin نیست.
برعکس، یک صفحه می تواند کاملا منحصربه فرد باشد اما پاسخ سطحی و بی ارزشی ارائه کند. این صفحه Duplicate نیست، ولی می تواند Thin Content باشد.
Duplicate Content چه تفاوتی با محتوای مشابه دارد؟
دو صفحه می توانند درباره یک موضوع باشند بدون اینکه Duplicate محسوب شوند.
مثلا:
- «سئو داخلی چیست؟»
- «چک لیست سئو داخلی»
هر دو درباره On-Page SEO هستند اما Job متفاوتی دارند.
یکی مفهوم و اجزا را توضیح می دهد و دیگری برای بررسی عملی یک صفحه طراحی شده است.
پس شباهت موضوعی به تنهایی Duplicate Content نیست.
چگونه Duplicate Content سایت را پیدا کنیم؟
برای سایت کوچک می توان بسیاری از مشکلات را دستی پیدا کرد، اما در سایت بزرگ بهتر است چند منبع داده را کنار هم استفاده کنیم.
1. Search Console را بررسی کنید
در گزارش Page Indexing ممکن است وضعیت هایی مثل این ببینید:
Alternate page with proper canonical tag
Duplicate without user-selected canonical
Duplicate, Google chose different canonical than user
این وضعیت ها اطلاعات مهمی درباره نحوه تشخیص صفحات مشابه توسط Google می دهند.
اما دیدن کلمه Duplicate در این گزارش به معنی وجود بحران نیست.
مثلا اگر یک URL جایگزین به درستی به نسخه Canonical اشاره کند، وضعیت:
Alternate page with proper canonical tag
می تواند کاملا طبیعی باشد و Google می گوید در این حالت اقدامی لازم نیست.
2. از URL Inspection استفاده کنید
URL Inspection به شما نشان می دهد:
- Canonical اعلام شده توسط سایت چیست؛
- Google کدام URL را Canonical انتخاب کرده است؛
- صفحه ایندکس شده یا نه؛
- آخرین Crawl چه زمانی بوده است.
اگر Google-selected canonical با User-declared canonical متفاوت است، باید علت را بررسی کنید.
3. سایت را Crawl کنید
با ابزارهای Crawl می توانید URLهایی را پیدا کنید که:
- Title یکسان دارند؛
- H1 یکسان دارند؛
- محتوای مشابه زیادی دارند؛
- Canonical متفاوت یا اشتباه دارند؛
- پارامترهای زیاد تولید می کنند.
وجود Title یکسان به تنهایی اثبات Duplicate Content نیست، اما برای Audit نقطه شروع خوبی است.
4. الگوهای URL را بررسی کنید
گاهی مشکل با نگاه کردن به چند URL مشخص می شود:
?sort=
?filter=
?utm_source=
?session=
اگر تعداد زیادی از این URLها همان محتوای اصلی را نمایش می دهند، باید مدیریت آن ها را بررسی کنید.
5. صفحات مشابه محتوایی را مقایسه کنید
اگر دو مقاله دارید که عنوان و ساختار متفاوتی دارند اما عملا همان پاسخ را ارائه می دهند، مسئله ممکن است بیشتر محتوایی باشد تا فنی.
در این حالت ابتدا نیت جستجو و سپس Keyword Mapping را بررسی کنید.
برای رفع Duplicate Content چه کاری انجام دهیم؟
یک راه حل ثابت برای تمام حالت ها وجود ندارد.
ابتدا باید دلیل ایجاد نسخه های تکراری را پیدا کنیم.
راه اول: اگر URL اضافه لازم نیست، Redirect کنید
اگر دو URL عملا یک صفحه هستند و هیچ دلیلی برای باقی ماندن نسخه دوم وجود ندارد، Redirect معمولا یکی از واضح ترین راه حل هاست.
مثلا:
http://example.com/page
→ https://example.com/page
یا:
/old-page
→ /new-page
Google Redirect را یکی از قوی ترین سیگنال ها برای Canonicalization معرفی می کند.
راه دوم: اگر هر دو URL باید باقی بمانند، rel=”canonical” را بررسی کنید
گاهی URL جایگزین برای کاربر یا سیستم لازم است اما نمی خواهید به عنوان نسخه اصلی در Search شناخته شود.
در این حالت می توان داخل نسخه جایگزین به URL اصلی Canonical داد.
<link rel="canonical" href="https://example.com/main-page/">اما Canonical باید به صفحه ای اشاره کند که واقعا نسخه یکسان یا بسیار مشابه محتواست.
نباید مثلا ده مقاله متفاوت را Canonical صفحه اصلی سایت کنید.
Self-Canonical چیست و چرا مفید است؟
صفحه اصلی هر محتوا می تواند به خودش Canonical بدهد:
<link rel="canonical" href="https://example.com/article/">این کار ترجیح سایت را واضح تر می کند و در CMSهای مدرن معمولا به صورت خودکار انجام می شود.
راه سوم: Sitemap را تمیز نگه دارید
بهتر است Sitemap شامل URLهایی باشد که واقعا می خواهید به عنوان نسخه اصلی ایندکس شوند.
اگر URL پارامتردار یا نسخه Duplicate را داخل Sitemap قرار دهید ولی Canonical آن به URL دیگری اشاره کند، سیگنال های متناقض ایجاد کرده اید.
Google قرار گرفتن URL در Sitemap را یک سیگنال ضعیف تر برای Canonicalization می داند.
راه چهارم: لینک های داخلی را به نسخه Canonical بدهید
فرض کنید Canonical صفحه این است:
/product/shoe
اما داخل سایت مرتب به این نسخه لینک داده اید:
/product/shoe?ref=menu
بهتر است لینک های داخلی به نسخه اصلی اشاره کنند.
Google نیز در راهنمای Canonicalization توصیه می کند لینک های داخلی به URL Canonical داده شوند، نه نسخه های Duplicate.
راه پنجم: اگر صفحات واقعا مستقل هستند، محتوای آن ها را متمایز کنید
اگر Google دو صفحه را Duplicate تشخیص داده اما شما واقعا می خواهید هر دو مستقل ایندکس شوند، صرف تغییر Canonical کافی نیست.
باید مشخص شود چرا هر صفحه ارزش مستقل دارد.
Google در مستند جدید Canonicalization Troubleshooting می گوید اگر دو صفحه باید جدا شناخته شوند، تفاوت محتوایی آن ها باید واضح و قابل توجه باشد.
مثلا دو صفحه خدمات برای دو شهر مختلف نباید فقط نام شهر متفاوت داشته باشند.
اگر واقعا خدمات، شرایط، نمونه کار، قیمت، محدودیت یا تجربه محلی متفاوتی وجود دارد، این تفاوت باید در محتوای اصلی منعکس شود.
آیا از noindex برای Duplicate Content استفاده کنیم؟
در بعضی سناریوها noindex می تواند مناسب باشد، اما برای انتخاب Canonical بین صفحات مشابه راه حل اصلی نیست.
Google صراحتا توصیه می کند برای جلوگیری از انتخاب یک صفحه به عنوان Canonical در همان سایت، از noindex به عنوان روش Canonicalization استفاده نکنید و rel=”canonical” را ترجیح می دهد.
noindex زمانی مناسب تر است که صفحه برای کاربران لازم است اما اساسا نمی خواهید در Search حضور داشته باشد.
آیا robots.txt مشکل محتوای تکراری را حل می کند؟
معمولا نه.
robots.txt ابزار کنترل Crawl است، نه ابزار اعلام نسخه Canonical.
اگر Google نتواند صفحه را Crawl کند، ممکن است حتی تگ Canonical داخل آن را هم نبیند.
پس قبل از بستن URLهای Duplicate با robots.txt باید بدانید دقیقا چه نتیجه ای می خواهید.
آیا باید نسخه های پارامتردار را همیشه Canonical کنیم؟
نه.
بعضی پارامترها فقط Tracking هستند و محتوای صفحه را تغییر نمی دهند:
?utm_source=newsletter
اما بعضی پارامترها ممکن است یک صفحه واقعا متفاوت و مفید ایجاد کنند:
?category=laptop
یا:
?size=42
پس تصمیم باید براساس محتوای واقعی و Intent صفحه گرفته شود.
صفحات چندزبانه Duplicate Content هستند؟
اگر محتوای اصلی واقعا به زبان دیگری ترجمه شده باشد، Google آن ها را صرفا به دلیل یکسان بودن مفهوم Duplicate در نظر نمی گیرد.
Google توضیح می دهد نسخه های زبانی زمانی Duplicate محسوب می شوند که محتوای اصلی همان زبان را داشته باشد و فقط بخش های فرعی مثل Header و Footer ترجمه شده باشند.
برای سایت های چندزبانه باید ساختار URL و hreflang نیز به درستی مدیریت شوند.
آیا توضیحات محصول یکسان مشکل ایجاد می کند؟
اگر صدها فروشگاه توضیح رسمی تولیدکننده را استفاده کنند، طبیعی است بخش هایی از محتوا در وب تکراری باشد.
به جای اینکه فقط چند کلمه را عوض کنید، بهتر است ارزش واقعی اضافه کنید:
- تجربه استفاده؛
- تصاویر اختصاصی؛
- مقایسه؛
- مزایا و محدودیت ها؛
- راهنمای انتخاب؛
- سوال های واقعی کاربران.
هدف فقط «Unique کردن متن» نیست؛ هدف ایجاد صفحه ای مفیدتر است.
آیا کپی چند پاراگراف از منبع دیگر Duplicate Content است؟
نه لزوما به معنای Duplicate Page.
یک صفحه ممکن است برای نقل یک تعریف یا داده از منبع معتبر بخشی از متن را نقل کند و در کنار آن تحلیل و محتوای مستقل زیادی داشته باشد.
مسئله زمانی جدی تر می شود که بخش اصلی صفحه از منابع دیگر گرفته شده باشد و ارزش جدیدی ایجاد نکند.
Google در سیاست Spam درباره Scraping و جمع آوری محتوای دیگر سایت ها بدون ارزش افزوده هشدار می دهد.
اگر Google Canonical اشتباهی انتخاب کرده چه کنیم؟
ابتدا URL را در URL Inspection بررسی کنید و این دو مقدار را مقایسه کنید:
- User-declared canonical
- Google-selected canonical
اگر متفاوت هستند، این موارد را بررسی کنید:
- Canonical صفحه؛
- Redirectها؛
- لینک های داخلی؛
- URLهای Sitemap؛
- میزان شباهت محتوا؛
- نسخه HTTP و HTTPS؛
- تنظیمات CMS؛
- hreflang در سایت چندزبانه.
Google در مستند رفع مشکلات Canonicalization همین مسیر را پیشنهاد می کند و یادآوری می کند که بعد از اصلاح نیز ارزیابی دوباره صفحات ممکن است زمان ببرد.
چگونه Duplicate Content را در سایت WordPress کنترل کنیم؟
WordPress بسته به قالب و افزونه ها می تواند URLهای مختلفی تولید کند:
- صفحات دسته بندی؛
- تگ ها؛
- آرشیو نویسنده؛
- آرشیو تاریخ؛
- Attachment Page؛
- پارامترها؛
- نسخه های Pagination.
وجود این صفحات به خودی خود مشکل نیست.
باید بررسی کنید کدام نوع صفحه برای کاربر و Search ارزش مستقل دارد و کدام فقط نسخه دیگری از محتوای موجود است.
تنظیمات افزونه سئو را نیز بررسی کنید تا Canonical صفحات به URLهای اشتباه اشاره نکند.
برای رفع محتوای تکراری از این جدول استفاده کنید
| وضعیت | راه حل احتمالی |
|---|---|
| دو URL کاملا یکسان و نسخه دوم لازم نیست | Redirect به نسخه اصلی |
| نسخه جایگزین لازم است ولی نباید نسخه اصلی Search باشد | Canonical |
| صفحه برای کاربر لازم است ولی نباید در Search باشد | بررسی noindex |
| دو صفحه باید مستقل باشند | ایجاد تفاوت واقعی در محتوا و هدف |
| چند مقاله یک Intent دارند | بررسی ادغام و کنیبالیزیشن |
| پارامتر Tracking همان محتوا را نمایش می دهد | Canonical و لینک داخلی به URL اصلی |
| URL قدیمی با صفحه جدید جایگزین شده | Redirect |
اشتباهات رایج هنگام رفع Duplicate Content
- تصور اینکه هر محتوای مشابه باعث Penalty می شود؛
- Canonical کردن صفحات کاملا متفاوت؛
- Canonical کردن همه چیز به Homepage؛
- استفاده از noindex به جای حل مشکل Canonicalization؛
- بستن URL با robots.txt قبل از بررسی نتیجه؛
- قرار دادن URL Duplicate داخل Sitemap؛
- لینک داخلی دادن به نسخه غیرCanonical؛
- ساخت صفحه جدا برای هر Variation کلمه کلیدی؛
- تغییر چند کلمه برای Unique نشان دادن صفحه؛
- نادیده گرفتن URLهای فیلتر و پارامتر؛
- ندیدن تفاوت Duplicate Content و Cannibalization.
چک لیست بررسی Duplicate Content
- □ مشخص است کدام URL نسخه اصلی هر محتواست.
- □ نسخه های HTTP به HTTPS منتقل می شوند.
- □ www و non-www ساختار یکسان و کنترل شده دارند.
- □ پارامترهای URL بررسی شده اند.
- □ صفحات فیلتر و مرتب سازی Audit شده اند.
- □ Canonical صفحات صحیح است.
- □ صفحات اصلی Self-Canonical مناسب دارند.
- □ لینک های داخلی به نسخه Canonical اشاره می کنند.
- □ Sitemap فقط URLهای موردنظر برای ایندکس را دارد.
- □ صفحات Staging برای Google باز نیستند.
- □ وضعیت های Duplicate در Search Console بررسی شده اند.
- □ Google-selected canonical با نسخه موردنظر مقایسه شده است.
- □ صفحات مشابه محتوایی از نظر Intent بررسی شده اند.
- □ Cannibalization با Duplicate Content اشتباه گرفته نشده است.
- □ Redirect فقط زمانی استفاده شده که نسخه دوم دیگر لازم نیست.
- □ noindex فقط برای صفحات واقعا نامناسب برای Search استفاده شده است.
جمع بندی
Duplicate Content زمانی ایجاد می شود که محتوای یکسان یا بسیار مشابه از چند URL قابل دسترسی باشد.
وجود چنین صفحاتی به خودی خود به معنی جریمه Google نیست. Google معمولا نسخه های مشابه را گروه بندی می کند و یک URL را به عنوان Canonical انتخاب می کند. مشکل زمانی ایجاد می شود که نسخه اصلی برای سایت و Google واضح نباشد، Crawl روی URLهای غیرضروری مصرف شود، داده ها پراکنده شوند یا URL اشتباه در نتایج نمایش داده شود.
برای رفع مشکل ابتدا دلیل ایجاد URLهای تکراری را پیدا کنید. اگر نسخه اضافه دیگر لازم نیست، Redirect می تواند انتخاب مناسبی باشد. اگر نسخه جایگزین باید باقی بماند، Canonical را بررسی کنید. لینک های داخلی و Sitemap نیز باید با نسخه اصلی هماهنگ باشند.
همچنین هر محتوای مشابه را Duplicate فرض نکنید. دو صفحه می توانند درباره یک موضوع باشند اما Intent متفاوتی داشته باشند؛ همان طور که دو صفحه با متن متفاوت ممکن است از نظر Search Intent با یکدیگر کنیبال شوند.
هدف رفع Duplicate Content این نیست که تمام صفحات سایت از نظر کلمات کاملا متفاوت باشند؛ هدف این است که برای هر محتوا و هر نیاز کاربر، نسخه اصلی و نقش هر URL روشن باشد.

اولین دیدگاه را بنویسید