

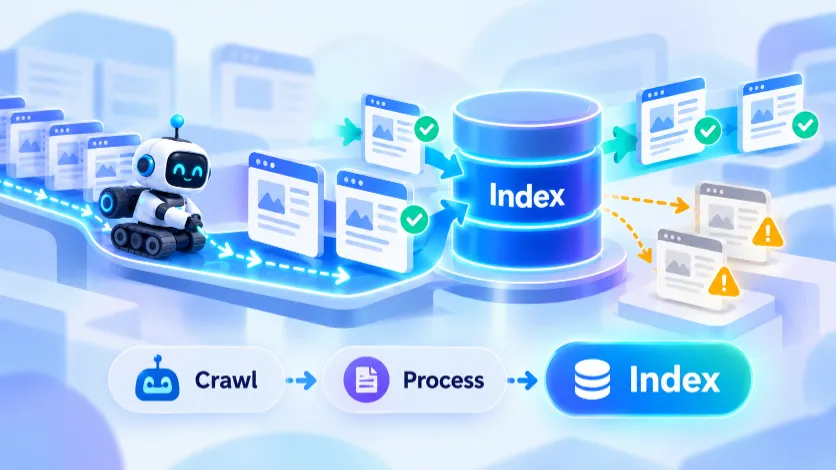
ممکن است یک صفحه را منتشر کنید، لینک داخلی بدهید، آن را داخل Sitemap قرار دهید و حتی ببینید Googlebot صفحه را Crawl کرده است؛ اما باز هم URL در نتایج گوگل دیده نشود.
اینجا معمولاً وارد مرحله ای می شویم که Indexing یا ایندکس شدن نام دارد.
به زبان ساده، Indexing فرایندی است که طی آن گوگل محتوای یک صفحه Crawl شده را پردازش و تحلیل می کند و در صورت مناسب بودن، اطلاعات آن را در Google Index ذخیره می کند.
اما نکته مهم این است:
هر صفحه ای که Crawl می شود الزاماً Index نمی شود.
گوگل خودش توضیح می دهد که فرایند Search شامل مراحل Crawling، Indexing و سپس نمایش نتایج است و همه صفحات لزوماً از تمام این مراحل عبور نمی کنند.
به همین دلیل وقتی می پرسیم «چرا سایت من در گوگل نیست؟» ابتدا باید بفهمیم مشکل دقیقاً در کدام مرحله است:
- URL هنوز کشف نشده؟
- کشف شده ولی Crawl نشده؟
- Crawl شده ولی Index نشده؟
- Index شده ولی برای Query موردنظر رتبه نمی گیرد؟
این تفاوت، پایه عیب یابی درست SEO است.
اگر با تصویر کلی این مراحل آشنا نیستید، مقاله موتور جستجو چیست و چگونه کار می کند؟ نقطه شروع مناسبی است. برای مرحله قبلی این فرایند هم در مقاله Crawling چیست؟ توضیح داده ایم Googlebot چگونه URLها را پیدا و بررسی می کند.
Indexing یکی از مراحل مهم سئو است؛ چون تا زمانی که یک صفحه وارد Index گوگل نشود، عملاً امکان حضور عادی آن در نتایج جستجو وجود ندارد. برای درک جایگاه Indexing در کنار Crawling، Ranking و سایر بخشهای SEO، میتوانید مقاله سئو چیست را هم ببینید.
Indexing چیست؟
Indexing یا ایندکس فرایندی است که بعد از Crawl صفحه اتفاق می افتد.
در این مرحله گوگل تلاش می کند بفهمد:
- موضوع اصلی صفحه چیست؛
- متن و عناصر مهم آن چه می گویند؛
- تصاویر و ویدئوهای صفحه چه هستند؛
- عنوان و سایر اطلاعات صفحه چیست؛
- آیا محتوای صفحه تکراری یا بسیار شبیه صفحه دیگری است؛
- کدام URL باید به عنوان Canonical در نظر گرفته شود.
گوگل در مستندات رسمی خود توضیح می دهد که در مرحله Indexing متن، تصاویر، ویدئوها و عناصر مهمی مثل <title> و Alt تصاویر را تحلیل می کند.
در واقع Crawl فقط به گوگل امکان می دهد صفحه را دریافت کند؛ Indexing مرحله ای است که در آن محتوای دریافت شده تفسیر، دسته بندی و در صورت انتخاب، ذخیره می شود.
«برای جزئیات بیشتر درباره این مرحله، مستندات گوگل درباره Indexing توضیح میدهد که یک صفحه زمانی Indexed محسوب میشود که Googlebot آن را بررسی کرده، محتوایش تحلیل شده و اطلاعات آن در Google Index ذخیره شده باشد.»
Google Index چیست؟
Google Index را می توان به صورت ساده یک پایگاه داده بسیار بزرگ تصور کرد که اطلاعات صفحات شناخته شده گوگل در آن نگهداری می شود.
البته نباید آن را شبیه یک فهرست ساده از URLها در نظر گرفت.
Google هنگام Indexing اطلاعات مختلفی درباره صفحه جمع آوری می کند تا بعداً هنگام جستجوی کاربر بتواند صفحات مرتبط را پیدا کند.
فرایند کلی به شکل ساده این است:
URL Discovery
↓
Crawling
↓
Indexing
↓
Ranking / Serving
اگر URL در مرحله Indexing پذیرفته نشود، معمولاً وارد رقابت عادی Ranking نیز نخواهد شد.
تفاوت Crawl و Index چیست؟
این دو مفهوم زیاد با هم اشتباه گرفته می شوند.
Crawling
Googlebot صفحه را درخواست و بررسی می کند.
Indexing
گوگل محتوای صفحه را پردازش می کند و تصمیم می گیرد آیا اطلاعات آن در Search Index ذخیره شود یا نه.
مثلاً ممکن است Search Console نشان دهد:
Crawled – currently not indexed
یعنی Googlebot صفحه را بررسی کرده، اما گوگل در حال حاضر آن را وارد Index نکرده است.
پس:
Crawled ≠ Indexed
این تفاوت بسیار مهم است، چون اگر صفحه Crawl نشده باشد باید دنبال مشکل Crawl بگردید؛ اما اگر Crawl شده و Index نشده، مسیر بررسی متفاوت می شود.
آیا هر صفحه Crawl شده باید Index شود؟
خیر، این تصور اشتباه است که:
«اگر گوگل صفحه را دیده، موظف است آن را ایندکس کند.»
گوگل به صراحت اعلام می کند Index شدن تضمین شده نیست و همه صفحاتی که پردازش می شوند وارد Index نمی شوند.
این موضوع حتی اگر:
- Sitemap درست باشد؛
- صفحه Status Code 200 بدهد؛
- Googlebot بتواند آن را Crawl کند؛
- درخواست Indexing هم ارسال کرده باشید؛
باز هم صادق است، Indexing یک تصمیم مستقل است.
Google هنگام Indexing چه کاری انجام می دهد؟
یکی از بخش های مهم Indexing، درک محتوای صفحه است.
گوگل مواردی مثل:
- Main Content
- Title
- تصاویر
- ویدئو
- Alt Text
- ساختار صفحه
- شباهت با صفحات دیگر
- Canonical
را پردازش می کند، در این مرحله یکی از اتفاقات مهم Canonicalization است.
Canonicalization چیست؟
گاهی یک محتوای تقریباً یکسان از چند URL قابل دسترسی است.
مثلاً:
example.com/product
example.com/product?ref=home
example.com/category/product
اگر محتوای این URLها بسیار مشابه باشد، منطقی نیست همه آن ها به عنوان صفحات مستقل در Index نگهداری شوند.
گوگل هنگام Indexing صفحات مشابه را در گروه هایی قرار می دهد و تلاش می کند یک URL را به عنوان نسخه اصلی یا Canonical انتخاب کند.
صفحات دیگر می توانند به عنوان Alternate در همان Cluster در نظر گرفته شوند.
به همین دلیل ممکن است URL خودتان Index نشده باشد ولی Google URL دیگری را به عنوان Canonical انتخاب کرده باشد.
Canonical Tag یعنی چه؟
با تگ:
<link rel="canonical" href="https://example.com/page/" />به موتور جستجو اعلام می کنید که URL مشخص شده نسخه ترجیحی شماست.
اما Canonical یک دستور مطلق نیست.
گوگل می تواند با توجه به مجموعه سیگنال ها URL دیگری را Canonical انتخاب کند.
بنابراین در عیب یابی Indexing باید همیشه دو مورد را بررسی کنید: User-declared Canonical و Google-selected Canonical این اطلاعات در URL Inspection قابل مشاهده هستند.
noindex چیست؟
اگر صفحه دارای Rule زیر باشد:
<meta name="robots" content="noindex">به موتورهای جستجوی پشتیبان این Rule اعلام می شود که صفحه را وارد Index نکنند.
گوگل توضیح می دهد وقتی Googlebot صفحه را Crawl کند و noindex را ببیند، آن URL را از نتایج Search حذف می کند.
پس اگر صفحه ای Index نمی شود، یکی از اولین بررسی ها باید همین باشد.
اما یک نکته مهم وجود دارد:
برای اینکه Google بتواند noindex را ببیند، باید بتواند صفحه را Crawl کند.
اگر URL را همزمان در robots.txt مسدود کرده باشید، Googlebot ممکن است اصلاً نتواند Tag را مشاهده کند.
بنابراین:
robots.txt و noindex یک کار انجام نمی دهند.
چرا صفحات سایت در گوگل ایندکس نمی شوند؟
دلایل Index نشدن می توانند فنی، محتوایی یا ساختاری باشند.
اشتباه این است که برای تمام URLها یک نسخه ثابت تجویز کنیم.
مثلاً:
«فقط Request Indexing بزن.»
یا:
«بک لینک بگیر درست می شود.»
تشخیص درست از وضعیت واقعی URL شروع می شود.
1. صفحه هنوز Crawl نشده است
اگر صفحه هنوز Crawl نشده باشد، طبیعتاً مرحله Indexing هم کامل نشده است.
در Search Console ممکن است وضعیت: Discovered – currently not indexed را ببینید.
این یعنی گوگل URL را می شناسد اما هنوز آن را Crawl نکرده است. راهنمای Page Indexing نیز این وضعیت را از Crawled – currently not indexed جدا می کند.
در چنین حالتی موارد زیر را بررسی کنید:
- صفحه لینک داخلی دارد؟
- URL داخل Sitemap هست؟
- سرور پایدار است؟
- تعداد URLهای سایت بی دلیل زیاد نشده؟
- robots.txt مانع Crawl نیست؟
- صفحه در ساختار سایت دفن نشده؟
2. صفحه Crawl شده ولی Index نشده است
وضعیت: Crawled – currently not indexed یکی از رایج ترین مواردی است که صاحبان سایت می بینند.
معنی ساده آن این است:
Googlebot URL را Crawl کرده، اما صفحه در حال حاضر وارد Index نشده است.
نکته مهم اینجاست که این وضعیت همیشه به معنی خطای فنی نیست.
اگر Googlebot موفق شده صفحه را دریافت کند، باید موضوعاتی مثل کیفیت، تمایز محتوا، شباهت به صفحات دیگر و ارزش واقعی صفحه را هم بررسی کنید.
Crawled – currently not indexed را چطور بررسی کنیم؟
به جای اینکه بلافاصله دوباره Request Indexing بزنید، چند سؤال مهم بپرسید.
آیا صفحه واقعاً محتوای مستقل دارد؟
فرض کنید 30 صفحه دارید که تنها تفاوتشان نام شهر است:
خدمات سئو در تهران
خدمات سئو در کرج
خدمات سئو در قم
خدمات سئو در رشت
اما 95 درصد متن همه صفحات یکسان است.
از نگاه شما URLها متفاوت اند، ولی ممکن است ارزش مستقل هر صفحه بسیار کم باشد.
آیا صفحه چیزی بیشتر از صفحات دیگر ارائه می دهد؟
مثلاً اگر قبلاً مقاله: Crawling چیست؟ دارید و بعد مقاله دیگری با عنوان: Crawl چیست؟ منتشر کنید که تقریباً همان محتوا را تکرار می کند، مسئله ممکن است کمبود URL نباشد؛ بلکه تعدد صفحات مشابه باشد.
آیا Google محتوای صفحه را Render می کند؟
در سایت های JavaScript-heavy ممکن است HTML اولیه دریافت شود اما محتوای اصلی هنگام Rendering درست نمایش داده نشود.
در این شرایط Live Test و View Tested Page در URL Inspection می تواند کمک کند بررسی کنید Google واقعاً چه چیزی می بیند. راهنمای Search Central Community نیز این مورد را یکی از Edge Caseهای فنی برای صفحات Crawled – currently not indexed معرفی می کند.
3. صفحه noindex است
ممکن است CMS، افزونه SEO یا تنظیمات دستی صفحه را noindex کرده باشد.
در WordPress این اتفاق گاهی به دلایل مختلف رخ می دهد:
- تنظیم اشتباه افزونه سئو
- Noindex شدن دسته یا نوشته
- باقی ماندن تنظیمات Staging
- استفاده اشتباه از Meta Robots
کد صفحه و URL Inspection را بررسی کنید، اگر صفحه باید Index شود، نباید Rule فعال noindex داشته باشد.
4. Canonical به صفحه دیگری اشاره می کند
فرض کنید صفحه A دارید، ولی Canonical آن به B اشاره می کند:
<link rel="canonical" href="https://example.com/page-b/" />در این حالت خودتان عملاً به Google سیگنال داده اید که B نسخه ترجیحی است.
یا ممکن است Self-referencing Canonical داشته باشید ولی Google با توجه به شباهت محتوا، URL دیگری را Canonical انتخاب کند.
در Search Console وضعیت هایی مثل: Duplicate, Google chose different canonical than user می تواند نشانه همین مسئله باشد.
در Page Indexing Report، URLهای Duplicate و Alternate لزوماً Error نیستند؛ ممکن است رفتار کاملاً مورد انتظار Canonicalization باشند.
5. محتوای تکراری یا بسیار مشابه دارید
Duplicate Content لزوماً به معنی Penalty نیست.
ولی اگر چند URL تقریباً یک محتوا داشته باشند، منطقی است Google همه آن ها را جداگانه Index نکند.
در مرحله Indexing، Google صفحات مشابه را Cluster و Canonical را انتخاب می کند.
مثلاً:
/category/shoes/
/category/shoes/?sort=price
/category/shoes/?sort=new
ممکن است از نظر کاربر حالت های مختلف فیلتر باشند، ولی برای Search نیاز نباشد هرکدام URL مستقلی در Index داشته باشند.
6. کیفیت یا ارزش صفحه پایین است
این بخش را باید با دقت بیان کرد.
هر Index نشدن به معنی «محتوای بد» نیست.
اما گوگل خودش در مستندات How Search Works، پایین بودن کیفیت محتوای صفحه را یکی از مشکلات رایج Indexing معرفی می کند.
مثلاً صفحه ای که:
- متن بسیار سطحی دارد؛
- پاسخ مشخصی ارائه نمی دهد؛
- تقریباً بازنویسی صفحات دیگر است؛
- محتوای اصلی بسیار کمی دارد؛
- با ده ها URL سایت هم پوشانی شدید دارد؛
ممکن است ارزش Index شدن کمتری داشته باشد.
سؤال کاربردی این است:
اگر این صفحه وارد Google Index شود، چه چیز مستقلی به نتایج اضافه می کند؟
7. صفحات زیادی بدون هدف ساخته اید
گاهی مشکل یک URL نیست؛ ساختار کل سایت است.
مثلاً سایت Ecommerce ممکن است به دلیل:
- Filter
- Sort
- Tag
- Search Pages
- Parameters
- Paginationهای نامناسب
هزاران URL ایجاد کند، اگر بخش بزرگی از این URLها ارزش مستقل نداشته باشند، مدیریت Crawl و Index پیچیده می شود.
برای همین در سئو تکنیکال فقط به اصلاح یک Tag نگاه نمی کنیم؛ ساختار کلی URLها نیز اهمیت دارد.
8. صفحه Redirect است
اگر URL به صفحه دیگری Redirect شود، معمولاً قرار نیست همان URL مبدأ به عنوان صفحه مستقل Index شود.
مثلاً:
/page-a/
↓ 301
/page-b/
در چنین شرایطی Index شدن مقصد منطقی تر است.
Search Console نیز صفحات Redirect را در Page Indexing Report جداگانه گزارش می کند.
9. صفحه 404 یا Soft 404 است
اگر URL واقعاً وجود ندارد و 404 Not Found برمی گرداند، طبیعی است که انتظار Index شدن نداشته باشیم.
Soft 404 کمی متفاوت است، ممکن است صفحه Status Code 200 بدهد ولی عملاً محتوای آن شبیه صفحه «محصول پیدا نشد» یا «محتوایی وجود ندارد» باشد.
در چنین شرایطی Google ممکن است آن را Soft 404 تشخیص دهد.
10. Server Error وجود دارد
خطاهای 5xx یعنی Server هنگام درخواست صفحه مشکل داشته است.
Page Indexing Report این خطاها را از دلایل عدم Index گزارش می کند.
اگر Googlebot نتواند صفحه را پایدار دریافت کند، قبل از بحث درباره محتوا باید مشکل Server حل شود.
11. robots.txt دسترسی را محدود کرده است
robots.txt مستقیماً ابزار Noindex نیست، اما اگر Googlebot نتواند صفحه را Crawl کند، طبیعتاً توانایی پردازش محتوای آن نیز محدود می شود.
Search Console می تواند وضعیت: Blocked by robots.txt را گزارش کند، در این حالت ابتدا باید بررسی کنید آیا Block شدن عمدی است یا اشتباه.
Discovered – currently not indexed چیست؟
این وضعیت یعنی Google از وجود URL باخبر است اما هنوز آن را Crawl نکرده است.
مثلاً ممکن است URL را از:
- Sitemap
- Internal Link
- External Link
پیدا کرده باشد، اما هنوز Googlebot وارد صفحه نشده باشد.
در این وضعیت تمرکز اصلی باید بیشتر روی Discovery و Crawl باشد تا Indexing Content.
Crawled – currently not indexed چیست؟
یعنی Googlebot صفحه را Crawl کرده، اما صفحه در حال حاضر در Index نیست.
در این حالت:
- Crawl انجام شده؛
- دسترسی اولیه وجود داشته؛
- اما مرحله Indexing به نتیجه Index شدن نرسیده.
بنابراین فقط بررسی Sitemap یا robots.txt کافی نیست.
باید مواردی مثل:
- Content
- Similarity
- Canonical
- Rendering
- Site Structure
- Internal Linking
را هم بررسی کنید.
تفاوت دو وضعیت را ساده ببینیم
| وضعیت | Google URL را می شناسد؟ | Crawl شده؟ | Index شده؟ | تمرکز بررسی |
|---|---|---|---|---|
| Discovered – currently not indexed | بله | نه | نه | Crawl و ساختار سایت |
| Crawled – currently not indexed | بله | بله | نه | Indexing، محتوا، Canonical و Rendering |
| Indexed | بله | بله | بله | Ranking و Performance |
این جدول برای شروع Troubleshooting بسیار کاربردی است.
چگونه بفهمیم یک صفحه Index شده است؟
بهترین ابزار عملی برای بررسی یک URL مشخص، URL Inspection در Google Search Console است.
URL را وارد کنید.
Search Console می تواند اطلاعاتی مثل:
- Indexing Status
- Last Crawl
- Canonical
- Crawl Allowed
- Indexing Allowed
- Referring Page
- Sitemap
را در اختیار شما بگذارد.
برای بررسی وضعیت کلی سایت نیز Page Indexing Report وجود دارد که URLهای Indexed و Non-indexed را همراه با دلیل دسته بندی می کند.
«اگر میخواهید دلیل Index نشدن URLها را دقیقتر بررسی کنید، مستندات گوگل درباره Page Indexing Report وضعیتهایی مثل noindex، robots.txt، Soft 404، Redirect و Server Error را جداگانه توضیح داده است.»
آیا دستور site: برای بررسی Index کافی است؟
می توانید عبارت هایی مثل:
site:example.comیا:
site:example.com/page/را جستجو کنید.
این روش برای بررسی سریع مفید است، اما بهتر است برای عیب یابی یک URL مشخص روی Search Console و URL Inspection تکیه کنید.
خود راهنمای Search Console هم برای سایت های کوچک site: را به عنوان بررسی ابتدایی مطرح می کند، اما Page Indexing Report و URL Inspection اطلاعات دقیق تری برای Troubleshooting می دهند.
Request Indexing چیست؟
در URL Inspection می توانید برای یک URL درخواست Indexing ارسال کنید، این قابلیت مفید است، اما باید معنای آن را درست بدانید.
Request Indexing یعنی:
از Google بخواهید URL را دوباره بررسی کند.
نه اینکه:
Google موظف است صفحه را فوراً وارد Index کند.
گوگل تضمین نمی کند یک URL چه زمانی یا اصلاً Crawl و Index شود، بنابراین اگر یک صفحه مشکل بنیادی دارد، 20 بار Request Indexing زدن مشکل را حل نمی کند.
آیا Sitemap باعث Index شدن صفحه می شود؟
خیر، Sitemap به Google در کشف URLهای سایت کمک می کند، اما تضمینی برای Index شدن نیست.
گوگل صراحتاً توضیح می دهد Sitemap می تواند به شناخت URLهای سایت کمک کند اما Index شدن را تضمین نمی کند.
پس این استدلال درست نیست:
«URL داخل Sitemap است، پس چرا Index نشده؟»
وجود در Sitemap فقط یکی از سیگنال هاست.
لینک داخلی چه کمکی به Index شدن می کند؟
لینک داخلی چند نقش دارد:
- کمک به Discovery؛
- مشخص کردن ارتباط موضوعی صفحات؛
- هدایت Googlebot و کاربر؛
- نشان دادن اهمیت نسبی صفحات در ساختار سایت.
فرض کنید مقاله جدید: Indexing چیست؟ را منتشر کرده ایم.
طبیعی است از صفحات:
- سئو چیست
- موتور جستجو چیست
- Crawling چیست
به این صفحه لینک داده شود، به این شکل مقاله بخشی از یک ساختار موضوعی مشخص می شود، نه یک URL جداافتاده.
آیا بک لینک باعث Index شدن می شود؟
Backlink می تواند به Discovery و شناخت URL کمک کند، اما فرمول ساده ای وجود ندارد که: Backlink = Index حتی صفحه ای که لینک خارجی دارد ممکن است به دلایل دیگری Index نشود.
بنابراین گرفتن Backlink راه حل عمومی مشکلات Indexing نیست.
آیا محتوای طولانی تر راحت تر Index می شود؟
لزومی ندارد، تعداد کلمات معیار مستقیمی برای Index شدن نیست.
یک صفحه 700 کلمه ای می تواند بسیار کامل و مفید باشد و یک مقاله 5000 کلمه ای می تواند پر از تکرار و حشو باشد.
به جای تعداد کلمات باید به این فکر کنید:
- Search Intent چیست؟
- صفحه چه مسئله ای را حل می کند؟
- آیا ارزش مستقل دارد؟
- آیا با صفحات دیگر Cannibalize می شود؟
- آیا پاسخ کامل و دقیق ارائه می دهد؟
Index Bloat چیست؟
Index Bloat اصطلاحی است که در SEO برای وضعیتی استفاده می شود که تعداد زیادی URL کم ارزش یا غیرضروری وارد فضای Crawl و Index سایت شده اند.
برای مثال:
- Tagهای بی استفاده
- Filterها
- Search Result Pages
- Parameter Pages
- Archiveهای ضعیف
- صفحات تقریباً Duplicate
هدف SEO این نیست که بیشترین تعداد URL ممکن را Index کنیم، هدف این است که صفحات ارزشمند و موردنیاز قابلیت Index مناسب داشته باشند.
آیا همه صفحات سایت باید Index شوند؟
خیر، بعضی صفحات ممکن است عمداً نباید وارد Search شوند.
مثلاً بسته به نوع سایت:
- صفحه Login
- Cart
- Checkout
- صفحات داخلی خاص
- بعضی Search Result Pages
- URLهای موقت
- صفحات تکراری
ممکن است نیازی به Index نداشته باشند، به همین دلیل در Page Indexing Report هر URL Non-indexed الزاماً یک مشکل نیست. خود Google نیز در راهنمای این گزارش تأکید می کند که Not indexed لزوماً بد نیست و باید دلیل هر وضعیت بررسی شود.
چک لیست بررسی صفحه ای که Index نمی شود
اگر یک URL مهم Index نشده، این مسیر را طی کنید.
مرحله 1: URL Inspection
ابتدا URL را در Search Console بررسی کنید.
ببینید:
- Google URL را می شناسد؟
- Last Crawl چیست؟
- Crawl Allowed است؟
- Indexing Allowed است؟
- Canonical چیست؟
مرحله 2: Status Code را بررسی کنید
صفحه مهم بهتر است در حالت عادی 200 OK برگرداند.
اگر:
- 404
- 5xx
- Redirect
است، ابتدا علت را بررسی کنید.
مرحله 3: noindex را بررسی کنید
در Source یا HTTP Header بررسی کنید صفحه ناخواسته: noindex نداشته باشد.
مرحله 4: robots.txt را بررسی کنید
مطمئن شوید Googlebot برای URL مهم Block نشده است.
مرحله 5: Canonical را بررسی کنید
آیا Canonical به خودش اشاره دارد؟
آیا عمداً باید به صفحه دیگری اشاره کند؟
Google-selected Canonical چیست؟
مرحله 6: محتوا را با صفحات مشابه مقایسه کنید
آیا صفحه واقعاً محتوای مستقل دارد؟
یا فقط نسخه دیگری از یک صفحه موجود است؟
مرحله 7: لینک داخلی را بررسی کنید
آیا صفحه از Hub و صفحات مرتبط لینک دارد؟
یا یک Orphan Page است؟
مرحله 8: Rendering را بررسی کنید
در سایت های JavaScript بررسی کنید Googlebot محتوای اصلی را می بیند.
مرحله 9: Sitemap را بررسی کنید
اگر URL برای Index شدن مهم است، بهتر است در Sitemap مناسب باشد.
مرحله 10: بعد از اصلاح، درخواست بررسی بدهید
بعد از رفع مشکل، می توانید از URL Inspection درخواست Indexing بدهید.
اما صبور باشید؛ Google زمان مشخص و تضمین شده ای برای Index شدن اعلام نمی کند.
برای Index شدن سریع تر چه کار کنیم؟
عبارت «Index سریع» کمی گمراه کننده است، چون زمان بندی دست Google است.
اما می توانید شرایط را بهتر کنید:
- محتوای واقعی و مستقل منتشر کنید؛
- از صفحات مرتبط لینک داخلی بدهید؛
- Sitemap را درست نگه دارید؛
- Server پایدار داشته باشید؛
- noindex و robots.txt را بررسی کنید؛
- Canonicalهای اشتباه را اصلاح کنید؛
- صفحات Duplicate غیرضروری نسازید؛
- URLهای مهم را در ساختار سایت قابل دسترس نگه دارید؛
- Search Console را برای بررسی وضعیت استفاده کنید.
این کارها «ترفند Index فوری» نیستند؛ بلکه موانع را حذف می کنند.
آیا سن دامنه روی Indexing اثر دارد؟
سایت جدید ممکن است مدتی طول بکشد تا Google آن را بیشتر Crawl و پردازش کند.
گوگل نیز در FAQ رسمی خود اشاره می کند یکی از دلایل رایج Index نشدن سایت این است که سایت بسیار جدید باشد و Crawling و Indexing به زمان نیاز دارند.
اما نباید هر مشکل Index را فقط به سن دامنه نسبت داد.
اگر بعد از مدت مناسب صفحات مهم همچنان مشکل دارند، باید وضعیت فنی، محتوا و ساختار بررسی شود.
چقدر طول می کشد یک صفحه Index شود؟
پاسخ ثابت ندارد، ممکن است یک صفحه زود Index شود و صفحه دیگری مدت بیشتری زمان ببرد.
Google هیچ زمان مشخصی برای Crawl یا Index تضمین نمی کند.
پس عبارت هایی مثل:
«هر مقاله حتماً ظرف 24 ساعت Index می شود»
قابل اتکا نیستند.
چرا صفحه Index شده ولی در گوگل پیدایش نمی کنم؟
Index شدن و Ranking یک چیز نیستند، ممکن است Search Console بگوید URL Indexed است ولی هنگام جستجوی Keyword مدنظر، صفحه را پیدا نکنید.
چون بعد از Indexing مرحله دیگری وجود دارد:
Ranking.
در این مرحله Google از میان صفحات موجود در Index، نتایج مرتبط با Query کاربر را انتخاب و مرتب می کند.
گوگل نیز توضیح می دهد Indexed بودن تضمین نمی کند صفحه برای جستجوی خاصی نمایش داده شود؛ ارتباط و کیفیت همچنان در مرحله Serving اهمیت دارند.
بنابراین:
Index شدن
≠
رتبه گرفتن
این موضوع را در مقاله بعدی یعنی Ranking چیست؟ گوگل چگونه نتایج را رتبه بندی می کند؟ کامل بررسی می کنیم.
اشتباهات رایج هنگام حل مشکل Indexing
Request Indexing پشت سر هم
اگر مشکل واقعی وجود دارد، درخواست مکرر راه حل نیست.
تغییر مداوم URL
URL را بدون دلیل عوض نکنید.
این کار می تواند ساختار سایت را پیچیده تر کند.
استفاده از robots.txt برای Noindex
robots.txt ابزار کنترل Crawl است، نه جایگزین Meta Robots.
تولید صفحه بیشتر
اگر 100 صفحه مشابه Index نمی شوند، ساخت 100 صفحه مشابه دیگر معمولاً راه حل منطقی نیست.
تمرکز فقط روی Sitemap
Sitemap مفید است ولی ضمانت Indexing نیست.
تصور اینکه Non-indexed همیشه Error است
گاهی Google درست عمل کرده است.
مثلاً URL Redirect یا Alternate Canonical ممکن است عمداً Index نشود.
یک مثال عملی برای وبتیک
فرض کنیم مقاله جدید وبتیک منتشر شده است:
/ایندکس-گوگل/بعد از انتشار:
- از مقاله موتور جستجو چیست؟ به آن لینک می دهیم.
- از مقاله Crawling چیست؟ به این مقاله لینک می دهیم.
- URL داخل Sitemap قرار می گیرد.
- Google URL را Discover می کند.
- Googlebot صفحه را Crawl می کند.
- Google محتوای مقاله را پردازش می کند.
- اگر صفحه برای Index مناسب تشخیص داده شود، وارد Google Index می شود.
- سپس برای Queryهایی مثل «Indexing چیست» امکان رقابت در Ranking خواهد داشت.
این مسیر دقیقاً نشان می دهد چرا انتشار صفحه فقط ابتدای کار است.
جمع بندی
Indexing مرحله ای است که Google بعد از Crawl تلاش می کند محتوای یک صفحه را درک و در صورت مناسب بودن در Search Index ذخیره کند.
نکته مهم این است که:
Crawl شدن تضمین Index شدن نیست.
اگر یک صفحه Index نشده، ابتدا باید وضعیت دقیق آن را مشخص کنید.
اگر:
Discovered – currently not indexed
است، تمرکز اصلی باید روی Crawl و ساختار سایت باشد.
اگر:
Crawled – currently not indexed
است، باید علاوه بر مسائل فنی، محتوای صفحه، شباهت با صفحات دیگر، Canonical، Rendering و ارزش مستقل آن را بررسی کنید.
برای صفحات مهم، ترکیب زیر معمولاً بهترین نقطه شروع است:
دسترسی فنی صحیح + محتوای مستقل + Canonical درست + لینک داخلی منطقی + Search Console
و بعد از اینکه صفحه Index شد، سؤال بعدی این است که چرا یک صفحه بالاتر از صفحه دیگر نمایش داده می شود.
این دقیقاً موضوع مرحله بعد یعنی Ranking است.

اولین دیدگاه را بنویسید