

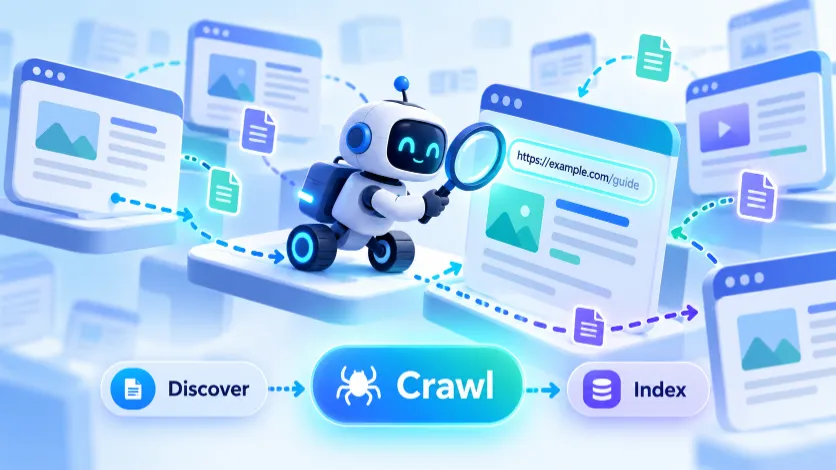
وقتی یک صفحه جدید در سایت منتشر می کنید، گوگل همان لحظه از وجود آن باخبر نمی شود. ابتدا باید URL صفحه را پیدا کند، به آن دسترسی داشته باشد و محتوایش را بررسی کند، این فرایند Crawling یا خزش نام دارد.
در Google Search این کار عمدتاً توسط خزنده ای به نام Googlebot انجام می شود.
اما یک نکته مهم را باید از همان ابتدا بدانید:
Crawl شدن یک صفحه به معنی Index شدن یا رتبه گرفتن آن نیست.
Crawling فقط یکی از مراحل کار موتور جستجو است. گوگل بعد از Crawl هنوز باید صفحه را پردازش کند، درباره Index شدن آن تصمیم بگیرد و بعد در صورت ارتباط با جستجوی کاربران، آن را وارد رقابت Ranking کند.
اگر هنوز تصویر کلی این فرایند برایتان روشن نیست، بهتر است ابتدا مقاله موتور جستجو چیست و چگونه کار می کند؟ را بخوانید.
Crawling چیست؟
Crawling فرایندی است که طی آن برنامه های خودکار موتورهای جستجو URL های وب را پیدا می کنند و برای بررسی محتوای آن ها درخواست می فرستند.
به این برنامه ها نام های مختلفی داده می شود:
- Crawler
- Spider
- Bot
- Robot
در گوگل، یکی از مهم ترین Crawlers همان Googlebot است.
Google Search یک موتور جستجوی خودکار است و گوگل توضیح می دهد که بیشتر صفحاتی که در نتایج آن دیده می شوند به صورت دستی ثبت نشده اند؛ بلکه توسط Web Crawlerها هنگام پیمایش وب پیدا شده اند.
فرض کنید مقاله ای جدید با URL زیر منتشر کرده اید:
example.com/آموزش-سئو/
برای اینکه گوگل بتواند در آینده این صفحه را Index کند، ابتدا باید از وجود آن مطلع شود و در صورت امکان آن را Crawl کند.
Crawl به زبان خیلی ساده
برای تصور بهتر Crawling، یک ربات را در نظر بگیرید که در وب حرکت می کند.
این ربات وارد یک صفحه می شود، محتوای آن را دریافت می کند و لینک هایی را که داخل صفحه وجود دارند بررسی می کند.
اگر یکی از لینک ها به صفحه ای باشد که قبلاً نمی شناخته است، URL جدیدی پیدا کرده است.
مثلاً:
صفحه اصلی
   ↓
دسته آموزش سئو
   ↓
مقاله سئو چیست
   ↓
مقاله Crawling چیست
اگر این صفحات با لینک های قابل Crawl به هم متصل باشند، ربات می تواند از یک صفحه به صفحه دیگر برسد.
البته عملکرد واقعی Googlebot بسیار پیچیده تر از این مثال است، اما این مدل برای فهم منطق اصلی مناسب است.
Googlebot چیست؟
Googlebot نام عمومی خزنده ای است که گوگل برای پیدا کردن و دریافت صفحات وب در Google Search استفاده می کند.
گوگل در مستندات خود Googlebot را برنامه ای معرفی می کند که URLهای جدید و به روزشده را برای Google Index کشف می کند.
Googlebot هنگام مراجعه به یک URL شبیه مرورگر یک درخواست HTTP به سرور ارسال می کند.
سرور نیز پاسخی برمی گرداند؛ مثلاً:
-
200 OK 301 Redirect404 Not Found500 Internal Server Error
نوع پاسخ سرور می تواند تعیین کند Googlebot در مرحله بعد چه رفتاری داشته باشد.
گوگل همچنین نسخه های Smartphone و Desktop از Googlebot دارد. در فهرست رسمی Crawlers گوگل، هر دو User-Agent معرفی شده اند.
«اگر می خواهید جزئیات فنی تری درباره نحوه فعالیت خزنده های گوگل ببینید، مستندات گوگل درباره Crawling و Googlebot مرجع مناسبی است.»
User-Agent چیست؟
وقتی یک Browser یا Crawler به سرور درخواست می فرستد، می تواند خودش را با User-Agent معرفی کند.
برای مثال ممکن است Log سرور نشان دهد درخواستی از طرف Googlebot دریافت شده است.
این اطلاعات برای متخصص فنی یا SEO می تواند مفید باشد تا بررسی کند:
- Googlebot چه URLهایی را Crawl کرده است؛
- چه زمانی به صفحه مراجعه کرده؛
- سرور چه Status Codeای برگردانده است؛
- Crawl سایت چه الگویی دارد.
البته صرف دیدن عبارت Googlebot در User-Agent تضمین نمی کند درخواست واقعاً متعلق به گوگل باشد، چون User-Agent قابل جعل است. گوگل برای تأیید Crawlers واقعی روش های جداگانه ای ارائه کرده است.
گوگل چگونه URLهای جدید را پیدا می کند؟
پیش از Crawl مرحله دیگری وجود دارد که معمولاً با عنوان URL Discovery شناخته می شود.
گوگل فهرست مرکزی و کاملی از تمام صفحات وب ندارد. بنابراین باید دائماً URLهای جدید یا تغییرکرده را کشف کند.
چند مسیر اصلی برای کشف URL وجود دارد.
1. لینک های داخلی
یکی از مهم ترین مسیرها لینک های موجود در صفحات دیگر سایت است.
مثلاً فرض کنید مقاله فعلی درباره Crawling امروز منتشر شده است.
اگر از مقاله: موتور جستجو چیست و چگونه کار می کند؟ به این صفحه لینک بدهیم، Googlebot هنگام Crawl صفحه مادر می تواند URL این مقاله را پیدا کند.
گوگل توصیه می کند صفحاتی که برایتان اهمیت دارند حداقل از یک صفحه دیگر سایت لینک داشته باشند. لینک های داخلی هم به کاربران و هم به Google کمک می کنند صفحات دیگر را پیدا و ارتباط آن ها را درک کنند.
به همین دلیل مفهوم صفحه یتیم یا Orphan Page اهمیت پیدا می کند.
صفحه ای که هیچ Internal Link مناسبی به آن وجود ندارد، معمولاً مسیر طبیعی ضعیف تری برای کشف دارد.
2. لینک از سایت های دیگر
اگر یک سایت خارجی به URL جدید شما لینک بدهد، خزنده ممکن است هنگام بررسی آن سایت لینک شما را کشف کند.
این یعنی Backlink فقط موضوع Ranking نیست؛ لینک ها می توانند در Discovery صفحات نیز نقش داشته باشند.
البته این به معنی آن نیست که برای Crawl شدن حتماً باید Backlink داشته باشید. سایت می تواند صفحات خود را از طریق ساختار داخلی و Sitemap نیز معرفی کند.
3. XML Sitemap
Sitemap فایلی است که URLهای مهم سایت را به موتورهای جستجو معرفی می کند.
برای مثال Sitemap می تواند شامل این URLها باشد:
example.com/
example.com/سئو-چیست/
example.com/موتور-جستجو/
example.com/خزش-گوگل/
این کار به موتور جستجو کمک می کند بفهمد چه صفحاتی را مهم می دانید.
اما نکته بسیار مهم:
قرار دادن یک URL در Sitemap به معنی تضمین Crawl یا Index شدن آن نیست.
خود گوگل نیز Submission یک Sitemap را فقط یک Hint معرفی می کند، نه دستور اجباری برای Crawl.
پس Sitemap مفید است، اما جای ساختار لینک داخلی خوب را نمی گیرد.
4. Redirectها
Googlebot می تواند هنگام Crawl یک URL به Redirect برسد و از آن مسیر URL دیگری را پیدا کند.
مثلاً:
/page-old/
   ↓ 301
/page-new/
در چنین حالتی URL مقصد Redirect نیز وارد فرایند بررسی می شود.
گوگل در راهنمای فنی خود توضیح می دهد که Googlebot از طریق Links، Sitemaps و Redirectها بین URLها حرکت می کند.
آیا می توان URL را دستی به گوگل معرفی کرد؟
برای سایت هایی که در Search Console تأیید شده اند، ابزار URL Inspection امکان درخواست بررسی مجدد برخی URLها را فراهم می کند.
اما این را نباید تبدیل به فرایند اصلی انتشار محتوا کرد.
ساختار درست سایت باید به شکلی باشد که موتور جستجو بتواند صفحات جدید را به صورت طبیعی از طریق لینک ها و Sitemap پیدا کند.
درخواست دستی Crawl نیز تضمین نمی کند صفحه فوراً Crawl یا Index شود.
بعد از پیدا شدن URL چه اتفاقی می افتد؟
کشف یک URL هنوز به معنی Crawl شدن آن نیست.
گوگل باید تصمیم بگیرد چه زمانی و با چه اولویتی URL را دریافت کند.
گوگل توضیح می دهد Googlebot به صورت الگوریتمی مشخص می کند چه سایت هایی Crawl شوند، Crawl با چه دفعاتی انجام شود و چه تعداد صفحه از هر سایت دریافت شود.
بنابراین مدل واقعی چیزی شبیه این نیست:
گوگل سایت شما را باز میکند
↓
از صفحه اول شروع میکند
↓
تمام صفحات را یکییکی Crawl میکند
↓
تمام میشودوب دائماً تغییر می کند و خزنده ها باید بین حجم عظیمی از URLهای شناخته شده تصمیم بگیرند کدام URLها دوباره یا برای اولین بار بررسی شوند.
آیا Googlebot هر URL پیدا شده را Crawl می کند؟
نه لزوماً.
گوگل صراحتاً می گوید همه صفحاتی که کشف می شوند حتماً Crawl نمی شوند.
دلایل مختلفی می تواند وجود داشته باشد:
- URL در robots.txt مسدود شده باشد؛
- سرور پاسخ مناسبی ندهد؛
- Crawl سایت محدود شده باشد؛
- صفحه نیاز به Login داشته باشد؛
- تعداد زیادی URL کم ارزش یا تکراری وجود داشته باشد؛
- گوگل Crawl آن URL را در آن لحظه ضروری نداند.
پس عبارت:
Discovered
با:
Crawled
یکسان نیست.
Crawlability چیست؟
Crawlability یعنی اینکه خزنده موتور جستجو تا چه اندازه می تواند URLهای موردنظر سایت را پیدا و دریافت کند.
یک صفحه ممکن است روی سایت وجود داشته باشد اما برای Googlebot دسترسی مناسبی نداشته باشد.
برای مثال:
- لینک داخلی به آن وجود ندارد؛
- robots.txt دسترسی را مسدود کرده است؛
- URL فقط پس از Login نمایش داده می شود؛
- Server Error ایجاد می شود؛
- لینک توسط JavaScript به شکلی ساخته شده که Google نتواند به خوبی آن را استخراج کند.
در چنین حالتی مشکل اصلی محتوا نیست؛ مشکل در مسیر Crawl قرار دارد.
بعداً این موضوع را در مقاله مستقل Crawlability چیست؟ عمیق تر بررسی می کنیم.
لینک Crawlable چیست؟
همه چیزهایی که در ظاهر شبیه لینک هستند الزاماً برای Crawler لینک استاندارد محسوب نمی شوند.
گوگل توصیه می کند لینک ها به شکل استاندارد HTML و با عنصر <a> و ویژگی href ساخته شوند.
نمونه مناسب:
<a href="/خزش-گوگل/">Crawling چیست؟</a>Google می تواند URL داخل href را استخراج کند.
اما ساختارهایی که فقط با Eventهای JavaScript رفتار لینک را شبیه سازی می کنند، ممکن است برای Crawler قابل اتکا نباشند.
مثلاً:
<span onclick="goToPage()">صفحه بعد</span>ممکن است برای کاربر قابل کلیک باشد، ولی از دید Crawler ساختار استاندارد یک لینک را ندارد.
این موضوع در سایت های JavaScript-heavy اهمیت بیشتری پیدا می کند.
آیا گوگل JavaScript را اجرا می کند؟
بله، Google Search می تواند JavaScript صفحات را Render کند.
گوگل توضیح می دهد که در جریان Crawl صفحه را Render می کند و JavaScript را با نسخه ای جدید از Chrome اجرا می کند.
اما این به معنی آن نیست که ساختار سایت را می توان کاملاً بدون توجه به دسترسی Crawlers طراحی کرد.
برای محتوای مهم بهتر است:
- URL واقعی وجود داشته باشد؛
- لینک های استاندارد قابل Crawl باشند؛
- محتوای حیاتی فقط در ساختارهای پیچیده و غیرقابل دسترس پنهان نشود؛
- منابع مهم برای Rendering مسدود نباشند.
گوگل نیز به توسعه دهندگان هشدار می دهد آنچه Googlebot مشاهده می کند همیشه دقیقاً مشابه چیزی نیست که کاربر در Browser می بیند.
robots.txt چیست و چه ارتباطی با Crawling دارد؟
فایل robots.txt یکی از مهم ترین ابزارهای مدیریت دسترسی Crawlers است.
معمولاً در ریشه سایت قرار دارد:
https://example.com/robots.txtداخل آن می توان Rules مربوط به Crawl را تعریف کرد.
مثلاً:
User-agent: *
Disallow: /private/
این Rule به Crawlerهای مشمول آن اعلام می کند مسیر /private/ را Crawl نکنند.
گوگل قبل از Crawl سایت فایل robots.txt را دریافت و قوانین مرتبط را بررسی می کند.
آیا robots.txt برای Noindex کردن صفحه است؟
نه.
این اشتباه بسیار رایج است.
robots.txt اساساً برای کنترل Crawl طراحی شده است، نه اینکه به طور قطعی صفحه را از Index حذف کند.
گوگل توضیح می دهد اگر صفحه توسط robots.txt برای Crawl مسدود شده باشد، ممکن است محتوای آن را نتواند Index کند، اما خود URL در برخی شرایط همچنان ممکن است بدون Snippet در نتایج دیده شود.
بنابراین:
Disallow ≠ Noindex
اگر هدف شما جلوگیری از Index شدن صفحه است، باید ابزار مناسب همان هدف را انتخاب کنید.
جزئیات robots.txt را در مقاله مستقل Robots.txt چیست؟ باز می کنیم.
Sitemap و robots.txt رقیب هم نیستند
گاهی افراد تصور می کنند اگر Sitemap داشته باشند دیگر لینک داخلی مهم نیست یا اگر robots.txt تنظیم شده باشد Sitemap اهمیتی ندارد.
در واقع این ابزارها نقش متفاوتی دارند.
Sitemap: URLهای مهم را معرفی می کند.
robots.txt: Crawl برخی مسیرها را مدیریت می کند.
Internal Links: ساختار واقعی ارتباط صفحات سایت را می سازند.
هر سه می توانند بخشی از معماری Crawl سایت باشند.
Crawl و Index چه تفاوتی دارند؟
این یکی از مهم ترین تفاوت هایی است که باید کاملاً روشن باشد.
Crawling
Googlebot صفحه را دریافت و بررسی می کند.
Indexing
گوگل محتوای Crawl شده را پردازش می کند و درباره ذخیره آن در Search Index تصمیم می گیرد.
پس این سناریو کاملاً امکان پذیر است:
URL پیدا شده
↓
Googlebot صفحه را Crawl کرده
↓
صفحه Index نشده
به همین دلیل در Search Console ممکن است وضعیتی مانند:
Crawled – currently not indexed
ببینید.
یعنی مشکل لزوماً این نیست که Googlebot به صفحه نرسیده است.
مقاله بعدی این خوشه یعنی Indexing چیست؟ چرا صفحات سایت در گوگل ایندکس نمی شوند؟ دقیقاً به این موضوع می پردازد.
آیا Crawl شدن صفحه یعنی گوگل محتوای آن را دوست دارد؟
نه.
Crawling بیشتر یک فرایند دریافت و بررسی است.
Googlebot ممکن است صفحات بسیار باکیفیت، صفحات ضعیف، صفحات Redirect، خطاهای 404 و URLهای بی ارزش را Crawl کند.
تصمیم هایی مثل Indexing و Ranking در مراحل دیگری گرفته می شوند.
بنابراین زیاد Crawl شدن یک URL به تنهایی نشان دهنده کیفیت بالای آن نیست.
Googlebot چند وقت یک بار سایت را Crawl می کند؟
پاسخ ثابت و عمومی ندارد.
یک URL ممکن است چند بار در بازه ای کوتاه Crawl شود، در حالی که URL دیگری مدت بیشتری بررسی نشود.
Googlebot به صورت الگوریتمی Crawl را مدیریت می کند و عواملی مانند تغییرات صفحات و وضعیت سرور می توانند در رفتار Crawl مؤثر باشند.
مثلاً صفحه خبری که مرتب تغییر می کند ممکن است الگوی Crawl متفاوتی نسبت به مقاله ای داشته باشد که سال ها ثابت مانده است.
اما نباید از این موضوع نتیجه بگیریم که یک جدول ثابت مثل:
«گوگل هر سه روز یک بار سایت را Crawl می کند»
وجود دارد.
چنین قانون عمومی ای نداریم.
چرا Googlebot بعضی صفحات را دیر Crawl می کند؟
دلایل مختلفی ممکن است وجود داشته باشد.
لینک داخلی ضعیف
اگر URL جدید در بخش عمیقی از سایت قرار گرفته و هیچ صفحه مهمی به آن لینک نمی دهد، کشف آن می تواند دشوارتر شود.
Sitemap نامناسب
ممکن است URLهای جدید در Sitemap وجود نداشته باشند یا Sitemap با URLهای بی اهمیت پر شده باشد.
مشکلات سرور
اگر Server مرتب خطاهای 5xx بدهد یا کند باشد، Googlebot ممکن است Crawl را کاهش دهد.
گوگل توضیح می دهد Crawlers طوری طراحی شده اند که سایت را بیش از حد تحت فشار قرار ندهند و خطاهای سروری می توانند باعث کاهش Crawl شوند.
URLهای بسیار زیاد
سایت هایی با تعداد عظیمی URL، فیلترها، پارامترها و صفحات تکراری ممکن است Crawl پیچیده تری داشته باشند.
مسدود بودن URL
ممکن است robots.txt یا محدودیت دسترسی مانع Crawl شود.
Server Error چه تأثیری بر Crawl دارد؟
فرض کنید Googlebot درخواست زیر را ارسال می کند:
GET /article/ولی Server پاسخ می دهد:
500 Internal Server Errorاگر این وضعیت مرتب اتفاق بیفتد، Googlebot ممکن است تشخیص دهد Server تحت فشار است و Crawl را کاهش دهد.
گوگل در راهنمای Troubleshooting Crawling به طور مشخص توصیه می کند بررسی شود سایت از نظر ظرفیت پاسخ گویی به Crawl Requestها دچار مشکل نباشد.
این یکی از دلایلی است که سلامت Hosting و Server نیز می تواند برای Technical SEO مهم باشد.
«برای بررسی رفتار Googlebot هنگام فشار روی سرور یا افزایش خطاهای 5xx، مستندات گوگل درباره کاهش Crawl Rate توضیح فنی دقیق تری ارائه می کند.»
آیا سرعت سایت با Crawl ارتباط دارد؟
سرعت سایت را نباید صرفاً به یک عامل Ranking تقلیل داد.
از دید Crawl هم Server باید بتواند Requestهای Googlebot را به شکل مناسب پاسخ دهد.
اگر پاسخ های Server دائماً مشکل داشته باشند، Crawl می تواند تحت تأثیر قرار گیرد.
این موضوع مخصوصاً برای سایت های بسیار بزرگ مهم تر می شود.
Crawl Budget چیست؟
Crawl Budget مفهومی است که به ظرفیت و تقاضای Crawl یک سایت مربوط می شود.
اما یکی از اشتباهات رایج این است که سایت کوچک با چند صد URL تصور کند باید دائماً Crawl Budget را Optimize کند.
برای بسیاری از سایت های کوچک و متوسط، مشکلات ساده تری مثل:
- لینک داخلی بد
- صفحات Orphan
- Robots اشتباه
- URLهای تکراری
- Server Error
اهمیت عملی بیشتری دارند.
خود گوگل Crawl Budget را در مسیر Technical SEO و مدیریت سایت های بزرگ تر به صورت موضوعی تخصصی مطرح می کند. در Learning Path فنی جدید Search Central نیز Crawl Budget در کنار Crawl Directives و Architecture قرار گرفته است.
در مقاله مستقل Crawl Budget چیست؟ این موضوع را جداگانه بررسی خواهیم کرد.
ساختار سایت چه تأثیری بر Crawl دارد؟
یک سایت با معماری منطقی مسیر Crawl واضح تری ایجاد می کند.
مثلاً:
صفحه اصلی
│
├── سئو
│   ├── سئو چیست
│   ├── موتور جستجو چیست
│   │   ├── Crawling چیست
│   │   ├── Indexing چیست
│   │   └── Ranking چیست
کاربر نیز از چنین ساختاری بهتر استفاده می کند.
در مقابل، اگر صدها صفحه ایجاد کرده باشید که هیچ ارتباط موضوعی و Internal Link مشخصی ندارند، هم مدیریت سایت دشوارتر می شود و هم موتور جستجو تصویر ضعیف تری از ارتباط صفحات دریافت می کند.
عمق صفحه در سایت مهم است؟
مفهوم Click Depth یعنی کاربر یا Crawler برای رسیدن به یک URL چند مسیر کلیکی را طی می کند.
این به معنی قانون ثابت مثل:
«همه صفحات باید دقیقاً در سه کلیک باشند»
نیست.
اما صفحات مهم نباید عمداً در ساختار بسیار عمیق و دور از بخش های اصلی سایت دفن شوند.
اگر مقاله ای برای کسب وکار اهمیت زیادی دارد، منطقی است از صفحات مرتبط و Hubهای موضوعی به آن لینک داده شود.
آیا لینک Footer و Menu برای Crawl کافی است؟
ممکن است موتور جستجو بتواند چنین لینک هایی را Crawl کند، اما این سؤال فقط فنی نیست.
باید ببینیم رابطه واقعی موضوعی صفحات چیست.
اگر مقاله Crawling داخل متن مقاله «موتور جستجو چگونه کار می کند؟» لینک شود، این لینک از نظر کاربر بسیار طبیعی تر است؛ چون دقیقاً زمانی که کاربر به مفهوم Crawl می رسد، امکان مطالعه بیشتر فراهم می شود.
لینک داخلی Contextual معمولاً برای تجربه کاربر نیز ارزش بیشتری دارد.
Anchor Text چه نقشی در Crawl دارد؟
Anchor Text متن قابل کلیک لینک است.
مثلاً:
Crawling چیست؟
بهتر از:
اینجا کلیک کنید
اطلاعات بیشتری درباره مقصد لینک ارائه می کند.
گوگل نیز توضیح می دهد Anchor Text به کاربران و Google کمک می کند درباره صفحه مقصد اطلاعات بیشتری به دست آورند.
البته هدف این نیست که تمام Internal Linkها دقیقاً یک Anchor تکراری داشته باشند.
طبیعی بودن متن و ارتباط با Context مهم تر است.
آیا Googlebot همه منابع صفحه را Crawl می کند؟
Googlebot ممکن است برای Rendering صفحه نیاز داشته باشد منابعی مانند:
- JavaScript
- CSS
- تصاویر
را نیز دریافت کند.
اگر منابع ضروری را در robots.txt مسدود کنید، ممکن است موتور جستجو نتواند صفحه را همان طور که انتظار دارید Render کند.
گوگل توصیه می کند منابعی که برای Crawl و Rendering لازم هستند قابل دسترسی باشند.
چگونه بفهمیم گوگل صفحه را Crawl کرده است؟
چند روش وجود دارد.
URL Inspection در Search Console
یکی از ساده ترین راه ها بررسی URL در Google Search Console است.
در این ابزار می توانید اطلاعاتی درباره URL و وضعیت آن در Google دریافت کنید.
Crawl Stats
Search Console برای سایت ها گزارش Crawl Stats نیز ارائه می کند که دید کلی تری درباره فعالیت Googlebot روی سایت می دهد.
Server Logs
برای تحلیل فنی عمیق تر، Logهای Server یکی از منابع بسیار ارزشمند هستند.
در Log می توان Requestهای Googlebot را مشاهده و تحلیل کرد:
Googlebot → /page-a/ → 200
Googlebot → /page-b/ → 301
Googlebot → /old-page/ → 404
این اطلاعات برای سایت های بزرگ بسیار کاربردی است.
آیا می توان Googlebot را مجبور به Crawl کرد؟
به معنای واقعی کلمه خیر.
می توانید شرایط Crawl را بهتر کنید:
- Internal Link ایجاد کنید؛
- Sitemap را به روز کنید؛
- URL را از Search Console درخواست بررسی کنید؛
- مشکلات فنی را برطرف کنید.
اما نمی توانید به Googlebot دستور دهید:
این URL را همین الان Crawl کن و حتماً Index کن.
گوگل نیز تضمین نمی کند حتی با رعایت Search Essentials تمام صفحات Crawl، Index یا Serve شوند.
خطاهای رایج Crawling
1. صفحه Orphan
صفحه منتشر شده ولی هیچ لینک داخلی مناسبی به آن وجود ندارد.
2. robots.txt اشتباه
بخشی از سایت به صورت ناخواسته برای Googlebot مسدود شده است.
مثلاً:
User-agent: *
Disallow: /
این Rule عملاً Crawl کل سایت را برای Crawlers مشمول مسدود می کند.
3. لینک های غیرقابل Crawl
صفحه از طریق عناصر JavaScript غیر استاندارد در دسترس است ولی <a href> مناسبی ندارد.
4. URLهای بی نهایت
فیلتر، Sort، Calendar یا پارامترهای URL می توانند تعداد بسیار زیادی URL ایجاد کنند.
مثلاً:
/product?color=red
/product?color=blue
/product?sort=price
/product?sort=date
اگر کنترل نشوند، فضای Crawl سایت می تواند بسیار پیچیده شود.
5. Redirect Chain
مثلاً:
A → B → C → Dدر بسیاری از مواقع بهتر است لینک ها مستقیماً به مقصد نهایی اشاره کنند.
6. لینک های شکسته
Internal Link به URLی می رود که 404 برمی گرداند.
7. Server Error
خطاهای مکرر 5xx می توانند دسترسی Googlebot را مختل کنند.
چگونه Crawl سایت را بهتر کنیم؟
برای اغلب سایت ها نیازی به تکنیک عجیب وجود ندارد.
چند اصل ساده بسیار مهم تر هستند.
صفحات مهم را لینک کنید
هر صفحه مهم بهتر است حداقل از یک صفحه قابل Crawl دیگر لینک داشته باشد. این توصیه مستقیماً در مستندات Google نیز آمده است.
معماری سایت را ساده نگه دارید
دسته بندی ها، Hubها و صفحات مرتبط باید ساختار قابل درکی داشته باشند.
Sitemap تمیز داشته باشید
Sitemap را با URLهایی پر نکنید که:
- Redirect هستند؛
- 404 هستند؛
- نباید Index شوند؛
- Canonical به URL دیگری دارند.
robots.txt را با احتیاط تغییر دهید
یک Rule اشتباه می تواند بخش بزرگی از سایت را از Crawl خارج کند.
خطاهای سرور را برطرف کنید
Googlebot باید بتواند پاسخ پایدار دریافت کند.
لینک های استاندارد HTML بسازید
مخصوصاً برای Navigation و محتواهای اصلی.
URLهای غیرضروری را کنترل کنید
پارامترها، فیلترها و Faceted Navigation می توانند هزاران URL ایجاد کنند.
یک مثال واقعی از Crawl یک مقاله
فرض کنیم امروز در وبتیک این مقاله را منتشر کرده ایم:
/خزش-گوگل/مرحله اول:
مقاله موتور جستجو چیست؟ را ویرایش می کنیم و به این مقاله لینک می دهیم.
مرحله دوم:
URL را در XML Sitemap قرار می دهیم.
مرحله سوم:
Googlebot در یکی از Crawlهای بعدی صفحه مادر یا Sitemap را بررسی می کند.
مرحله چهارم:
URL جدید کشف می شود.
مرحله پنجم:
Googlebot در زمان مناسب به URL درخواست می فرستد.
Server:
200 OKمرحله ششم:
Googlebot HTML و منابع لازم را دریافت و صفحه را Render می کند.
از اینجا به بعد وارد موضوع دیگری می شویم:
Indexing.
یعنی Crawl موفق هنوز پایان کار نیست.
تفاوت Discovery، Crawling و Indexing
این سه مرحله را این طور به خاطر بسپارید:
| مرحله | معنی |
|---|---|
| Discovery | گوگل از وجود URL باخبر می شود |
| Crawling | Googlebot URL را دریافت و بررسی می کند |
| Indexing | گوگل محتوای صفحه را پردازش می کند و درباره ورود آن به Index تصمیم می گیرد |
مثلاً اگر URL در Sitemap وجود داشته باشد:
گوگل ممکن است آن را Discover کرده باشد ولی هنوز Crawl نکرده باشد.
و اگر Crawl کرده باشد:
ممکن است هنوز Index نشده باشد.
این تفاوت در عیب یابی SEO بسیار مهم است.
Crawling چه ارتباطی با سئو تکنیکال دارد؟
بخش بزرگی از Technical SEO به این سؤال برمی گردد:
آیا موتور جستجو می تواند به صفحات مهم سایت به شکل صحیح دسترسی پیدا کند؟
موضوعاتی مثل:
- robots.txt
- Sitemap
- Status Codes
- Redirectها
- Crawlability
- JavaScript
- معماری سایت
- Server Logs
- Crawl Budget
همگی با Crawl ارتباط دارند.
به همین دلیل اگر قرار است وارد سئو تکنیکال شوید، Crawling یکی از مفاهیمی است که باید کاملاً درک کنید.
Crawling چه چیزی نیست؟
برای جلوگیری از چند سوءبرداشت:
Crawling رتبه بندی نیست.
Googlebot می تواند صفحه ای را Crawl کند که هیچ رتبه قابل توجهی ندارد.
Crawling همان Indexing نیست.
هر صفحه Crawl شده الزاماً Index نمی شود.
Crawling به معنای کیفیت محتوا نیست.
صفحات کم کیفیت نیز ممکن است Crawl شوند.
Sitemap باعث اجبار Crawl نمی شود.
Sitemap فقط به Google در کشف URL کمک می کند.
Request Indexing فرمان فوری نیست.
درخواست Search Console تضمین Crawl یا Index فوری ایجاد نمی کند.
جمع بندی
Crawling یکی از بنیادی ترین مراحل Google Search است.
قبل از اینکه گوگل بتواند محتوای شما را Index کند یا برای Query خاصی رتبه دهد، ابتدا باید URL صفحه را بشناسد و بتواند آن را Crawl کند.
Googlebot URLها را از مسیرهایی مانند:
- Internal Links
- External Links
- Sitemap
- Redirectها
پیدا می کند و سپس بر اساس سیستم های خود تصمیم می گیرد کدام URLها را چه زمانی بررسی کند.
برای بیشتر سایت ها، بهترین راه بهبود Crawl چیزی پیچیده نیست:
ساختار سایت تمیز، لینک داخلی منطقی، Sitemap درست، Server پایدار و جلوگیری از مسدود کردن ناخواسته Googlebot.
اگر صفحه ای Crawl شده ولی هنوز در Google Search دیده نمی شود، مرحله بعدی بررسی Indexing است.
در مقاله بعدی این خوشه بررسی می کنیم که Indexing چیست، گوگل پس از Crawl چه کاری با صفحه انجام می دهد و چرا بعضی صفحات با وجود Crawl شدن وارد Index نمی شوند.

اولین دیدگاه را بنویسید