

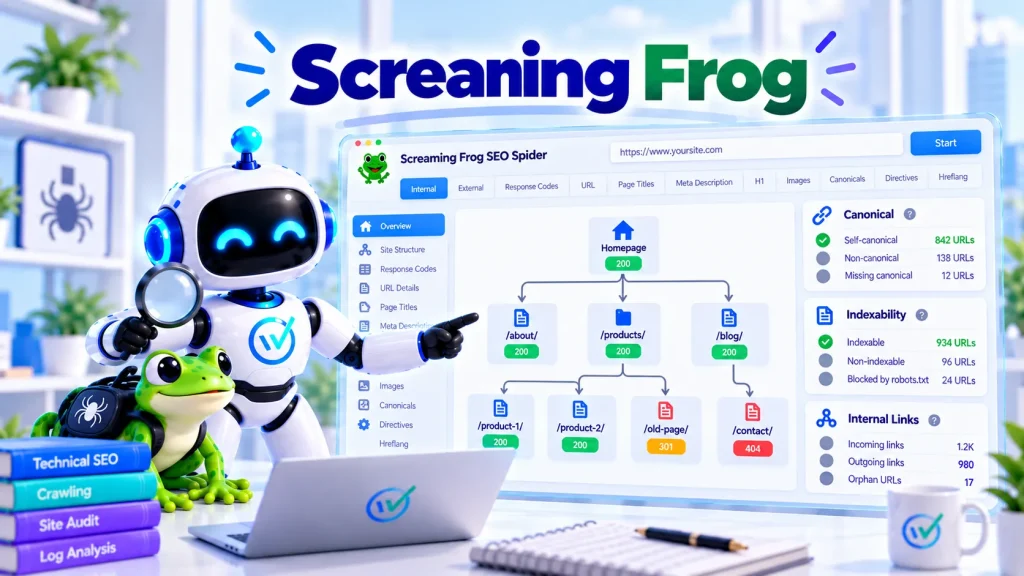
Screaming Frog SEO Spider یکی از شناخته شده ترین ابزارهای Crawl و Technical SEO است. این نرم افزار مانند یک Crawler در سایت حرکت می کند، URLها و لینک ها را دنبال می کند و اطلاعاتی مانند Status Code، Title، Meta Description، Canonical، Indexability، Headingها، Internal Links، تصاویر و بسیاری از عناصر فنی صفحات را در قالب یک Dataset قابل تحلیل جمع آوری می کند.
قدرت اصلی Screaming Frog در این نیست که کنار چند URL عبارت «Error» بنویسد. ارزش واقعی آن زمانی مشخص می شود که بخواهید سایتی با صدها، هزاران یا حتی تعداد بسیار بیشتری URL را به شکل سیستماتیک بررسی کنید.
کاری که برای ۲۰ صفحه شاید بتوان دستی انجام داد، در یک سایت بزرگ بدون Crawler عملاً بسیار دشوار می شود.
اما Screaming Frog یک نکته مهم دارد:
هر چیزی که ابزار Flag می کند الزاماً یک مشکل SEO نیست و هر مشکل SEO نیز الزاماً توسط Screaming Frog قابل تشخیص نیست.
اگر ابزار ۱۰۰۰ Meta Description خالی پیدا کند، نتیجه لزوماً این نیست که اولویت اول پروژه نوشتن ۱۰۰۰ Description است. ممکن است بخش بزرگی از این URLها اصلاً نباید Index شوند، ممکن است Template اشتباهی تولید شده باشد یا مسئله بسیار مهم تری در Crawlability و Architecture وجود داشته باشد.
بنابراین این مقاله فقط آموزش کلیک کردن روی Tabها نیست. هدف این است که بفهمیم Screaming Frog چگونه Crawl می کند، چه داده ای تولید می کند و چطور خروجی آن را تفسیر کنیم.
برای دیدن جایگاه این ابزار در کنار سایر گزینهها و انتخاب Tool Stack مناسب، راهنمای ابزارهای سئو دید مقایسهای کاملتری ارائه میدهد.
Screaming Frog چیست؟
Screaming Frog SEO Spider یک Desktop Crawler است که سایت را با دنبال کردن URLها و لینک ها Crawl می کند و اطلاعات فنی و On-page مربوط به صفحات را استخراج می کند.
در حالت معمول، یک URL شروع به ابزار می دهید و Spider مانند یک خزنده از آن نقطه حرکت می کند.
مثلاً از Homepage:
https://example.com/
لینک های داخلی را پیدا می کند، صفحات مقصد را می خزد، لینک های آنها را پیدا می کند و این فرایند ادامه پیدا می کند.
در Documentation رسمی Screaming Frog نیز Internal Hyperlinkها به طور پیش فرض Crawl و Store می شوند و لینک های داخل <a href> یکی از مسیرهای اصلی Discovery در Spider Mode هستند.
در پایان به جای مجموعه ای از صفحات پراکنده، یک Dataset خواهید داشت که می توانید روی آن Filter، Sort، Export و تحلیل انجام دهید.
Screaming Frog چه اطلاعاتی از سایت استخراج میکند؟
بسته به تنظیمات Crawl، ابزار می تواند اطلاعات بسیار متنوعی جمع آوری کند.
از جمله:
- URL
- Status Code
- Content Type
- Page Title
- Meta Description
- H1 و H2
- Canonical
- Meta Robots
- Indexability
- Word Count
- Crawl Depth
- Inlinks و Outlinks
- Anchor Text
- Redirect
- تصاویر و Alt Text
- Response Time
- Structured Data
- hreflang
- حجم صفحه
- Hash برای تشخیص Duplicateهای دقیق
و موارد دیگر.
همچنین می توان مشخص کرد چه Resourceهایی مانند CSS، JavaScript، Image و Media Crawl یا Store شوند. Documentation رسمی ابزار امکان تنظیم مستقل بسیاری از این موارد را فراهم می کند.
همین انعطاف یکی از دلایلی است که Screaming Frog از یک «Broken Link Checker» ساده بسیار فراتر می رود.
Screaming Frog چه کاری برای SEO انجام میدهد؟
مهم ترین کاربرد آن تبدیل ساختار سایت به داده قابل تحلیل است.
برای مثال به جای اینکه دستی URLها را باز کنید، می توانید سؤال هایی مثل این بپرسید:
- چند صفحه 404 داریم؟
- چه URLهایی Redirect می شوند؟
- آیا Redirect Chain وجود دارد؟
- چه صفحاتی Canonical متفاوت دارند؟
- چه URLهایی
noindexهستند؟ - کدام صفحات Internal Link کمی دارند؟
- چه URLهایی در عمق زیادی از سایت قرار گرفته اند؟
- Title یا H1 تکراری داریم؟
- چه تصاویر بزرگی در سایت وجود دارند؟
- آیا Sitemap شامل URLهای غیرقابل ایندکس است؟
- لینک های شکسته از کدام صفحات ایجاد شده اند؟
Crawler پاسخ نهایی SEO را نمی دهد، اما Dataset لازم برای پاسخ دادن به این سؤال ها را فراهم می کند.
Screaming Frog چگونه سایت را Crawl میکند؟
در Spider Mode، ابزار از URL شروع حرکت می کند و لینک های قابل کشف را دنبال می کند.
این نکته مهم است:
اگر هیچ مسیر لینک قابل دنبال کردنی به یک صفحه وجود نداشته باشد، Crawler معمولی ممکن است آن صفحه را پیدا نکند.
خود Screaming Frog توضیح می دهد که Spider برای Discovery لینک های HTML را از صفحات استخراج می کند و برای رسیدن به صفحه باید مسیری قابل Crawl از نقطه شروع وجود داشته باشد.
این مسئله از نظر SEO نیز بسیار آموزنده است.
اگر Crawler نمی تواند صفحه ای را از مسیر لینک های داخلی پیدا کند، باید بپرسیم:
کاربر و Search Engine چگونه قرار است آن صفحه را کشف کنند؟
البته نبود یک URL در Crawl همیشه به معنی Orphan Page واقعی نیست؛ ممکن است Sitemap، External Link یا روش Discovery دیگری وجود داشته باشد.
ولی می تواند سرنخ مهمی باشد.
Spider Mode و List Mode چه تفاوتی دارند؟
دو Workflow مهم Screaming Frog را باید از هم جدا کرد.
Spider Mode
یک URL شروع می دهید و ابزار سایت را از طریق Link Discovery می خزد.
این حالت برای:
- Site Audit
- Architecture
- Internal Linking
- Crawl Depth
- Discovery
مناسب است.
List Mode
خودتان یک لیست URL به ابزار می دهید.
ابزار همان URLها را بررسی می کند و بسته به Configuration می تواند Redirectها، Canonicalها یا Resourceهای مرتبط را نیز دنبال کند.
List Mode برای مواردی مثل:
- بررسی URLهای Migration
- تست Redirectها
- Audit یک URL List مشخص
- بررسی Sitemap Export
- مقایسه مجموعه URLها
بسیار کاربردی است.
این دو Mode برای دو سؤال متفاوت طراحی شده اند.
نسخه رایگان Screaming Frog چه محدودیتی دارد؟
طبق Documentation فعلی Screaming Frog، نسخه رایگان SEO Spider امکان Crawl حداکثر ۵۰۰ URL در هر Crawl را دارد. نسخه دارای License این محدودیت رایگان را برمی دارد و قابلیت های پیشرفته بیشتری ارائه می کند.
برای سایت کوچک یا یادگیری ابزار، ۵۰۰ URL ممکن است کافی باشد.
اما باید دقت کنید:
۵۰۰ URL الزاماً به معنی ۵۰۰ «صفحه HTML» نیست.
بسته به Configuration، ابزار ممکن است Resourceهای دیگری مانند:
- Image
- CSS
- JavaScript
را هم Crawl کند.
در نتیجه اگر هدف فقط Audit صفحات HTML است، تنظیم Crawl اهمیت پیدا می کند.
اولین Crawl را چگونه اجرا کنیم؟
برای یک Crawl ساده:
- Screaming Frog را باز کنید.
- آدرس اصلی سایت را وارد کنید.
- مطمئن شوید Mode روی Spider است.
- Crawl را شروع کنید.
- اجازه دهید فرایند کامل شود.
- بعد از پایان، به جای رفتن مستقیم سراغ Errors، ابتدا Scope داده را بررسی کنید.
قدم ششم بسیار مهم است.
قبل از تحلیل باید مطمئن شوید واقعاً همان چیزی را Crawl کرده اید که قصد داشتید.
قبل از تحلیل Crawl چه چیزهایی را بررسی کنیم؟
آیا Host درست Crawl شده است؟
مثلاً:
www.example.com
با:
example.com
ممکن است رفتار متفاوت داشته باشد.
همچنین Subdomainها بسته به Configuration می توانند Internal یا External در نظر گرفته شوند.
آیا Crawl کامل شده است؟
اگر Crawl را وسط کار متوقف کرده باشید، داده ناقص است.
آیا robots.txt روی Crawl اثر گذاشته؟
ممکن است بخشی از URLها طبق robots.txt قابل Crawl نباشند.
آیا سایت JavaScript-heavy است؟
اگر Links یا Content فقط بعد از JavaScript Rendering ایجاد شوند، Crawl خام HTML ممکن است تصویر کاملی ندهد.
آیا Resourceهای غیرضروری Crawl شده اند؟
اگر فقط صفحات HTML برایتان مهم هستند، Crawl گسترده Image و Resource می تواند Dataset را شلوغ کند.
اول Dataset را بفهمید؛ بعد Issueها را تحلیل کنید.
تب Internal چه اطلاعاتی میدهد؟
Internal یکی از Tabهای اصلی Screaming Frog است و URLهایی را نشان می دهد که Tool آنها را Internal تشخیص داده است.
این Tab معمولاً نقطه خوبی برای درک کلی Crawl است.
اطلاعاتی مثل:
- Address
- Content Type
- Status Code
- Indexability
- Title
- Meta
- Word Count
- Crawl Depth
را می توان در سطح URL بررسی کرد.
اما Internal به تنهایی Report «مشکلات» نیست.
این بیشتر Master Dataset شماست.
تحلیل Response Codeها در Screaming Frog
Response Codes برای بررسی HTTP Responseها استفاده می شود.
در اینجا URLها را می توان بر اساس وضعیت هایی مثل:
- 2xx
- 3xx
- 4xx
- 5xx
بررسی کرد.
2xx
معمولاً Response موفق.
اما 200 بودن به تنهایی به معنی سالم بودن SEO صفحه نیست.
صفحه ممکن است:
noindex- Duplicate
- Canonicalized
- Thin
- یا از نظر Intent نامناسب
باشد.
3xx
Redirect.
وجود Redirect خودبه خود مشکل نیست.
مثلاً Redirect از URL قدیمی به مقصد جدید می تواند کاملاً صحیح باشد.
سؤال مهم تر:
- مقصد درست است؟
- Chain ساخته شده؟
- Loop داریم؟
- لینک های داخلی هنوز به URL Redirectشده اشاره می کنند؟
4xx
Client Error.
404 معروف ترین نمونه است.
اما هر 404 نیز الزاماً مشکل SEO نیست.
URL حذف شده ای که جایگزین ندارد می تواند درست باشد که 404 یا 410 شود.
مشکل زمانی جدی تر می شود که:
- لینک داخلی به آن وجود دارد؛
- URL مهمی اشتباهی حذف شده؛
- یا باید Redirect می شده است.
5xx
Server Error.
این گروه معمولاً نیازمند توجه بیشتری است، مخصوصاً اگر URLهای مهم یا تعداد زیادی صفحه را درگیر کند.
ولی حتی اینجا هم باید بررسی کنیم خطا Persistent است یا موقت.
چگونه Broken Internal Link پیدا کنیم؟
فقط دیدن لیست 404ها کافی نیست.
سؤال عملی این است:
کدام صفحات سایت به این 404 لینک داده اند؟
در Screaming Frog می توانید URL خطادار را انتخاب کنید و بخش Inlinks را ببینید.
حالا Source Page و Anchor Text مشخص می شود.
در این مرحله Fix واقعی می تواند یکی از اینها باشد:
- اصلاح URL لینک
- حذف لینک
- جایگزینی با مقصد درست
- یا در موارد مناسب Redirect
این Workflow بهتر از ساخت Redirect برای هر 404 بدون Context است.
Redirect Chain چیست؟
Redirect Chain زمانی رخ می دهد که URL به جای رسیدن مستقیم به مقصد، از چند Redirect عبور کند.
مثلاً:
A → B → C → D
در بسیاری از موارد بهتر است لینک های داخلی و Mappingها مستقیماً به مقصد نهایی اشاره کنند.
Screaming Frog Reportهای مربوط به Redirect را برای بررسی Chainها و مقصدهای نهایی ارائه می کند و در List Mode نیز امکان Follow Redirect تا مقصد نهایی وجود دارد.
اما وجود یک Redirect Chain کوچک همیشه بحران SEO نیست.
اولویت به:
- حجم
- صفحات درگیر
- Crawl Frequency
- User Impact
- Migration Context
وابسته است.
Page Titles را چگونه Audit کنیم؟
Screaming Frog می تواند Title تمام صفحات را استخراج و مواردی مثل:
- Missing
- Duplicate
- طول های غیرعادی
- یا Patternهای دیگر
را Filter کند.
اما اینجا یکی از مهم ترین دام های Tool-driven SEO وجود دارد.
فرض کنید ۴۰۰ عنوان Duplicate پیدا شده است.
آیا باید دستی ۴۰۰ Title جدید بنویسیم؟
نه لزوماً.
ابتدا ببینید URLها چیست.
اگر تمام آنها Filter Page یا Duplicateهای غیرقابل ایندکس باشند، مشکل اصلی Title نیست.
شاید Architecture یا Indexability مسئله اصلی باشد.
Tool Pattern را پیدا کرده؛ تشخیص Root Cause هنوز با شماست.
Meta Description را چگونه تحلیل کنیم؟
منطق مشابه Title است.
Missing یا Duplicate Meta Description می تواند ارزش بررسی داشته باشد، مخصوصاً روی صفحات مهم Indexable.
اما Missing Meta Description روی:
- صفحات
noindex - Duplicateها
- Utility Pageها
ممکن است Priority ناچیزی داشته باشد.
همچنین Google الزاماً Meta Description نوشته شده را در Snippet نمایش نمی دهد.
پس Report ابزار را به Task List کورکورانه تبدیل نکنید.
H1 و H2 چه کمکی میکنند؟
Screaming Frog می تواند Headingهای صفحات را در مقیاس استخراج کند.
این برای پیدا کردن Patternهایی مثل:
- Missing H1
- Duplicate H1
- چند H1
- ساختار Template
مفید است.
ولی دوباره:
وجود دو H1 به تنهایی Disaster SEO نیست.
HTML مدرن اجازه ساختارهای متنوعی می دهد.
سؤال بهتر این است:
آیا Heading Structure واقعاً باعث ابهام محتوا یا مشکل Template شده است؟
Audit Tool باید شروع بررسی باشد، نه پایان آن.
Canonical را چگونه با Screaming Frog بررسی کنیم؟
یکی از کاربردهای مهم ابزار تحلیل Canonical است.
Crawler می تواند:
- Canonical موجود در صفحه
- Canonical Destination
- Indexability
- و Relationship بین URLها
را استخراج کند.
در Configuration پیش فرض، Screaming Frog Canonicalها را Store و Crawl می کند و حتی می تواند URLهای داخل Canonical را برای Discovery دنبال کند.
چند سؤال مهم در Audit:
- صفحه Self-canonical دارد؟
- Canonical به Redirect اشاره می کند؟
- Canonical به 404 می رود؟
- URLهای مهم به صفحه دیگری Canonical شده اند؟
- Chain در Canonical وجود دارد؟
- HTTP و HTML Canonical Conflict دارند؟
اما Canonical فقط یک Hint است.
انتخاب نهایی Canonical توسط Search Engine می تواند متفاوت باشد.
برای تحلیل واقعی وضعیت Google، Search Console نیز باید وارد بررسی شود.
Indexability در Screaming Frog چیست؟
یکی از ستون های بسیار مهم ابزار:
Indexability
است.
Tool بر اساس سیگنال هایی که در Crawl می بیند مشخص می کند URL از نظر فنی Indexable به نظر می رسد یا خیر.
دلایل Non-indexable بودن می توانند شامل مواردی مثل:
noindex- Redirect
- Canonical به URL دیگر
- Error Response
باشند.
این Classification برای تحلیل سریع بسیار مفید است.
اما نباید آن را معادل:
Indexed in Google
بدانیم.
Screaming Frog می گوید URL از نظر داده Crawl چه وضعیتی دارد.
Search Console می تواند بگوید Google درباره Indexing آن چه گزارش کرده است.
این دو مفهوم متفاوت اند.
Meta Robots را چگونه بررسی کنیم؟
Screaming Frog می تواند Meta Robots و X-Robots-Tag را استخراج کند.
برای Audit باید Patternها را بررسی کنید.
مثلاً:
- صفحه مهمی
noindexشده؟ - Template اشتباهی
nofollowدارد؟ - Directives ناسازگار وجود دارد؟
اما باز هم هدف:
حذف همه noindexها
نیست.
بعضی صفحات کاملاً درست است که Index نشوند.
برای درک این Context، مفهوم ایندکس گوگل باید جدا از Data Tool فهمیده شود.
Crawl Depth چیست؟
Crawl Depth نشان می دهد ابزار برای رسیدن از Start URL به یک URL چند سطح لینک را طی کرده است.
به طور ساده:
Homepage → Depth 0
صفحه ای که مستقیماً از Homepage لینک شده → Depth 1
صفحه ای که از آن صفحه کشف شده → Depth 2
و الی آخر.
این Metric می تواند برای تحلیل Architecture و Internal Linking مفید باشد.
اگر صفحه ای Business-critical در Depth بسیار بالا قرار دارد، سؤال ایجاد می شود:
آیا این صفحه در معماری سایت به اندازه اهمیتش قابل دسترسی است؟
اما Crawl Depth را هم نباید به قانون مکانیکی تبدیل کرد.
اینکه:
«هر صفحه حتماً باید حداکثر سه Click از Homepage فاصله داشته باشد»
بدون Context معماری همیشه قابل دفاع نیست.
Inlinks چرا مهم اند؟
Inlinks نشان می دهد چه URLهایی به یک صفحه لینک داده اند.
برای Internal Linking Audit این داده بسیار ارزشمند است.
با آن می توان:
- صفحات با Internal Link کم
- Broken Destinationها
- Anchor Textها
- Source Pageهای Link
- و Patternهای معماری
را بررسی کرد.
اما تعداد Inlink به تنهایی معیار اهمیت نیست.
ده لینک Contextual از صفحات مرتبط ممکن است از صد لینک تکراری Template ارزش تحلیلی بیشتری داشته باشد.
پس Count را کنار Position و Context لینک ببینید.
آیا Screaming Frog صفحات Orphan را پیدا میکند؟
یک Crawl عادی فقط URLهایی را می شناسد که از مسیر Discovery خودش پیدا کرده باشد.
Orphan Page دقیقاً ممکن است صفحه ای باشد که از شبکه لینک داخلی Crawl کشف نمی شود.
برای پیدا کردن چنین URLهایی باید Datasetهای دیگر را با Crawl ترکیب کرد.
مثلاً:
- XML Sitemap
- Google Analytics
- Google Search Console
- URL List
Screaming Frog امکان Integration با Google Analytics و Search Console را دارد و می تواند این داده ها را در Crawl وارد کند.
اگر URL در Search Console یا Analytics وجود داشته باشد ولی Crawler از لینک های داخلی آن را پیدا نکند، می تواند Candidate مناسبی برای بررسی Orphan بودن باشد.
XML Sitemap را چگونه Audit کنیم؟
Screaming Frog می تواند Sitemapها را نیز وارد Crawl Analysis کند.
طبق Configuration رسمی، Crawl کردن XML Sitemap در Spider Mode به صورت پیش فرض فعال نیست و می توان Auto Discovery از robots.txt یا Sitemapهای مشخص را فعال کرد.
بعد می توان سؤال هایی مثل این پرسید:
- URL داخل Sitemap، 200 است؟
- Indexable است؟
- Redirect شده؟
- Canonical به URL دیگری دارد؟
- در Crawl داخلی هم پیدا می شود؟
- URL مهمی خارج از Sitemap است؟
Sitemap باید مجموعه ای تمیز از URLهای Canonical و مناسب Indexing باشد.
برای مفهوم خود Sitemap، راهنمای نقشه سایت XML مکمل طبیعی این تحلیل است.
تصاویر را چگونه بررسی کنیم؟
Screaming Frog می تواند Image URLها را Crawl و اطلاعات مربوط به آنها را استخراج کند.
این قابلیت برای پیدا کردن:
- Imageهای سنگین
- Broken Image
- Missing Alt
- Altهای خاص
- Image URLهای Redirectشده
مفید است.
اما Missing Alt را نیز نباید به Task ماشینی تبدیل کرد.
همه تصاویر الزاماً Alt توصیفی نیاز ندارند.
تصاویر تزئینی ممکن است Alt خالی مناسب داشته باشند.
هدف Alt Text کمک به Accessibility و انتقال مفهوم تصویر در Context مناسب است، نه پر کردن تمام Cellهای Excel.
Screaming Frog و JavaScript
در Crawl استاندارد Text Only، ابزار Raw HTML را بررسی می کند و JavaScript Client-side را مانند Browser کامل Render نمی کند.
برای سایت هایی که محتوا یا لینک های مهم را با JavaScript تولید می کنند، این مسئله می تواند باعث ناقص شدن Crawl شود.
Screaming Frog حالت JavaScript Rendering دارد که صفحه را با Headless Chrome Render می کند و از Rendered HTML نیز Content و Link استخراج می کند.
این قابلیت برای سایت های JavaScript-heavy مهم است.
آیا همیشه باید JavaScript Rendering را فعال کنیم؟
نه.
JavaScript Rendering Crawl را:
- سنگین تر
- کندتر
- و Resource-intensiveتر
می کند.
اگر سایت Server-rendered است و Raw HTML تمام Content و Linkهای مهم را دارد، Text Only معمولاً سریع تر و کافی تر است.
JavaScript Rendering زمانی ارزشمندتر است که سؤال مشخصی داشته باشید:
- آیا Content فقط بعد از JS ظاهر می شود؟
- لینک ها Client-side هستند؟
- Metadata بعد از Render تغییر می کند؟
- Raw و Rendered HTML تفاوت مهم دارند؟
بهتر است Rendering Mode را بر اساس معماری سایت انتخاب کنید.
چگونه بفهمیم سایت به JavaScript Crawl نیاز دارد؟
یک تست ساده:
یک URL را در Raw HTML و Rendered DOM مقایسه کنید.
اگر:
- محتوای اصلی
- لینک های Navigation
- Canonical
- Internal Links
- یا عناصر SEO مهم
فقط بعد از JavaScript ظاهر شوند، Rendering اهمیت پیدا می کند.
همچنین اگر Crawler استاندارد تعداد بسیار کمتری URL نسبت به انتظار پیدا کند، JavaScript می تواند یکی از فرضیه ها باشد.
ولی تنها فرضیه نیست.
robots.txt، nofollow، Authentication و Architecture نیز باید بررسی شوند.
robots.txt در Screaming Frog
Crawler می تواند رفتار Crawl را نسبت به robots.txt کنترل و URLهای Blocked را گزارش کند.
Screaming Frog همچنین امکان Custom Robots را برای تست Directiveهای متفاوت بدون تغییر فایل Live فراهم می کند. Documentation رسمی تأکید می کند تغییر Custom Robots داخل Tool روی فایل واقعی سایت اثر نمی گذارد.
این قابلیت برای آزمایش بسیار مفید است.
مثلاً قبل از تغییر Production می توانید ببینید یک Rule جدید چه URLهایی را Block خواهد کرد.
آیا باید robots.txt را Ignore کنیم؟
در Auditهای مشخص گاهی Ignore کردن robots.txt می تواند برای مشاهده URLهای پشت Directive مفید باشد.
اما باید بدانید در آن حالت دیگر Crawl Tool رفتار واقعی Search Engine تحت Rule فعلی را شبیه سازی نمی کند.
پس اگر robots را Ignore کردید، Dataset را با Context صحیح تفسیر کنید.
ابزار نباید شرایط آزمایش را از تحلیل جدا کند.
Custom Search چیست؟
یکی از قابلیت های قدرتمند Screaming Frog امکان Search کردن Pattern دلخواه در HTML است.
Documentation رسمی اجازه می دهد تا تعداد زیادی Search Filter بر اساس Text یا Regex ساخته شود و Raw یا Rendered HTML بررسی شود.
برای ساخت یا اصلاح Pattern قبل از وارد کردن آن در Custom Search، ابزار تست و دیباگ Regex کمک میکند Matchها و Capture Groupها را روی متن نمونه بررسی کنید.
مثلاً می توانید پیدا کنید:
- آیا Analytics Tag روی تمام صفحات هست؟
- کدام صفحات عبارت خاصی دارند؟
- Schema مشخصی کجا وجود دارد؟
- کدام Template Code قدیمی را دارد؟
- آیا Snippet مشخصی فراموش شده؟
این قابلیت Screaming Frog را از Crawler ساده به ابزار QA عمومی وب نزدیک می کند.
Custom Extraction چیست؟
گاهی داده ای که نیاز دارید Column آماده ندارد.
مثلاً می خواهید از تمام صفحات:
- Product ID
- Author
- Publish Date
- Price
- Breadcrumb
- Element سفارشی
استخراج کنید.
Screaming Frog می تواند با روش هایی مثل:
- XPath
- CSS Path
- Regex
داده سفارشی استخراج کند. Quick Start رسمی نیز Custom Extraction را برای جمع آوری اطلاعات دلخواه از HTML معرفی می کند.
برای Auditهای تخصصی این قابلیت بسیار قدرتمند است.
اتصال Screaming Frog به Search Console چه فایده ای دارد؟
Crawler می گوید ساختار سایت چگونه است.
Search Console می گوید صفحات در Google Search چه Performanceای داشته اند.
ترکیب این دو می تواند سؤال های بسیار بهتری بسازد.
مثلاً:
کدام URLهای دارای Organic Click در Crawl داخلی پیدا نشده اند؟
کدام صفحات Indexable هیچ Impression ندارند؟
کدام صفحات با Crawl Depth بالا همچنان Traffic مهمی دارند؟
کدام URLهای غیرقابل Index داده Search دارند؟
Screaming Frog Integration رسمی با Search Console را برای اضافه کردن Search Data به URLهای Crawl فراهم می کند.
این Integration جای Search Console را نمی گیرد؛ داده آن را به Dataset Crawl اضافه می کند.
اتصال Google Analytics چه کمکی میکند؟
با Integration Analytics می توانید Metricهای مربوط به رفتار کاربران را کنار Crawl Data قرار دهید.
این برای تحلیل صفحاتی که:
- Internal Link کمی دارند ولی Traffic بالا دارند؛
- Crawlable هستند ولی هیچ Usage ندارند؛
- یا در Audit Content نیازمند Context بیشتری هستند
مفید است.
اما Traffic پایین به تنهایی دلیل حذف صفحه نیست.
داده Analytics فقط یکی از ورودی هاست.
اتصال PageSpeed Insights
Screaming Frog می تواند با API PageSpeed Insights نیز Integrate شود و داده Performance را برای URLها وارد Crawl کند. قابلیت Integration با GA، GSC و PSI در راهنمای رسمی ابزار ارائه شده است.
این روش برای مقیاس مفید است.
به جای تست دستی تک تک URLها، می توان Performance Data را برای نمونه یا مجموعه ای از صفحات کنار اطلاعات Technical آنها قرار داد.
اما برای Debug عمیق Performance هنوز PSI و DevTools ابزارهای مناسب تری هستند.
آیا Screaming Frog جای Search Console را میگیرد؟
نه.
Screaming Frog سایت را از دید Crawler خودش بررسی می کند.
Search Console اطلاعاتی درباره تعامل Google با سایت و Performance در Search ارائه می دهد.
مثلاً Screaming Frog می تواند بگوید:
«این URL در Crawl فعلی Indexable به نظر می رسد.»
اما فقط Search Console می تواند گزارش دهد Google چه وضعیت Indexingای برای همان URL ثبت کرده است.
این دو مکمل اند.
آیا Screaming Frog جای Site Audit کامل را میگیرد؟
نه.
Screaming Frog یکی از مهم ترین ابزارهای Technical Audit است، ولی Audit خود ابزار نیست.
یک ممیزی واقعی ممکن است شامل:
- Search Console
- Analytics
- Crawl
- Log Data
- Sitemap
- SERP
- Manual Inspection
- Performance
- Architecture
باشد.
Screaming Frog یکی از Data Sourceهای اصلی این فرایند است.
برای فرایند کامل تر، مقاله ممیزی سئو تکنیکال Scope جداگانه ای دارد.
تب Issues در Screaming Frog را چگونه بخوانیم؟
نسخه های جدید Screaming Frog بخش Issues دارند که مشکلات و فرصت های مختلف را گروه بندی می کند.
این بخش برای Orientation سریع مفید است.
اما نباید آن را:
To-do List قطعی SEO
در نظر بگیریم.
اگر Tool ۱۲۰ Issue نشان می دهد، هدف صفر کردن ۱۲۰ عدد نیست.
بهتر است آنها را بر اساس سه سؤال اولویت بندی کنیم:
آیا Issue واقعی است؟
ممکن است Tool Context کامل Business را نداند.
چه تعداد URL مهم را درگیر کرده؟
مشکل Template کل سایت مهم تر از صفحه آزمایشی متروکه است.
Impact چیست؟
آیا مسئله:
- Crawl
- Indexing
- User Experience
- Internal Architecture
- یا Business-critical Page
را تحت تأثیر قرار می دهد؟
Priority از Impact می آید، نه رنگ Alert.
چگونه Crawl را به Action Plan تبدیل کنیم؟
یک Workflow حرفه ای می تواند این طور باشد.
مرحله ۱: Scope Crawl را اعتبارسنجی کنید
آیا Dataset درست است؟
مرحله ۲: Indexable HTML را جدا کنید
برای بسیاری از Auditها این گروه مهم ترین نقطه شروع است.
مرحله ۳: Response Codeها
404، 5xx، Redirect و Chainها.
مرحله ۴: Indexability و Directives
noindex، Canonical و Robots.
مرحله ۵: Architecture
Crawl Depth، Inlinks و صفحات کم لینک.
مرحله ۶: On-page Patterns
Title، Meta، H1 و Duplicateها.
مرحله ۷: Sitemap
آیا Sitemap و Crawl با هم هم راستا هستند؟
مرحله ۸: External Data
Search Console، Analytics و PSI را در صورت نیاز اضافه کنید.
مرحله ۹: Pattern پیدا کنید
به جای Fix کردن URL به URL، Root Cause Template را پیدا کنید.
مرحله ۱۰: Prioritize
Impact × Scale × Effort.
این رویکرد Dataset را به برنامه عملی تبدیل می کند.
چرا Pattern مهمتر از URL منفرد است؟
فرض کنید ۴۰۰ URL Title تکراری دارند.
دو روش داریم.
روش اول:
۴۰۰ Task بسازیم.
روش دوم:
ببینیم همه URLها از یک Template ساخته شده اند یا نه.
اگر Root Cause Template باشد، یک Fix می تواند ۴۰۰ Issue را حل کند.
Crawler در مقیاس ارزشمند است، چون Pattern نشان می دهد.
اگر از آن فقط برای ساخت لیست URL استفاده کنیم، بخش بزرگی از قدرتش را از دست داده ایم.
Crawl Depth بالا همیشه بد است؟
نه.
این Metric باید کنار Importance صفحه دیده شود.
صفحه Legal کم اهمیت در Depth 5 شاید مسئله بزرگی نباشد.
صفحه خدمات اصلی در Depth 5 سؤال برانگیزتر است.
همین منطق درباره Inlink Count نیز وجود دارد.
هدف این نیست که تمام URLها ساختار یکسان داشته باشند.
معماری باید اهمیت واقعی صفحات را منعکس کند.
آیا تعداد لینک داخلی زیاد Error است؟
نه به طور مطلق.
Screaming Frog می تواند صفحات با تعداد بالای Internal Outlink را Flag کند و حتی Threshold این Filter قابل تنظیم است.
اما عدد زیاد به تنهایی دلیل حذف لینک نیست.
مثلاً یک Mega Menu یا Hub Page ممکن است به طور طبیعی لینک های زیادی داشته باشد.
سؤال بهتر:
- لینک ها مفیدند؟
- Crawlable هستند؟
- معماری را شلوغ کرده اند؟
- Boilerplate غیرضروری اند؟
- Context دارند؟
باز هم Context قبل از Count.
Anchor Text را میتوان با Screaming Frog بررسی کرد؟
بله.
Crawler می تواند Inlinkها و Anchor Textهای داخلی را استخراج کند.
این برای Audit Internal Linking بسیار مفید است.
می توان بررسی کرد:
- چه صفحاتی به Target لینک داده اند؛
- Anchorهای تکراری چیست؛
- لینک از چه Contextی آمده؛
- و آیا Sourceهای مناسب وجود دارند.
اما Screaming Frog نمی تواند به تنهایی تصمیم بگیرد یک Anchor «طبیعی» است یا نه.
این بخش نیازمند خواندن Context محتواست.
یعنی دقیقاً همان جایی که Data Tool باید با Editorial Judgment ترکیب شود.
چگونه Crawl دو زمان مختلف را مقایسه کنیم؟
یکی از Workflowهای حرفه ای این است که Crawl را قبل و بعد از تغییر ذخیره و Compare کنیم.
Screaming Frog قابلیت Crawl Comparison دارد که برای مشاهده Issueها و تغییرات بین Crawlها استفاده می شود. Quick Start رسمی نیز Compare Crawls و مقایسه Staging با Production را از قابلیت های ابزار معرفی می کند.
این قابلیت برای مواردی مثل:
- Migration
- Redesign
- Technical Fix
- Template Change
ارزش زیادی دارد.
مثلاً بعد از Migration می توانید بفهمید:
- چند URL 404 جدید شده؛
- Titleها تغییر کرده اند؛
- Canonicalها عوض شده اند؛
- Internal Linkها کم شده اند.
Staging را میتوان Crawl کرد؟
بله، Screaming Frog از Crawl محیط هایی با Authentication نیز پشتیبانی می کند.
این قابلیت برای QA قبل از Release بسیار مفید است.
به جای اینکه مشکل را بعد از انتشار پیدا کنید، می توانید نسخه Staging را Crawl و با Production مقایسه کنید.
برای پروژه های Migration یا Redesign این یکی از Workflowهای بسیار ارزشمند است.
سرعت Crawl را چقدر بالا ببریم؟
Crawler می تواند Request زیادی برای Server ایجاد کند.
به همین دلیل نباید صرفاً برای تمام شدن سریع تر Crawl، Speed را تا حد ممکن بالا برد.
اگر Server ضعیف باشد ممکن است:
- 5xx
- Timeout
- Rate Limit
- یا رفتار غیرعادی
ایجاد شود.
این مشکلات ممکن است حتی Dataset Audit را مخدوش کنند.
Crawl Speed باید با ظرفیت سایت هماهنگ شود.
برای Productionهای حساس، رویکرد محافظه کارانه مناسب تر است.
پنج اشتباه رایج در Screaming Frog
۱. تبدیل تمام Issues به Task
Tool Priority کسب وکار را نمی داند.
۲. Crawl کردن بدون فهم Scope
Dataset اشتباه، تحلیل اشتباه می سازد.
۳. تصور اینکه 200 یعنی صفحه سالم است
HTTP فقط یک لایه است.
۴. استفاده از Text Only برای سایت JavaScript-heavy
ممکن است Content و Linkهای مهم دیده نشوند.
۵. اصلاح URL به URL بهجای Root Cause
قدرت اصلی Crawler در پیدا کردن Pattern است.
اشتباه مهم دیگر: گزارش دادن فقط تعداد Error
گزارشی مثل:
«۳۷۲ Missing Meta Description داریم.»
به تنهایی ارزش تحلیلی محدودی دارد.
گزارش بهتر:
«۳۷۲ URL بدون Meta Description شناسایی شد؛ ۳۲۰ مورد متعلق به صفحات Filter دارای noindex هستند و نیاز به اقدام ندارند. ۵۲ URL Indexable باقی می ماند که ۱۴ مورد Landing Page مهم اند و برای آنها اصلاح Metadata پیشنهاد می شود.»
این تفاوت بین:
Tool Output
و:
SEO Analysis
است.
یک سناریوی واقعی از Crawl
فرض کنید یک سایت فروشگاهی را Crawl می کنیم.
نتیجه:
- ۱۸ هزار URL کشف شده؛
- ۶ هزار URL Indexable HTML؛
- ۷ هزار Filter URL دارای
noindex؛ - ۸۰۰ Redirect؛
- ۱۲۰ URL با 404؛
- ۷۰۰ Page Title تکراری.
اگر مستقیم سراغ Issue Count برویم، پروژه بسیار بزرگ به نظر می رسد.
اما بعد از تحلیل:
۷۰۰ Title Duplicate تقریباً همگی متعلق به Filterهای noindex هستند.
۱۲۰ مورد 404 شامل:
- ۹۰ External Resource قدیمی
- ۲۰ Internal Link اشتباه
- ۱۰ Product حذف شده
است.
۸۰۰ Redirect نیز بیشتر Redirectهای قدیمی Migration هستند، اما فقط ۶۰ مورد هنوز Internal Inlink دارند.
حالا Action Plan واقعی می شود:
- ۲۰ Broken Internal Link اصلاح شوند؛
- ۶۰ Internal Link مستقیماً به Final URL تغییر کنند؛
- وضعیت ۱۰ Product حذف شده بررسی شود؛
- Titleهای صفحات
noindexفعلاً Priority نباشند.
Crawler همان داده را داشت.
تفاوت را تفسیر ایجاد کرد.
چه زمانی Screaming Frog ابزار مناسبی نیست؟
اگر سؤال شما این است:
کاربران با چه Queryهایی سایت را پیدا می کنند؟
→ Search Console
کاربران بعد از ورود چه می کنند؟
→ Google Analytics
تجربه واقعی Core Web Vitals چیست؟
→ PageSpeed Insights / CrUX
رقبا برای چه Keywordهایی Visibility دارند؟
→ ابزار Competitive Research
چه بک لینک هایی به رقبا داده شده؟
→ Backlink Tool
Screaming Frog برای Site Crawl و استخراج ساختار فنی بسیار قدرتمند است، اما نباید از آن انتظار پاسخ تمام سؤال های SEO را داشت.
Screaming Frog برای چه کسانی مناسب است؟
این ابزار مخصوص Technical SEO نیست.
گروه های مختلف می توانند از آن استفاده کنند:
متخصص SEO
برای Technical Audit و Architecture.
Content SEO
برای Metadata، Internal Linking و Content Inventory.
Developer
برای QA و Regression.
Migration Team
برای Redirect و URL Mapping.
Agency
برای Audit مقیاس پذیر Clientها.
ولی عمق استفاده هر نقش متفاوت است.
برای شروع کدام بخش ها را یاد بگیریم؟
اگر تازه کار هستید، لازم نیست از روز اول Custom Extraction یا API Integration یاد بگیرید.
ابتدا روی اینها مسلط شوید:
- اجرای Crawl صحیح
- Internal
- Response Codes
- Indexability
- Canonical
- Inlinks
- Crawl Depth
- Page Titles و Meta
- Export داده
- ارتباط Issue با Context
وقتی این پایه ها را بفهمید، قابلیت های پیشرفته تر معنی پیدا می کنند.
اجرای این موضوع در پروژه واقعی: اگر هدف شما تبدیل این نکته به اصلاحات واقعی در سایت است، صفحه بهینهسازی سایت برای گوگل وبتیک دامنه خدمات فنی، محتوایی و تحلیلی پروژه را توضیح میدهد.
جمعبندی
Screaming Frog SEO Spider یک Crawler قدرتمند برای تبدیل ساختار سایت به Dataset قابل تحلیل است.
می تواند اطلاعاتی درباره:
- Response Code
- Redirect
- Canonical
- Indexability
- Meta Robots
- Internal Links
- Crawl Depth
- Title و Heading
- Images
- Sitemap
- JavaScript Rendering
و بسیاری از عناصر دیگر جمع آوری کند.
نسخه رایگان فعلی Crawl را به ۵۰۰ URL محدود می کند و نسخه Licensed قابلیت ها و ظرفیت بسیار بیشتری برای Auditهای حرفه ای ارائه می دهد.
اما مهارت اصلی Screaming Frog یاد گرفتن Tabها نیست.
مهارت واقعی این است که بدانیم:
کدام داده فقط یک Observation است، کدام Pattern واقعاً مسئله ایجاد کرده و کدام مشکل بیشترین Impact را روی صفحات مهم سایت دارد.
اگر یک اصل را از این راهنما حفظ کنیم، بهتر است این باشد:
Screaming Frog مشکل را به شما نشان می دهد؛ اولویت و راه حل را Context سایت تعیین می کند.
وقتی با این رویکرد از ابزار استفاده شود، Site Crawl از یک لیست طولانی Error به یکی از قدرتمندترین روش ها برای فهم Architecture و سلامت فنی یک وب سایت تبدیل می شود.

اولین دیدگاه را بنویسید