

فرض کنید یک سایت شرکتی با 400 صفحه دارید و هر بار که مقاله جدیدی منتشر می کنید، Google طی مدت معقولی آن را پیدا و Crawl می کند. در سمت دیگر، یک فروشگاه اینترنتی بزرگ را در نظر بگیرید که صدها هزار URL برای محصولات، دسته بندی ها، فیلترها، مرتب سازی ها و پارامترهای مختلف دارد؛ در حالی که بخشی از صفحات مهم آن دیر Crawl می شوند.
برای سایت اول، صرف ساعت ها زمان روی Crawl Budget احتمالا اولویت مهمی نیست. اما برای سایت دوم، نحوه مصرف منابع خزش Google می تواند به یک مسئله جدی در سئو تکنیکال تبدیل شود.
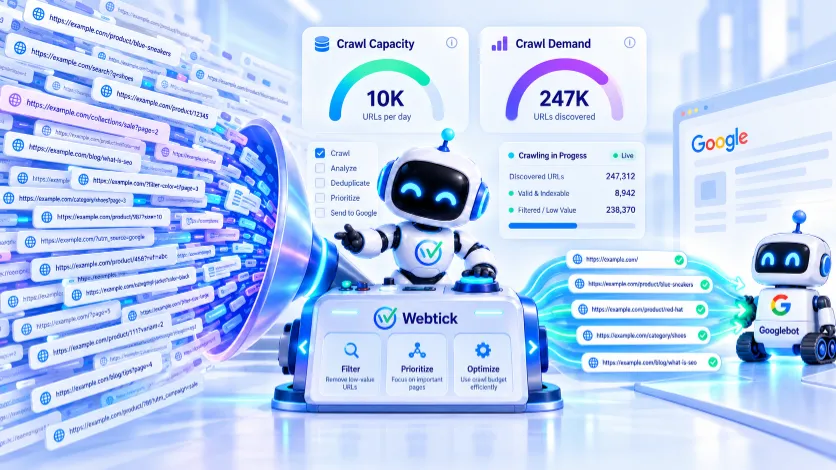
Crawl Budget یا بودجه خزش به زبان ساده، میزان منابعی است که Google می تواند و می خواهد برای Crawl کردن URLهای یک سایت صرف کند. نکته مهم این است که Crawl Budget یک سهمیه ثابت روزانه نیست که مثلا Google برای هر سایت عدد مشخصی تعیین کند. رفتار Crawl به ظرفیت سایت، تقاضای Google برای Crawl کردن محتوا و شرایط خود سایت بستگی دارد.
از طرف دیگر، Crawl شدن با Index شدن یکی نیست. ممکن است Google یک URL را Crawl کند اما در نهایت آن را وارد Index نکند. بنابراین Crawl Budget را نباید با «تعداد صفحاتی که Google روزانه ایندکس می کند» یکی دانست. مستند فعلی Google نیز Crawl Budget را بر اساس دو مفهوم اصلی Crawl Capacity Limit و Crawl Demand توضیح می دهد.
در این مقاله قرار نیست تمام روش های بهینه سازی Crawl را بررسی کنیم. هدف اصلی این است که بفهمیم Crawl Budget دقیقا چیست، چگونه شکل می گیرد، چه سایت هایی واقعا باید آن را جدی بگیرند و از کجا می توان تشخیص داد که بودجه خزش به یک مشکل واقعی تبدیل شده است.
Crawl Budget چیست؟
برای فهم Crawl Budget ابتدا باید یک تصور اشتباه را کنار بگذاریم: Google یک کیف پول مجازی به هر سایت نمی دهد که مثلا داخل آن «10 هزار Crawl در روز» قرار داشته باشد.
وب فضای بسیار بزرگی است و Google نمی تواند تمام URLهای موجود را با یک شدت و در یک زمان Crawl کند. از طرف دیگر، اگر Googlebot بدون محدودیت به یک سایت درخواست بفرستد، ممکن است فشار زیادی به سرور وارد شود. در نتیجه سیستم های Google باید تصمیم بگیرند چه مقدار از یک سایت را می توانند Crawl کنند و تا چه اندازه اصلا به Crawl کردن URLهای آن سایت نیاز دارند.
Google در مستند فعلی خود Crawl Budget را مجموعه URLهایی توصیف می کند که سیستم های آن می توانند و می خواهند Crawl کنند. این تعریف دو بخش مهم دارد:
می توانند Crawl کنند: یعنی سایت و سرور چه مقدار Crawl را بدون ایجاد مشکل می توانند تحمل کنند.
می خواهند Crawl کنند: یعنی Google چقدر تقاضا و نیاز برای Crawl یا Recrawl کردن URLهای سایت دارد.
اگر با فرایند پیدا کردن صفحات توسط Google آشنا نیستید، مفهوم خزش گوگل پایه این بحث است. Googlebot ابتدا باید URL را پیدا و Crawl کند تا محتوا بتواند وارد مراحل بعدی پردازش شود؛ اما Crawl شدن به تنهایی تضمین نمی کند که صفحه Index شود یا رتبه بگیرد.
در واقع می توان Crawl Budget را بیشتر شبیه یک سیستم تخصیص پویا برای منابع خزش دید تا یک عدد ثابت.
Google چگونه Crawl Budget را تعیین می کند؟
دو مفهوم اصلی در توضیح Google درباره بودجه خزش وجود دارد: Crawl Capacity Limit و Crawl Demand. درک تفاوت این دو کمک می کند بسیاری از توصیه های اشتباه درباره Crawl Budget را کنار بگذاریم.
Crawl Capacity Limit چیست؟
Crawl Capacity Limit یعنی Google تا چه اندازه می تواند سایت شما را Crawl کند بدون اینکه فشار نامناسبی به سرور وارد شود.
Googlebot قرار نیست سرور را با درخواست های بیش از حد از دسترس خارج کند. به همین دلیل سیستم های Google وضعیت پاسخگویی سایت را در نظر می گیرند. اگر سایت پایدار باشد و پاسخ های مناسبی بدهد، امکان Crawl بیشتری وجود دارد. اگر سایت کند شود، خطاهای سرور افزایش پیدا کنند یا Google نشانه هایی از محدودیت ظرفیت ببیند، ممکن است شدت خزش کاهش پیدا کند.
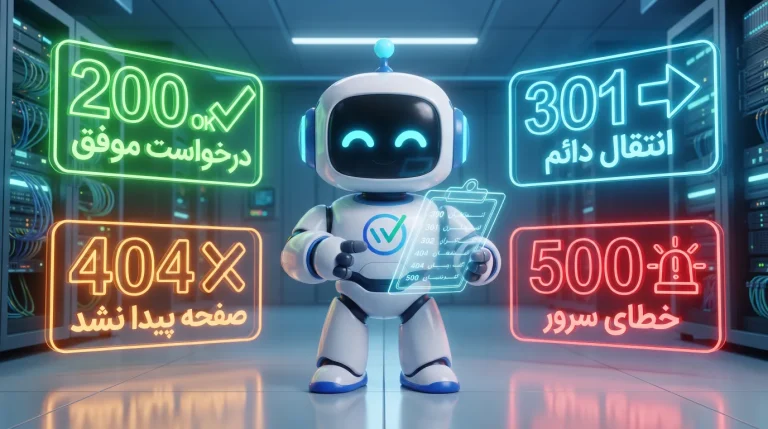
برای مثال فرض کنید یک فروشگاه بزرگ در شرایط عادی می تواند حجم زیادی از درخواست ها را پاسخ دهد. اگر در ساعات خاصی از روز سرور شروع به تولید تعداد زیادی خطای 5xx کند، ادامه Crawl با همان شدت می تواند وضعیت را بدتر کند. Google می تواند این شرایط را در تنظیم میزان Crawl در نظر بگیرد.
به همین دلیل مشکلات زیرساختی و خطاهای 5xx فقط یک موضوع مربوط به تجربه کاربر نیستند؛ در مقیاس بزرگ می توانند روی توان Google برای Crawl کردن سایت نیز اثر بگذارند.
Crawl Demand چیست؟
حتی اگر سرور شما توان پاسخگویی به تعداد بسیار زیادی درخواست را داشته باشد، معنی آن این نیست که Google حتما باید تمام ظرفیت موجود را مصرف کند.
اینجا مفهوم Crawl Demand وارد می شود.
Google بر اساس عواملی مانند اندازه سایت، میزان تغییر محتوا، کیفیت و ارتباط صفحات، URLهایی که از سایت می شناسد و نیاز به تازه نگه داشتن اطلاعات مشخص می کند چه مقدار تقاضا برای Crawl وجود دارد.
برای مثال یک صفحه خبری که مرتب تغییر می کند ممکن است نیاز بیشتری به Recrawl داشته باشد. در مقابل، صفحه ای قدیمی که مدت ها تغییری نکرده است لزوما به همان دفعات Crawl نیاز ندارد.
همچنین اگر Google تعداد بسیار زیادی URL تکراری، کم اهمیت یا غیرضروری از سایت شناسایی کرده باشد، بخشی از منابع Crawl ممکن است صرف URLهایی شود که شما ترجیح می دهید اولویت پایین تری داشته باشند.
ترکیب Crawl Capacity و Crawl Demand تعیین می کند Google در عمل چه مقدار و کدام بخش های سایت را Crawl کند.
آیا Crawl Budget برای همه سایت ها مهم است؟
نه.
Crawl Budget مفهومی واقعی است، اما این به معنی آن نیست که تمام سایت ها باید یک پروژه مستقل برای «افزایش بودجه خزش» داشته باشند.
Google راهنمای فعلی Crawl Budget را یک راهنمای پیشرفته برای سایت های بسیار بزرگ یا سایت هایی با تغییرات سریع معرفی می کند. حتی به صراحت اشاره می کند که اگر سایت تعداد بسیار زیادی صفحه با تغییرات سریع ندارد، یا صفحات جدید آن در همان روز انتشار Crawl می شوند، معمولا نیازی نیست تمرکز اصلی روی Crawl Budget باشد.
یک وبلاگ با چند صد مقاله، یک سایت خدماتی با ده ها صفحه یا حتی بسیاری از فروشگاه های کوچک ممکن است مشکلات فنی مربوط به Crawling داشته باشند، اما هر مشکل Crawl را نباید به Crawl Budget نسبت داد.
برای مثال اگر یک صفحه مهم هیچ لینک داخلی ندارد و در Sitemap هم وجود ندارد، مشکل اصلی احتمالا Discovery است. اگر Googlebot به دلیل robots.txt نمی تواند به صفحه دسترسی پیدا کند، با یک مسئله کنترل Crawl روبرو هستیم. اگر صفحه Crawl شده اما وارد Index نشده، باید موضوع را از زاویه قابلیت ایندکس و کیفیت و وضعیت صفحه نیز بررسی کرد.
استفاده از عبارت Crawl Budget برای تمام این مشکلات فقط تشخیص را سخت تر می کند.
اگر صفحات مهم سایت در زمان معقول پیدا و Crawl می شوند، معمولا Crawl Budget اولین چیزی نیست که باید برای بهبود سئو سراغ آن بروید.
چه سایت هایی باید Crawl Budget را جدی بگیرند؟
Google برای توضیح مخاطبان راهنمای Crawl Budget چند نمونه ارائه کرده است. این اعداد قانون قطعی نیستند، بلکه تخمین هایی برای تشخیص مقیاس مسئله هستند.
| نوع سایت | شرایطی که Crawl Budget مهم تر می شود |
|---|---|
| سایت بسیار بزرگ | حدود یک میلیون URL یا بیشتر که محتوا به شکل نسبتا منظم تغییر می کند |
| سایت متوسط یا بزرگ و بسیار پویا | حدود 10 هزار URL یا بیشتر که بخش مهمی از آن روزانه تغییر می کند |
| سایت دارای مشکل Discovery گسترده | بخش قابل توجهی از URLها در Search Console با وضعیت Discovered - currently not indexed دیده می شوند |
| فروشگاه بزرگ | فیلترها، پارامترها، دسته بندی ها و URLهای محصول می توانند فضای URL بسیار بزرگی ایجاد کنند |
| سایت خبری یا محتوای بسیار پویا | سرعت Discovery و Recrawl محتوای جدید یا تغییر یافته اهمیت بیشتری دارد |
خود Google تاکید می کند اعداد یک میلیون و 10 هزار URL مرز دقیق نیستند. دو سایت با تعداد URL مشابه ممکن است شرایط کاملا متفاوتی داشته باشند.
برای مثال فروشگاهی با 20 هزار URL تمیز و کنترل شده ممکن است مشکل خاصی نداشته باشد، اما فروشگاه دیگری با 20 هزار محصول بتواند از طریق فیلترها و پارامترهای ترکیبی صدها هزار URL قابل Crawl تولید کند.
بنابراین فقط تعداد صفحات منتشر شده را نشمارید. تعداد URLهایی که Google می تواند کشف کند اهمیت بیشتری دارد.
از کجا بفهمیم Crawl Budget برای سایت ما مشکل شده است؟
هیچ شاخص منفردی وجود ندارد که با دیدن آن بتوان گفت «Crawl Budget سایت تمام شده است». باید چند نشانه را کنار هم بررسی کرد.
مهم ترین مواردی که ارزش بررسی دارند عبارتند از:
- صفحات مهم جدید یا به روز شده به شکل غیرعادی دیر Crawl می شوند.
- تعداد زیادی URL مهم برای مدت طولانی در وضعیت
Discovered - currently not indexedباقی مانده اند. - Crawl Stats نشان می دهد Google حجم زیادی از درخواست ها را صرف URLهای غیرضروری می کند.
- لاگ سرور نشان می دهد Googlebot بارها URLهای فیلتر، پارامتر، صفحات تکراری یا مسیرهای کم ارزش را Crawl می کند.
- خطاهای سرور، Timeout یا محدودیت ظرفیت در زمان Crawl دیده می شود.
- ساختار سایت تعداد بسیار زیادی URL ایجاد می کند که ارزش مستقل برای Search ندارند.
- تغییرات مهم صفحات با تاخیر طولانی توسط Google دوباره Crawl می شوند.
این نشانه ها باید در کنار یکدیگر تفسیر شوند. مثلا وجود تعدادی URL با وضعیت Discovered - currently not indexed به تنهایی اثبات نمی کند که سایت مشکل Crawl Budget دارد.
برای شروع می توان از Crawl Stats و Page Indexing در Search Console استفاده کرد. اما برای سایت های بزرگ، تحلیل Server Log تصویر دقیق تری می دهد؛ چون می توان مشاهده کرد Googlebot دقیقا کدام URLها را درخواست کرده است.
Search Console برای تشخیص کلی بسیار مفید است، اما نباید از آن انتظار داشت که تمام جزئیات تاریخچه Crawl تک تک URLها را مانند Server Log ارائه کند.
چه چیزهایی می توانند Crawl Budget را هدر دهند؟
اگر Google هزاران یا میلیون ها URL از سایت شما بشناسد، کیفیت مدیریت URL Inventory اهمیت زیادی پیدا می کند. مسئله اصلی این نیست که «Google زیاد Crawl می کند»، بلکه این است که Google وقت خود را روی چه URLهایی صرف می کند.
یکی از نمونه های رایج، Faceted Navigation در فروشگاه های اینترنتی است. فرض کنید یک دسته بندی کفش دارید و کاربر می تواند محصولات را بر اساس برند، سایز، رنگ، قیمت، جنس و ترتیب نمایش فیلتر کند. اگر هر ترکیب یک URL مستقل ایجاد کند، تعداد URLها می تواند خیلی سریع رشد کند.
ممکن است بسیاری از این URLها محتوای تقریبا مشابهی داشته باشند و ارزش مستقلی برای Search ایجاد نکنند. اگر Google تمام این ترکیب ها را کشف کند، فضای خزش سایت بسیار بزرگ تر از تعداد واقعی صفحات مهم خواهد شد.
URLهای تکراری و پارامتری
وجود چند URL برای محتوای یکسان یا بسیار مشابه می تواند Crawl را پیچیده تر کند. Canonicalization، معماری URL و کنترل پارامترها در چنین سایت هایی اهمیت بیشتری پیدا می کند.
هدف این نیست که Google فقط یک URL از کل سایت را Crawl کند؛ هدف این است که سیستم بتواند روی نسخه های اصلی و مفید محتوا تمرکز بیشتری داشته باشد.
Soft 404
Soft 404 زمانی رخ می دهد که صفحه از نظر محتوا عملا وجود ندارد یا محتوای معناداری ارائه نمی کند، اما سرور به جای وضعیت مناسب مانند 404، پاسخ موفق 200 برمی گرداند.
Google در مستند Crawl Budget توصیه می کند Soft 404ها برطرف شوند، زیرا چنین URLهایی ممکن است همچنان Crawl شوند.
این موضوع را نباید با یک 404 معمولی اشتباه گرفت. Google در مستند «باورها و واقعیت های Crawling» توضیح می دهد که پاسخ های 4xx، به جز 429، ذاتا به معنی هدر رفت Crawl Budget نیستند. بنابراین تبدیل تمام 404ها به Redirect فقط با هدف «حفظ Crawl Budget» تصمیم درستی نیست.
زنجیره های طولانی Redirect
فرض کنید URL شماره یک به URL شماره دو Redirect شود، شماره دو به شماره سه و در نهایت شماره سه به مقصد اصلی برسد.
این ساختار به جای هدایت مستقیم Googlebot و کاربر به مقصد، چند درخواست پشت سر هم ایجاد می کند. Google توصیه می کند از زنجیره های طولانی Redirect جلوگیری شود.
اگر می خواهید انواع Redirect و کاربرد هر کدام را عمیق تر بررسی کنید، مقاله ریدایرکت چیست این موضوع را جداگانه پوشش می دهد.
Infinite Spaces
یکی از مشکلات جدی در سایت های بزرگ، ایجاد فضایی تقریبا نامحدود از URLها است. تقویم هایی که امکان رفتن به سال های بسیار دور دارند، ترکیب بی پایان پارامترها یا سیستم هایی که URLهای جدید را بدون محتوای مستقل تولید می کنند می توانند چنین شرایطی ایجاد کنند.
در این حالت خزنده ممکن است وارد مسیری شود که انتهای مشخصی ندارد.
پاسخ کند سرور و خطاهای 5xx
سرور ضعیف مستقیما به این معنی نیست که Google سایت را دوست ندارد؛ مسئله ظرفیت است.
اگر پاسخ ها بسیار کند شوند، Timeout رخ دهد یا خطاهای 5xx افزایش پیدا کنند، Google ممکن است Crawl را کاهش دهد تا فشار بیشتری به سایت وارد نشود.
به همین دلیل هنگام بررسی Crawl Budget باید وضعیت زیرساخت و Host Availability را نیز در نظر گرفت، نه اینکه تمام مشکل را با تغییر Sitemap یا Internal Link حل شده فرض کنیم.
نقش robots.txt در Crawl Budget چیست؟
فایل robots.txt می تواند مشخص کند Googlebot اجازه درخواست کدام مسیرها را دارد. بنابراین در سایت های بزرگ، جلوگیری از Crawl شدن بخش هایی که واقعا نباید توسط Google Crawl شوند می تواند بخشی از مدیریت URL Inventory باشد.
اما robots.txt ابزار بازی با بودجه خزش نیست.
مثلا منطقی نیست امروز یک بخش را Block کنیم تا تصور کنیم Crawl Budget به بخش دیگری منتقل می شود و فردا دوباره آن را باز کنیم. Google نیز توصیه می کند از robots.txt برای مسدود کردن بلندمدت صفحاتی استفاده شود که واقعا نمی خواهید Crawl شوند، نه برای جابه جایی موقت Crawl Budget.
قواعد و محدودیت های این فایل جزئیات مهمی دارند که در مقاله robots.txt چیست جداگانه بررسی شده اند.
Sitemap چه نقشی در مدیریت Crawl دارد؟
Sitemap تضمین نمی کند Google تمام URLهای داخل آن را Crawl یا Index کند، اما به Google کمک می کند URLهای مهم و تغییرات آن ها را بهتر کشف کند.
در سایت های بزرگ بهتر است Sitemap به جای تبدیل شدن به فهرستی از هر URL قابل تولید، نماینده URLهایی باشد که واقعا می خواهید Google آن ها را پردازش کند.
همچنین اگر محتوایی به روز شده است، استفاده درست از lastmod می تواند اطلاعات مفیدی درباره زمان تغییر ارائه کند. Google در راهنمای فعلی Crawl Budget نیز بر به روز نگه داشتن Sitemap تاکید دارد.
جزئیات ساخت و مدیریت نقشه سایت موضوع مستقلی است؛ در بحث Crawl Budget مهم است بدانیم Sitemap یک سیگنال کمکی برای Discovery و Recrawl است، نه دکمه ای برای افزایش مستقیم بودجه خزش.
Crawl Budget چه تاثیری بر SEO دارد؟
Crawl برای حضور یک صفحه در نتایج Google اهمیت دارد، اما Crawling یک Ranking Signal نیست.
این تفاوت بسیار مهم است.
اگر Google صفحه ای را Crawl نکند، طبیعتا نمی تواند محتوای جدید آن را به شکل معمول پردازش کند. بنابراین در سایتی که صفحات مهم به دلیل ناکارآمدی گسترده Crawl دیر کشف می شوند، Crawl Budget می تواند به صورت غیرمستقیم روی عملکرد سئو اثر بگذارد.
اما افزایش تعداد درخواست های Googlebot به خودی خود باعث افزایش رتبه نمی شود.
Google به صراحت توضیح می دهد که افزایش Crawl Rate الزاما به جایگاه بهتر در نتایج Search منجر نمی شود. Crawl شدن برای حضور در نتایج ضروری است، اما خود تعداد Crawlها سیگنال رتبه بندی نیست.
بنابراین هدف متخصص سئو نباید این باشد که نمودار Crawl Requests را به هر قیمتی بالا ببرد.
سوال بهتر این است:
آیا Google صفحات مهم سایت را با سرعت و کارایی مناسبی Crawl می کند؟
اگر پاسخ مثبت باشد، افزایش مصنوعی Crawl Activity ارزش خاصی ایجاد نمی کند.
چند باور اشتباه درباره بودجه خزش
«هرچه Googlebot بیشتر سایت را Crawl کند، رتبه بهتر می شود»
خیر.
Crawl Activity بیشتر به معنی Ranking بهتر نیست. اگر Googlebot هزاران URL فیلتر و تکراری را بیشتر Crawl کند، حتی ممکن است عدد Crawl Requests بالا برود بدون اینکه ارزش خاصی برای صفحات اصلی ایجاد شود.
هدف، Crawl بیشتر نیست؛ Crawl کارآمدتر صفحات مهم است.
«هر صفحه 404 بودجه خزش را هدر می دهد»
این ادعا بیش از حد ساده است.
Google صراحتا می گوید URLهایی که پاسخ 4xx می دهند، به جز 429، به عنوان هدر رفت Crawl Budget در نظر گرفته نمی شوند. از طرف دیگر، Soft 404 مسئله متفاوتی است و می تواند باعث ادامه پردازش URLهای بی فایده شود.
«برای صرفه جویی در Crawl Budget از noindex استفاده کنیم»
این هم راه حل دقیقی نیست.
برای دیدن دستور noindex، Google ابتدا باید URL را Crawl کند و پاسخ صفحه را دریافت کند. بنابراین noindex اساسا دستور Indexing است، نه ابزاری برای جلوگیری از Crawl.
اگر واقعا نمی خواهید Googlebot یک بخش مشخص را Crawl کند، بسته به شرایط باید ابزار مناسب مدیریت Crawl را انتخاب کرد. این تصمیم را نباید فقط بر اساس یک توصیه عمومی انجام داد.
«فقط سایت های میلیونی Crawl Budget دارند»
همه سایت ها در عمل با محدودیت ها و اولویت بندی Crawl روبرو هستند، اما این به معنی مهم بودن Crawl Budget برای همه آن ها نیست.
ممکن است سایتی 50 هزار URL داشته باشد و هیچ مشکل عملی از نظر Crawl نداشته باشد. ممکن است سایت دیگری تعداد URL کمتری داشته باشد اما به دلیل تولید گسترده URLهای پارامتری یا مشکلات سرور، نیازمند بررسی جدی تر باشد.
اعداد Google برای تشخیص مقیاس هستند، نه مرز فنی مطلق.
اگر Crawl Budget واقعا مشکل باشد، از کجا شروع کنیم؟
اولین واکنش نباید نصب یک افزونه یا مسدود کردن گسترده URLها در robots.txt باشد.
ابتدا باید بفهمید Google در حال حاضر چگونه سایت را Crawl می کند.
برای یک سایت بزرگ، روند بررسی می تواند از Crawl Stats و Page Indexing در Search Console شروع شود. سپس Server Log مشخص می کند Googlebot در عمل روی چه URLهایی وقت می گذارد. در ادامه باید URL Inventory را با صفحات واقعی و ارزشمند سایت مقایسه کرد.
اگر Googlebot بخش بزرگی از Crawl خود را روی URLهای فیلتر، پارامترهای بی فایده، صفحات تکراری، Soft 404 یا Redirect Chainها صرف می کند، مشکل با «گرفتن Crawl Budget بیشتر» شروع نمی شود؛ ابتدا باید فضای URL را تمیزتر و قابل کنترل تر کرد.
از طرف دیگر، اگر Server Response کند است یا تعداد زیادی خطای 5xx دیده می شود، ممکن است اولویت اصلی زیرساخت باشد.
اگر صفحات مهم در Sitemap هستند اما از معماری سایت به سختی قابل کشف اند، باید Internal Linking و ساختار سایت بررسی شود.
به همین دلیل Crawl Budget بیشتر از آنکه یک تنظیم مستقل باشد، نتیجه تعامل چند بخش از سئو تکنیکال است.
مثال کامل: فروشگاهی با هزاران URL فیلترشده
فرض کنیم یک فروشگاه اینترنتی بزرگ لوازم دیجیتال داریم.
فروشگاه 40 هزار صفحه محصول و دسته بندی ارزشمند دارد. در نگاه اول شاید تصور کنیم Google فقط با همین 40 هزار URL روبرو است. اما سیستم فیلتر سایت برای هر ترکیب برند، قیمت، رنگ، موجودی، ترتیب نمایش و چند ویژگی دیگر URL جداگانه ایجاد می کند.
بعد از مدتی Google صدها هزار URL مختلف می شناسد.
بررسی Server Log نشان می دهد Googlebot زمان قابل توجهی را صرف URLهایی مانند این موارد می کند:
/laptop?brand=x&sort=price
/laptop?brand=x&sort=newest
/laptop?brand=x&color=black&sort=price
/laptop?brand=x&color=black&stock=yes&sort=price
بخش بزرگی از این صفحات تفاوت محتوایی مهمی ندارند.
در همان زمان بعضی محصولات جدید فروشگاه چند روز منتظر Crawl می مانند. تعداد زیادی URL نیز در Search Console با وضعیت Discovered - currently not indexed دیده می شوند.
در این شرایط، بررسی Crawl Budget منطقی است.
اما راه حل این نیست که صرفا به دنبال «افزایش عدد بودجه خزش» باشیم. ابتدا باید مشخص کنیم کدام ترکیب های فیلتر واقعا Landing Page مفید و دارای تقاضای جستجو هستند و کدام URLها فقط محصول جانبی سیستم فیلتر سایت محسوب می شوند.
URLهای تکراری باید تا جای ممکن Consolidate شوند. مسیرهایی که واقعا نیازی به Crawl ندارند باید با ابزار مناسب مدیریت شوند. Soft 404ها باید اصلاح شوند. Redirect Chainها باید کاهش پیدا کنند. Sitemap باید URLهای مهم را نشان دهد و وضعیت سرور نیز باید پایدار باشد.
پس از این اصلاحات، فضای Crawling سایت به جای هزاران مسیر کم ارزش، بهتر حول URLهایی شکل می گیرد که برای کاربر و Search اهمیت بیشتری دارند.
این همان نقطه ای است که مدیریت Crawl Budget ارزش واقعی پیدا می کند: نه افزایش کورکورانه تعداد Crawl، بلکه کاهش اتلاف منابع روی URLهای غیرضروری و کمک به Crawl موثرتر محتوای مهم.
جمع بندی: آیا شما باید نگران Crawl Budget باشید؟
Crawl Budget مسئله ای واقعی در Crawling است، اما برای اکثر سایت های کوچک نباید به یک دغدغه دائمی تبدیل شود.
اگر چند صد یا چند هزار URL دارید، صفحات مهم شما در زمان منطقی Crawl می شوند، سرور سالم است و Googlebot در انبوهی از URLهای غیرضروری گرفتار نشده است، احتمالا پروژه های مهم تری در سئو دارید که باید قبل از Crawl Budget روی آن ها کار کنید.
اما اگر سایت بزرگی دارید، URLها به سرعت تغییر می کنند، سیستم سایت تعداد بسیار زیادی URL ایجاد می کند، صفحات مهم دیر Crawl می شوند یا حجم قابل توجهی از صفحات در وضعیت Discovered - currently not indexed قرار گرفته اند، بررسی Crawl Budget می تواند کاملا منطقی باشد.
مهم ترین نکته این است که Crawl Budget را با Indexing یا Ranking اشتباه نگیریم. هدف این نیست که Googlebot را وادار کنیم درخواست های بیشتری به سایت بفرستد؛ هدف این است که ساختار فنی سایت به Google اجازه دهد منابع Crawl را روی URLهای درست مصرف کند.
اگر بخواهیم یک قانون تصمیم ساده داشته باشیم، این است:
تا زمانی که Google صفحات مهم سایت را به موقع و بدون مشکل Crawl می کند، Crawl Budget احتمالا اولویت اصلی شما نیست. وقتی URL Inventory بزرگ و پیچیده می شود و Crawl صفحات مهم عقب می افتد، وقت آن است که موضوع را جدی تر بررسی کنید.

اولین دیدگاه را بنویسید